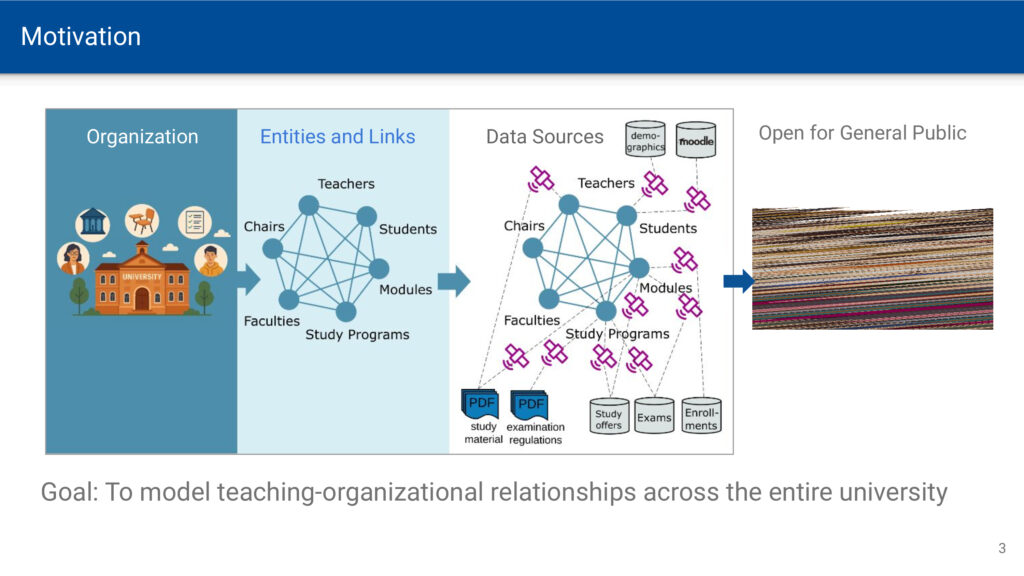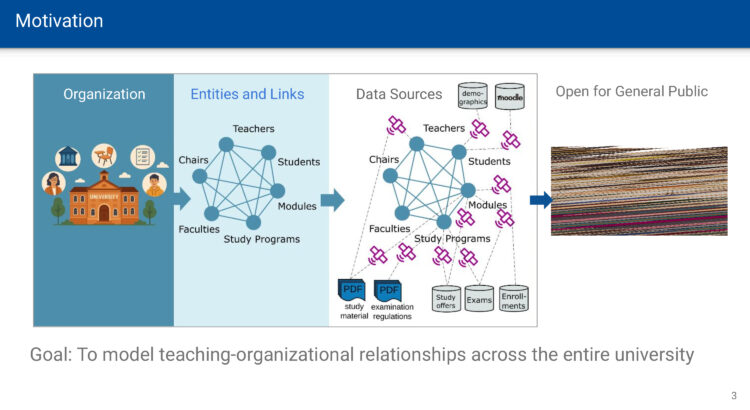
Hochschulen organisieren Lehre und Lernen nicht nur physisch, sondern auch digital. Die Bestandteile der Organisation wie Fakultäten, Studiengänge und Module sind digital abgebildet und werden auf Webseiten, in Modulhandbüchern und in Prüfungsordnungen für Menschen sichtbar und nutzbar. Für datenverarbeitende Maschinen sind diese Informationen jedoch unstrukturiert und deshalb schwer miteinander in Beziehung zu setzen. Wie gut Computerprogramme auf Informationen zugreifen können, nennt man Maschinenlesbarkeit. Eine Maschine kann die Zusammenhänge einer Hochschule nur dann richtig lesen, wenn die einzelnen Bestandteile und ihre Beziehungen zueinander eindeutig beschrieben sind. Zum Beispiel muss klar erkennbar sein, welche Module ein Studiengang anbietet und welche Kombinationen von Modulen für einen Abschluss nötig sind. Auf Basis unstrukturierter Daten können Maschinen eine Organisation also nicht „verstehen“, und Nutzer:innen können sich mithilfe von Software keine Fragen zur Organisation beantworten lassen.
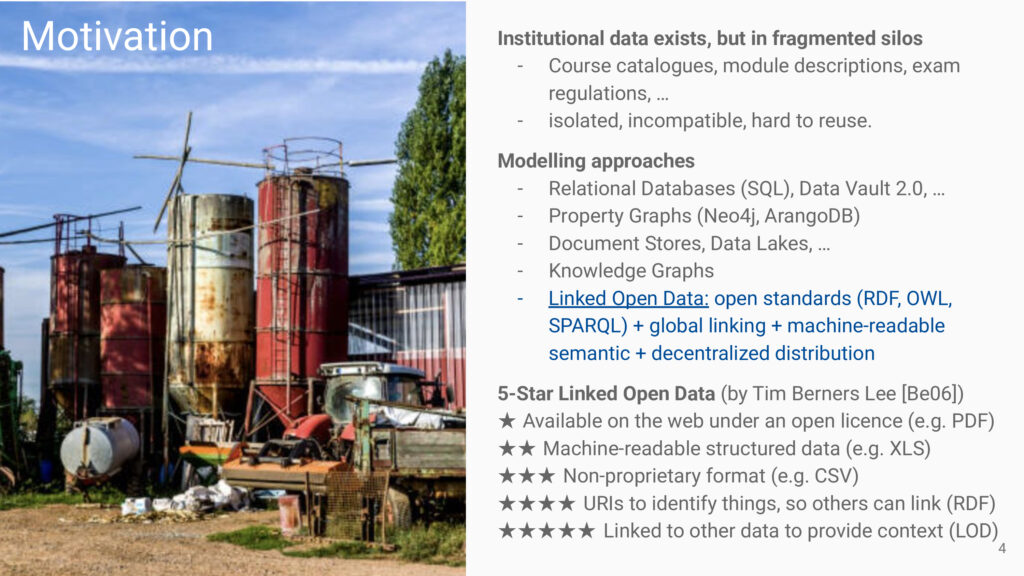
Oft kennt nicht einmal die Hochschule selbst das ganze Bild. Die Informationen verteilen sich auf PDF-Dokumente, Campus-Management-Systeme, Fakultätsseiten und das Wissen einzelner Mitarbeitender. Das ist erstaunlich, denn seit den 2000er-Jahren veröffentlichen Behörden immer mehr offene Daten, also Daten, die alle frei nutzen, weitergeben und wiederverwenden dürfen. Auch Hochschulen setzen sich für Open Access und offene Forschungsdaten ein. Daten darüber, wie die Hochschule selbst aufgebaut ist, sind dagegen kaum offen verfügbar.
Unser Lösungsansatz
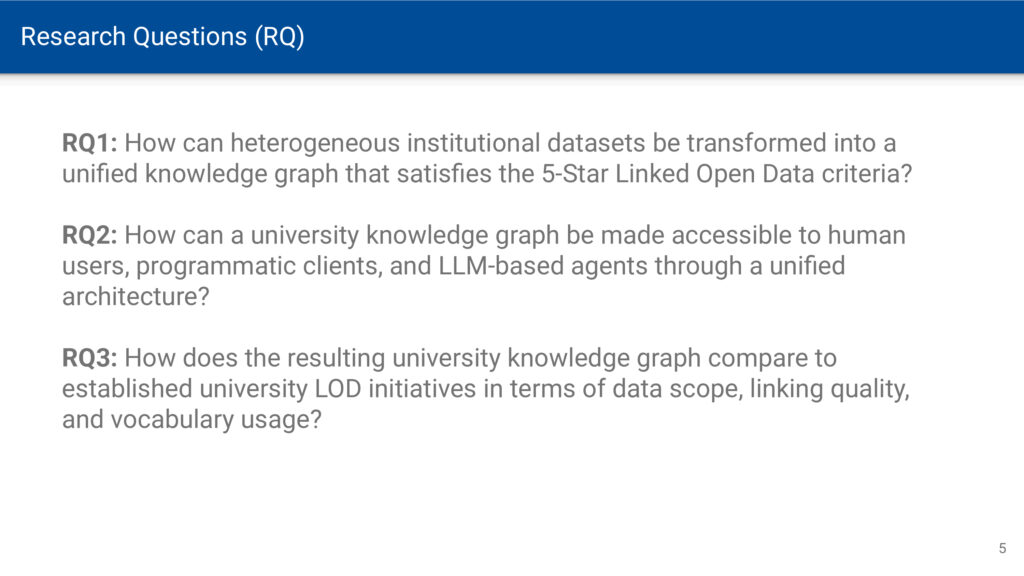
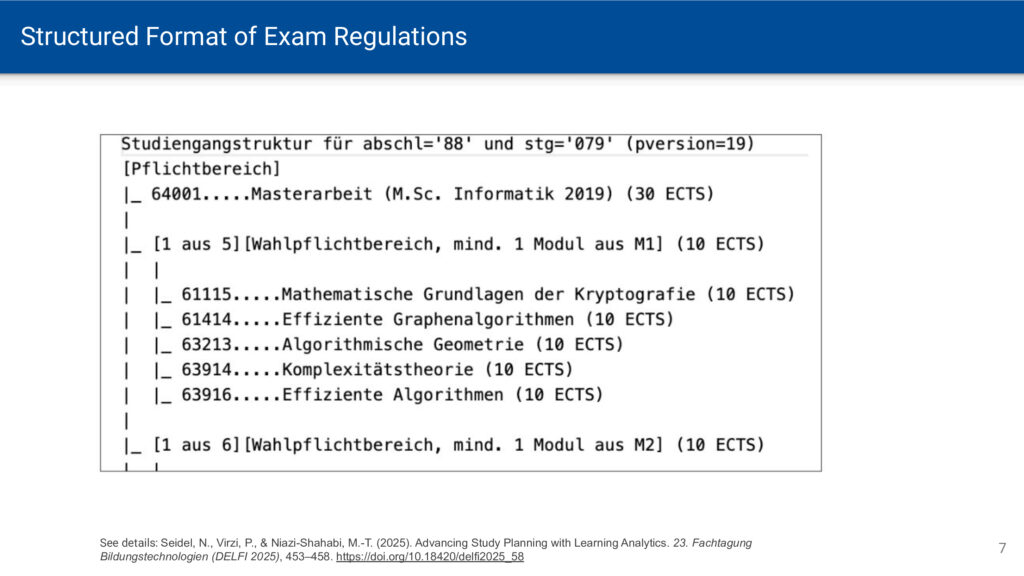
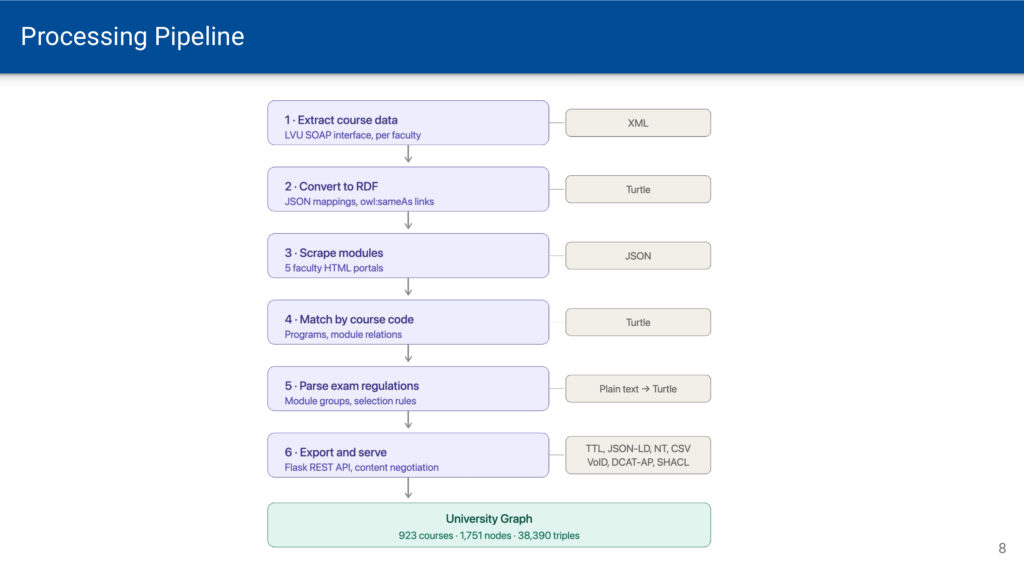
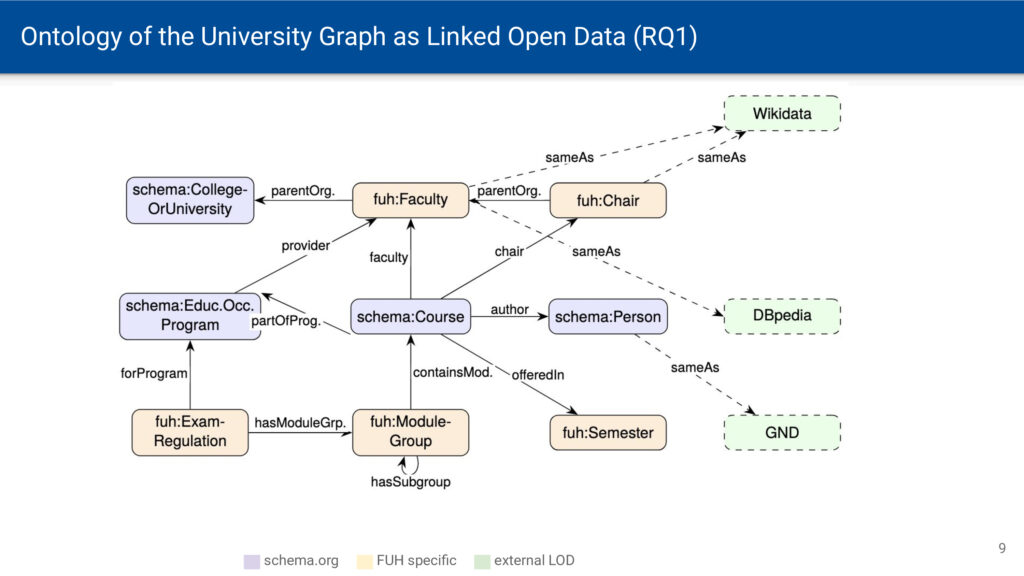
In unserem neuen Paper untersuchen wir, welche Daten in den Informationssystemen der FernUniversität in Hagen vorhanden sind, welche davon für Menschen außerhalb der Hochschule nützlich sind und wie man sie zugänglich machen kann. Dazu haben wir das Vorlesungsverzeichnis über mehrere Semester hinweg aufbereitet, mit Fakultäten, Studiengängen und Prüfungsordnungen. Die Daten liegen jetzt als sogenannte Linked Open Data vor. In der Fachsprache bezeichnet man diese Datenstruktur auch als Graph bzw. Wissensgraph. Das bedeutet: Jeder Bestandteil, etwa ein Modul oder ein Studiengang, bekommt eine eindeutige Adresse im Web, und die Beziehungen zwischen den Bestandteilen sind ausdrücklich beschrieben. Außerdem sind die Daten mit anderen Quellen im Web verknüpft.
Drei Zugänge zu denselben Daten
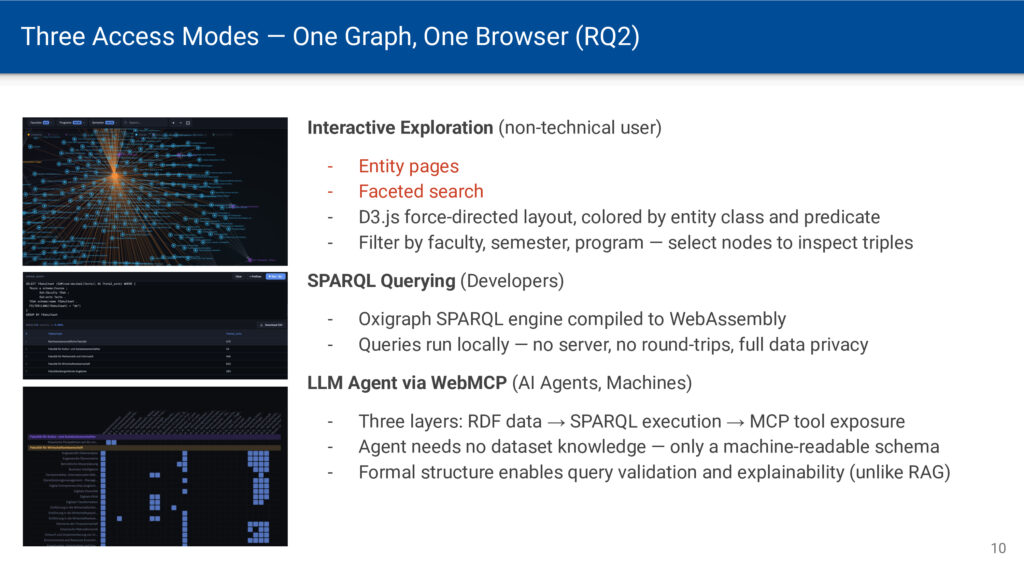
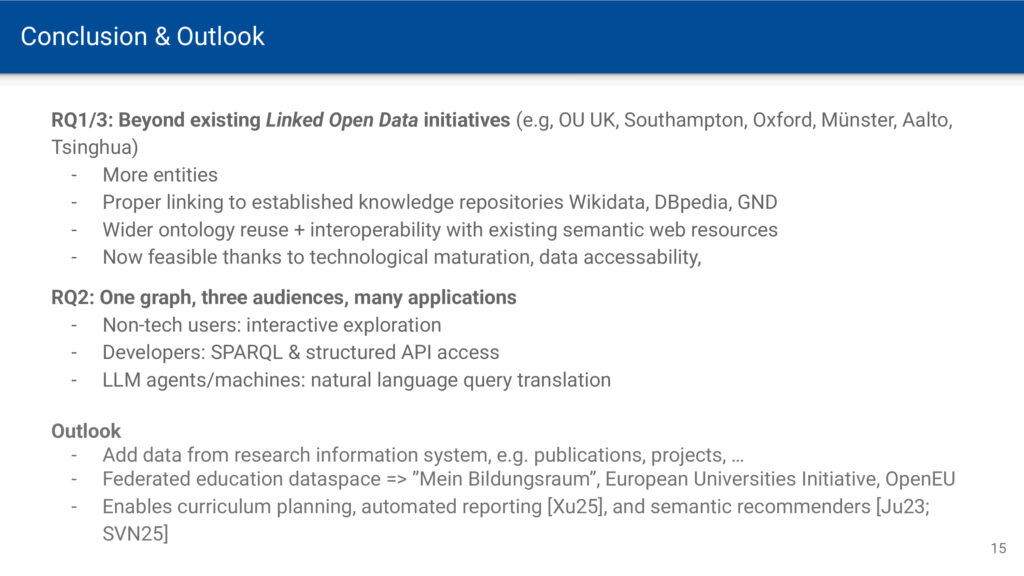
Die Software, die wir veröffentlicht haben, bietet drei Wege zu den Daten. Menschen können die Zusammenhänge in einer visuellen Oberfläche erkunden und sich durch Fakultäten, Studiengänge und Module klicken. Computerprogramme können die Daten über eine SPARQL-Schnittstelle abfragen, eine Standardsprache für solche vernetzten Daten. Und KI-Agenten können über eine WebMCP-Schnittstelle direkt auf die Daten zugreifen, zum Beispiel um Fragen von Studierenden zu beantworten. Fragen, für die man bisher mühsam Dokumente durchsuchen musste, lassen sich so in Sekunden beantworten.
Wie gut funktioniert das?
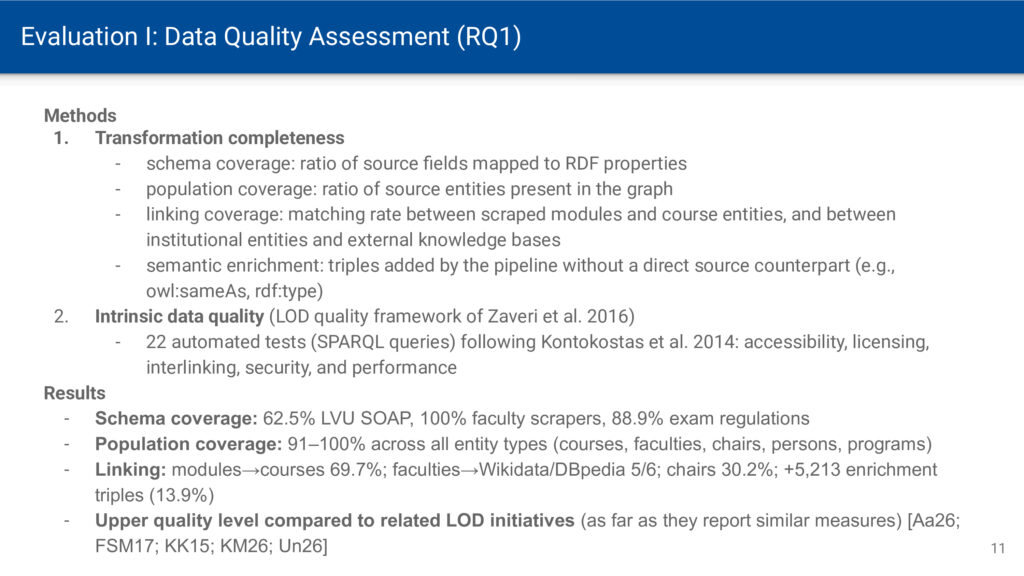
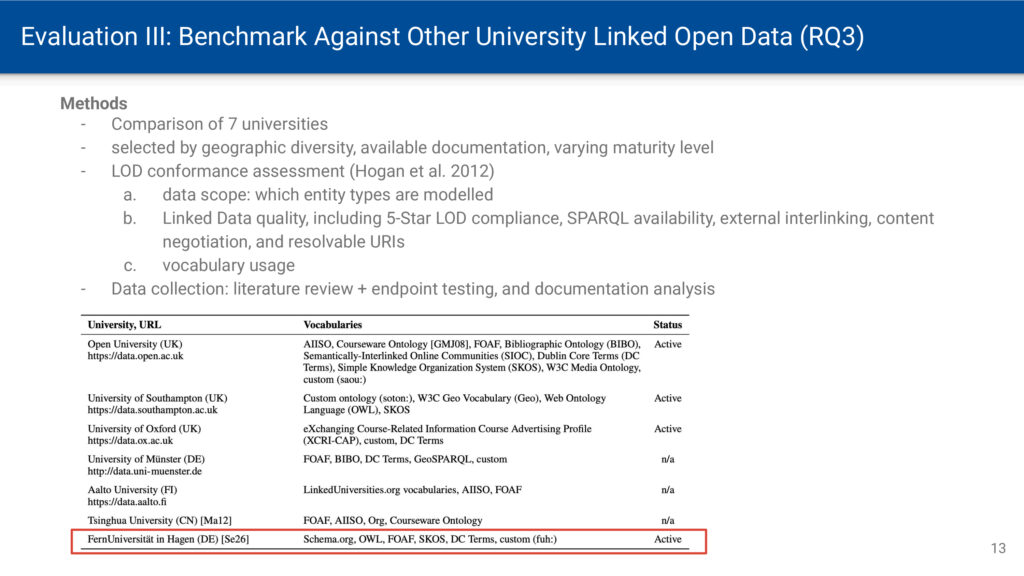
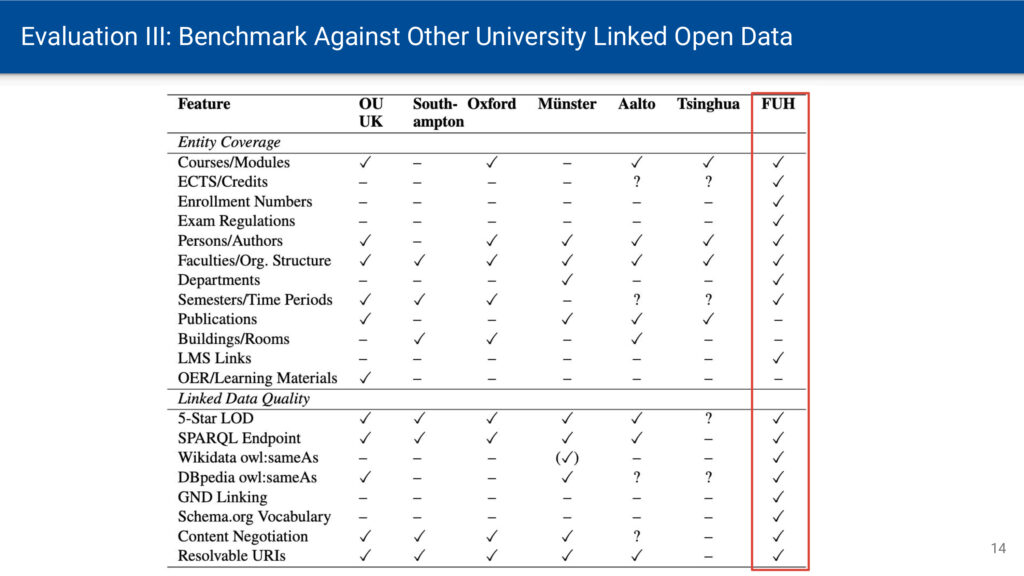
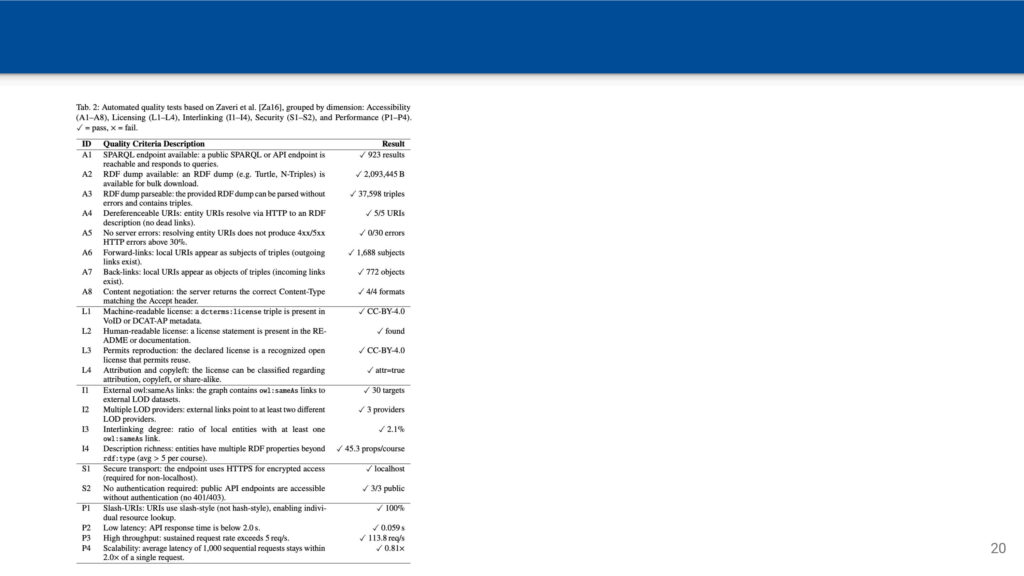
Wir haben die Qualität der Daten geprüft und unseren Ansatz mit sechs etablierten offenen Datenangeboten anderer Hochschulen verglichen. Das Ergebnis zeigt, wie viel ungenutztes Potenzial in offenen Hochschuldaten steckt. Unsere Arbeit soll eine Grundlage dafür sein, dass mehr Hochschulen ihre Strukturen offen und maschinenlesbar bereitstellen.
Vorgestellt haben ich die Arbeit im Best-Paper-Track der DELFI 2026 an der Universität Potsdam. Das Paper und die Software finden Sie hier:
Paper: https://dl.gi.de/handle/20.500.12116/49137
Software-Paper: https://dl.gi.de/handle/20.500.12116/49162
Um die Vortragsfolien zu betrachten, genügt ein Klick auf eines der Bilder.