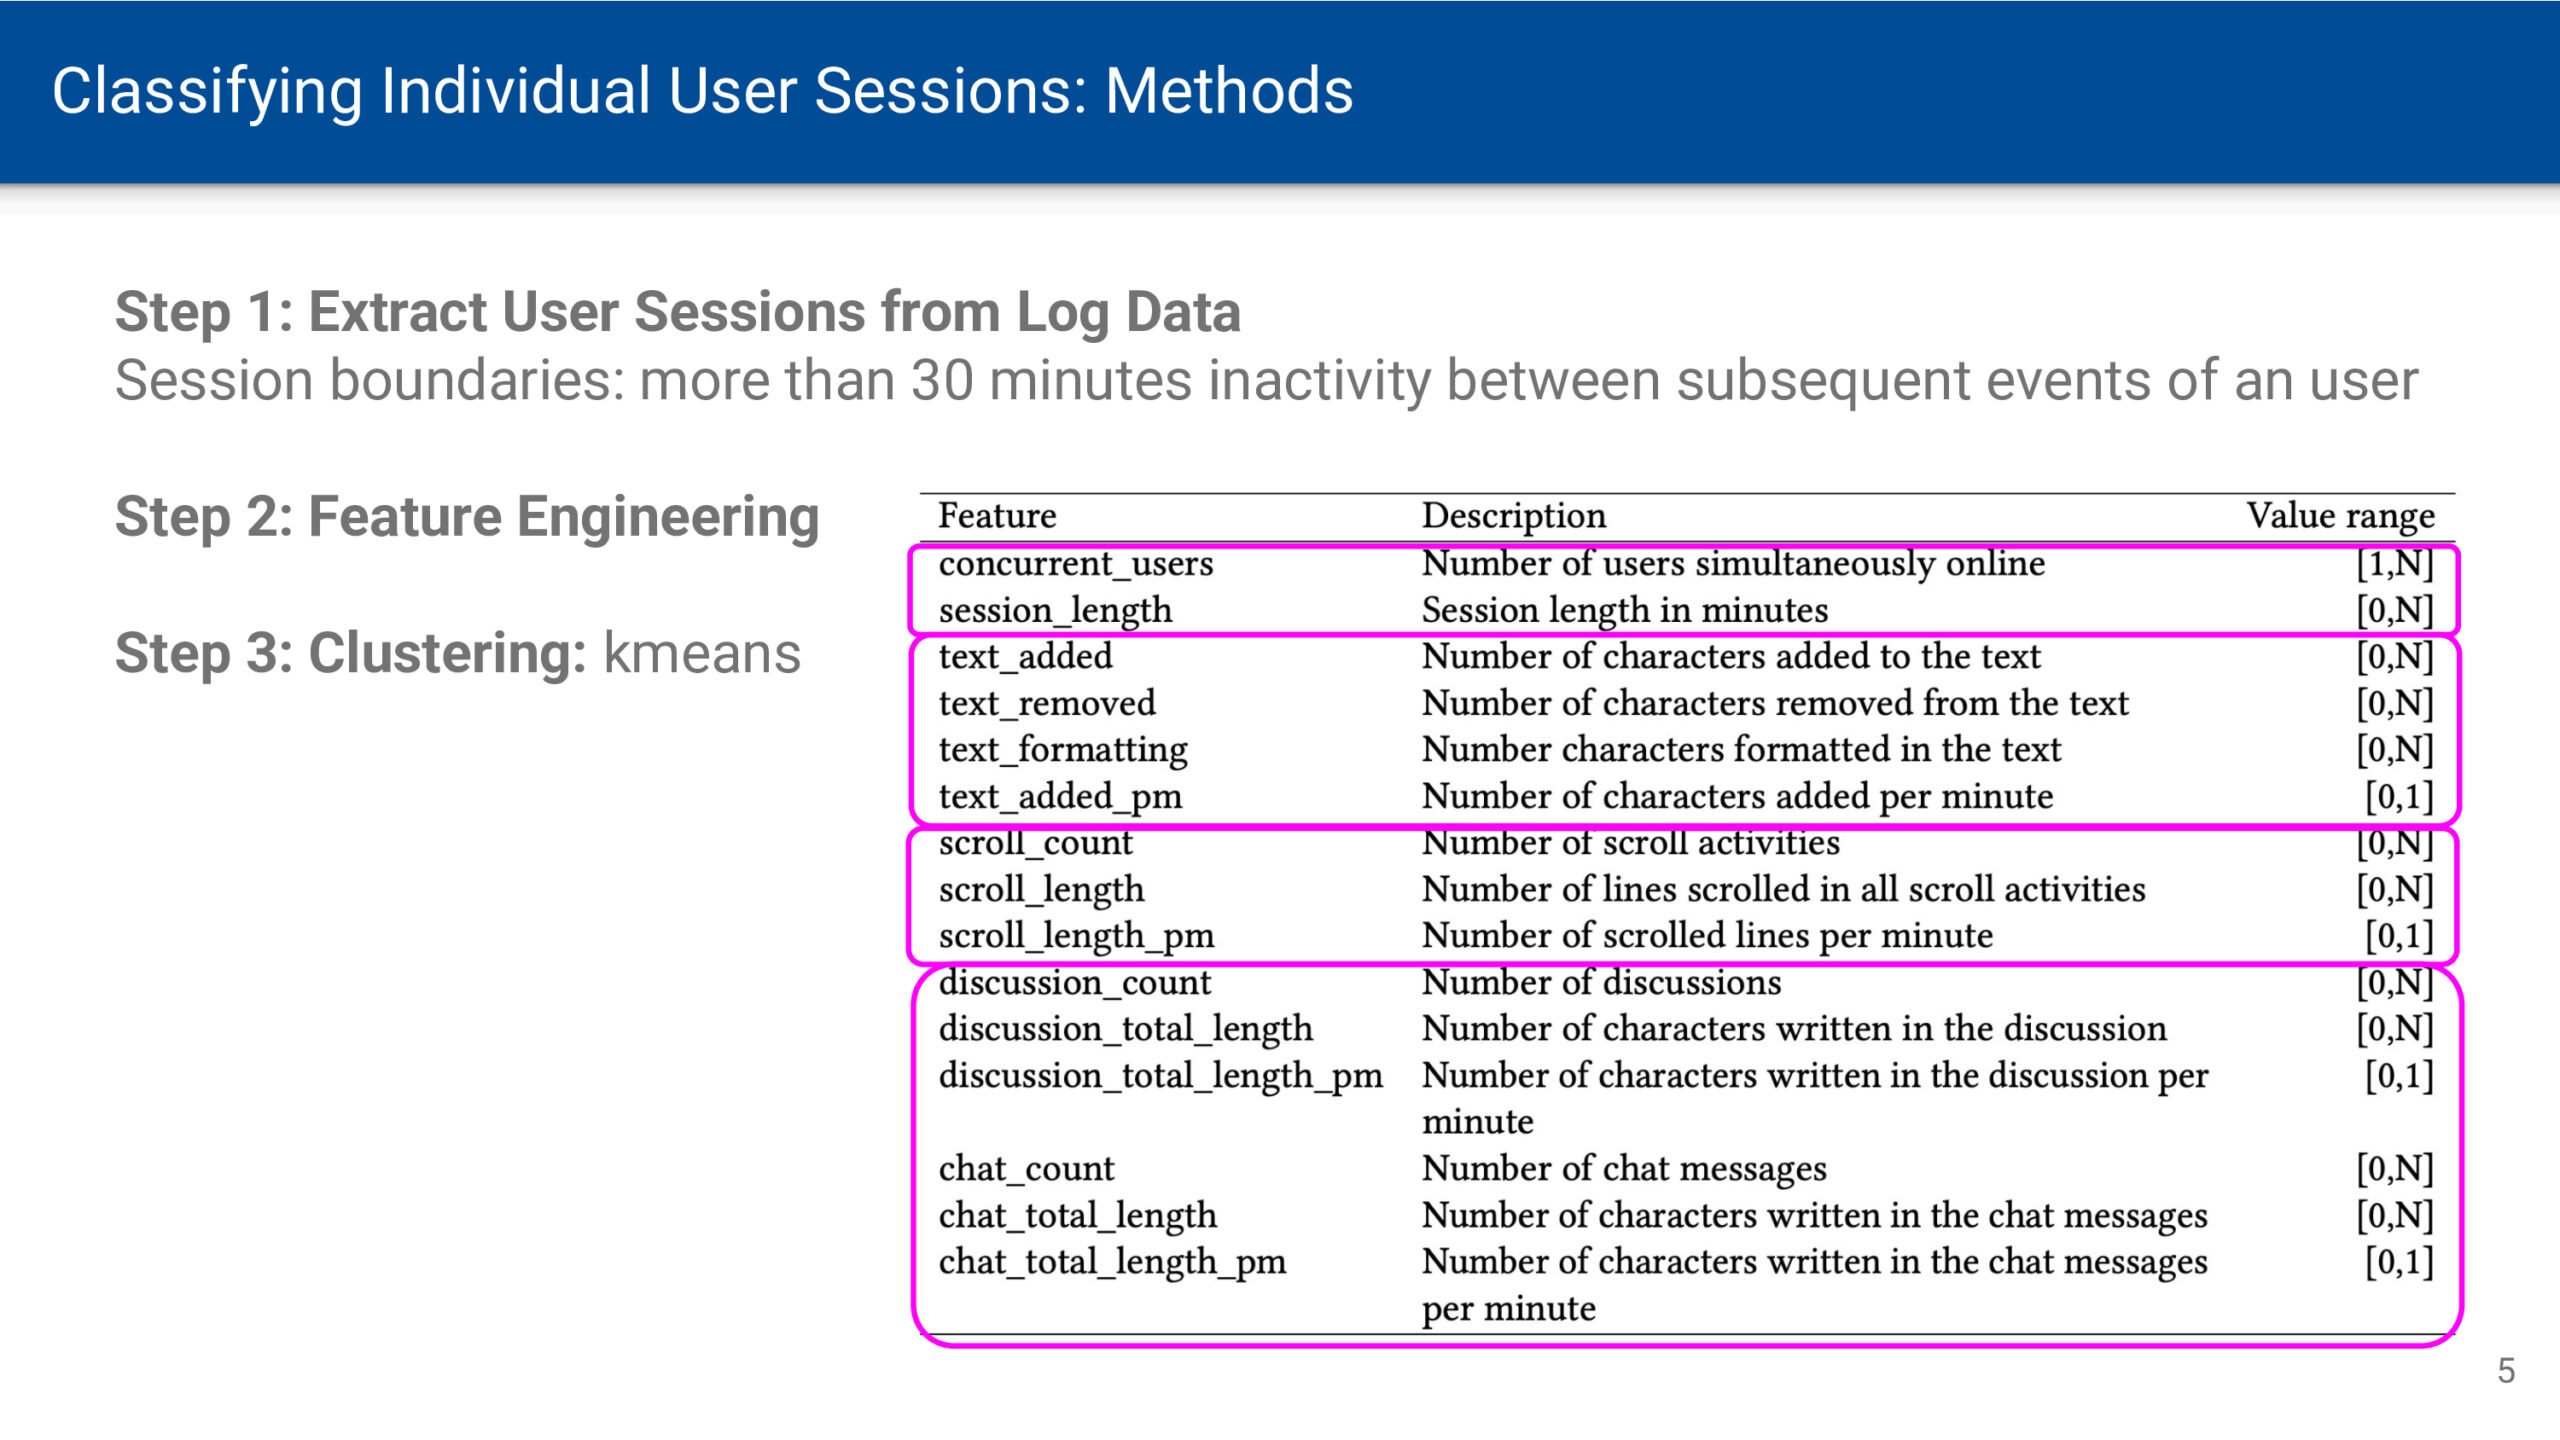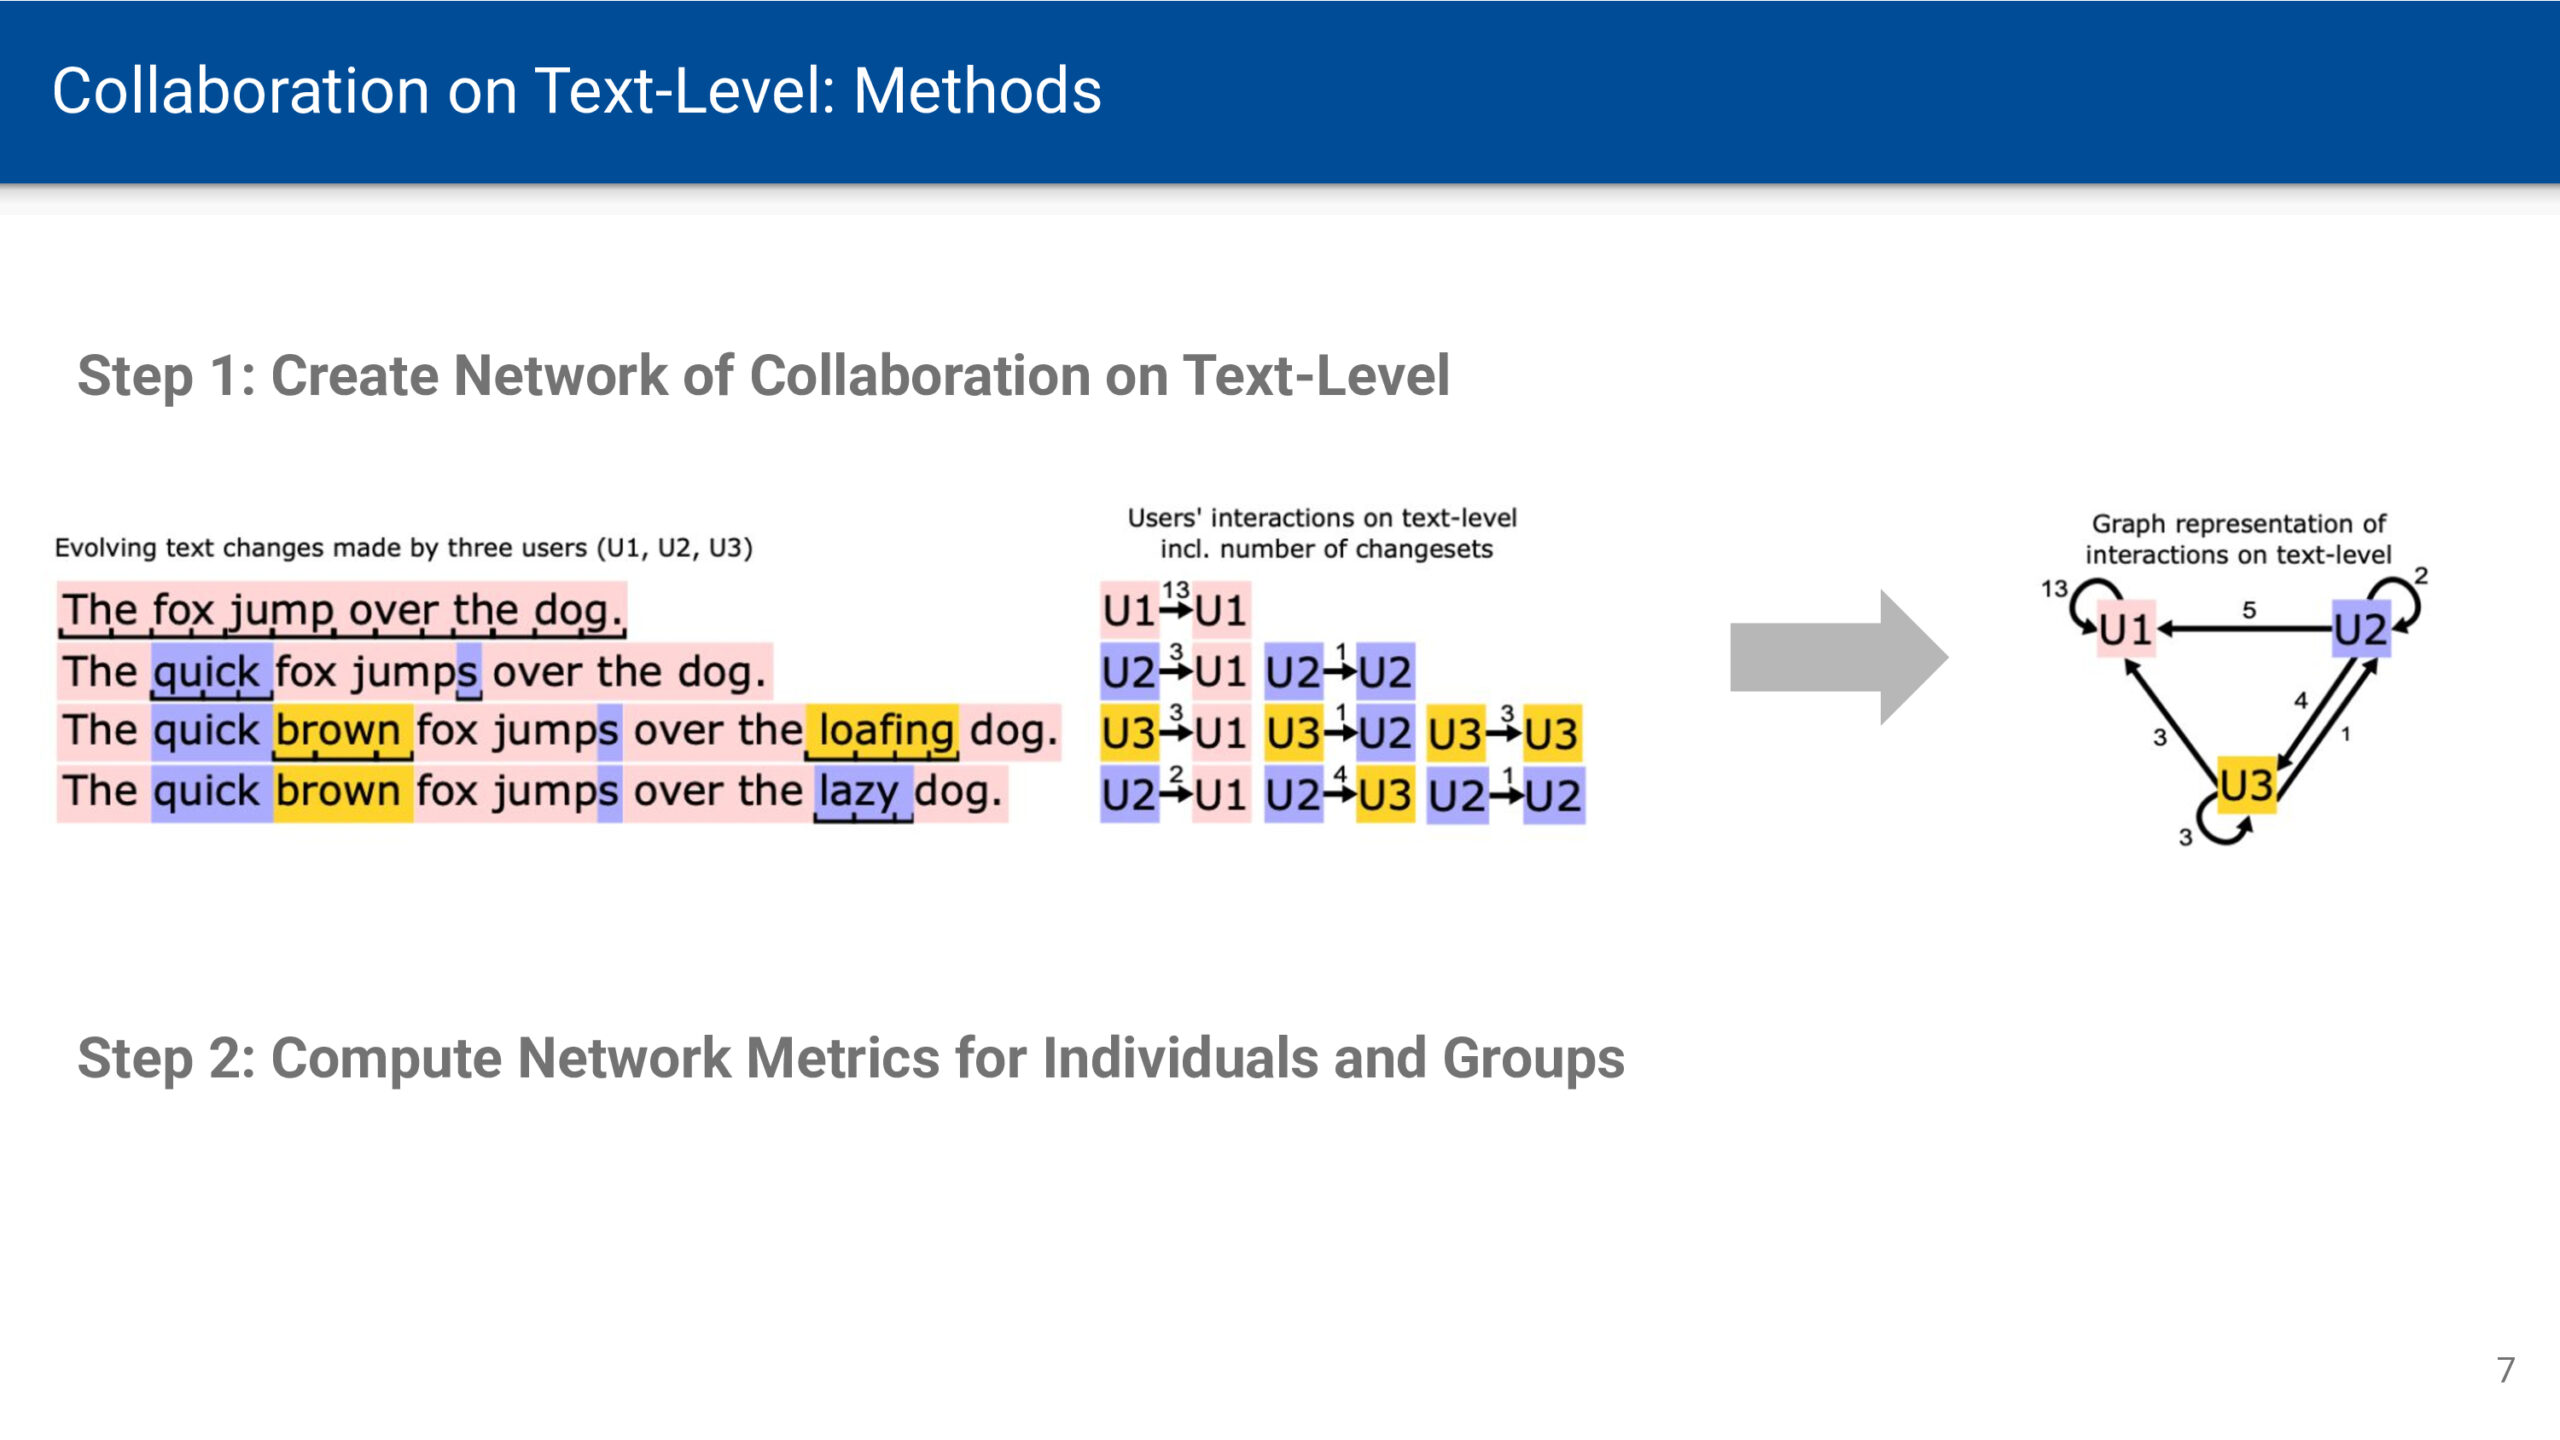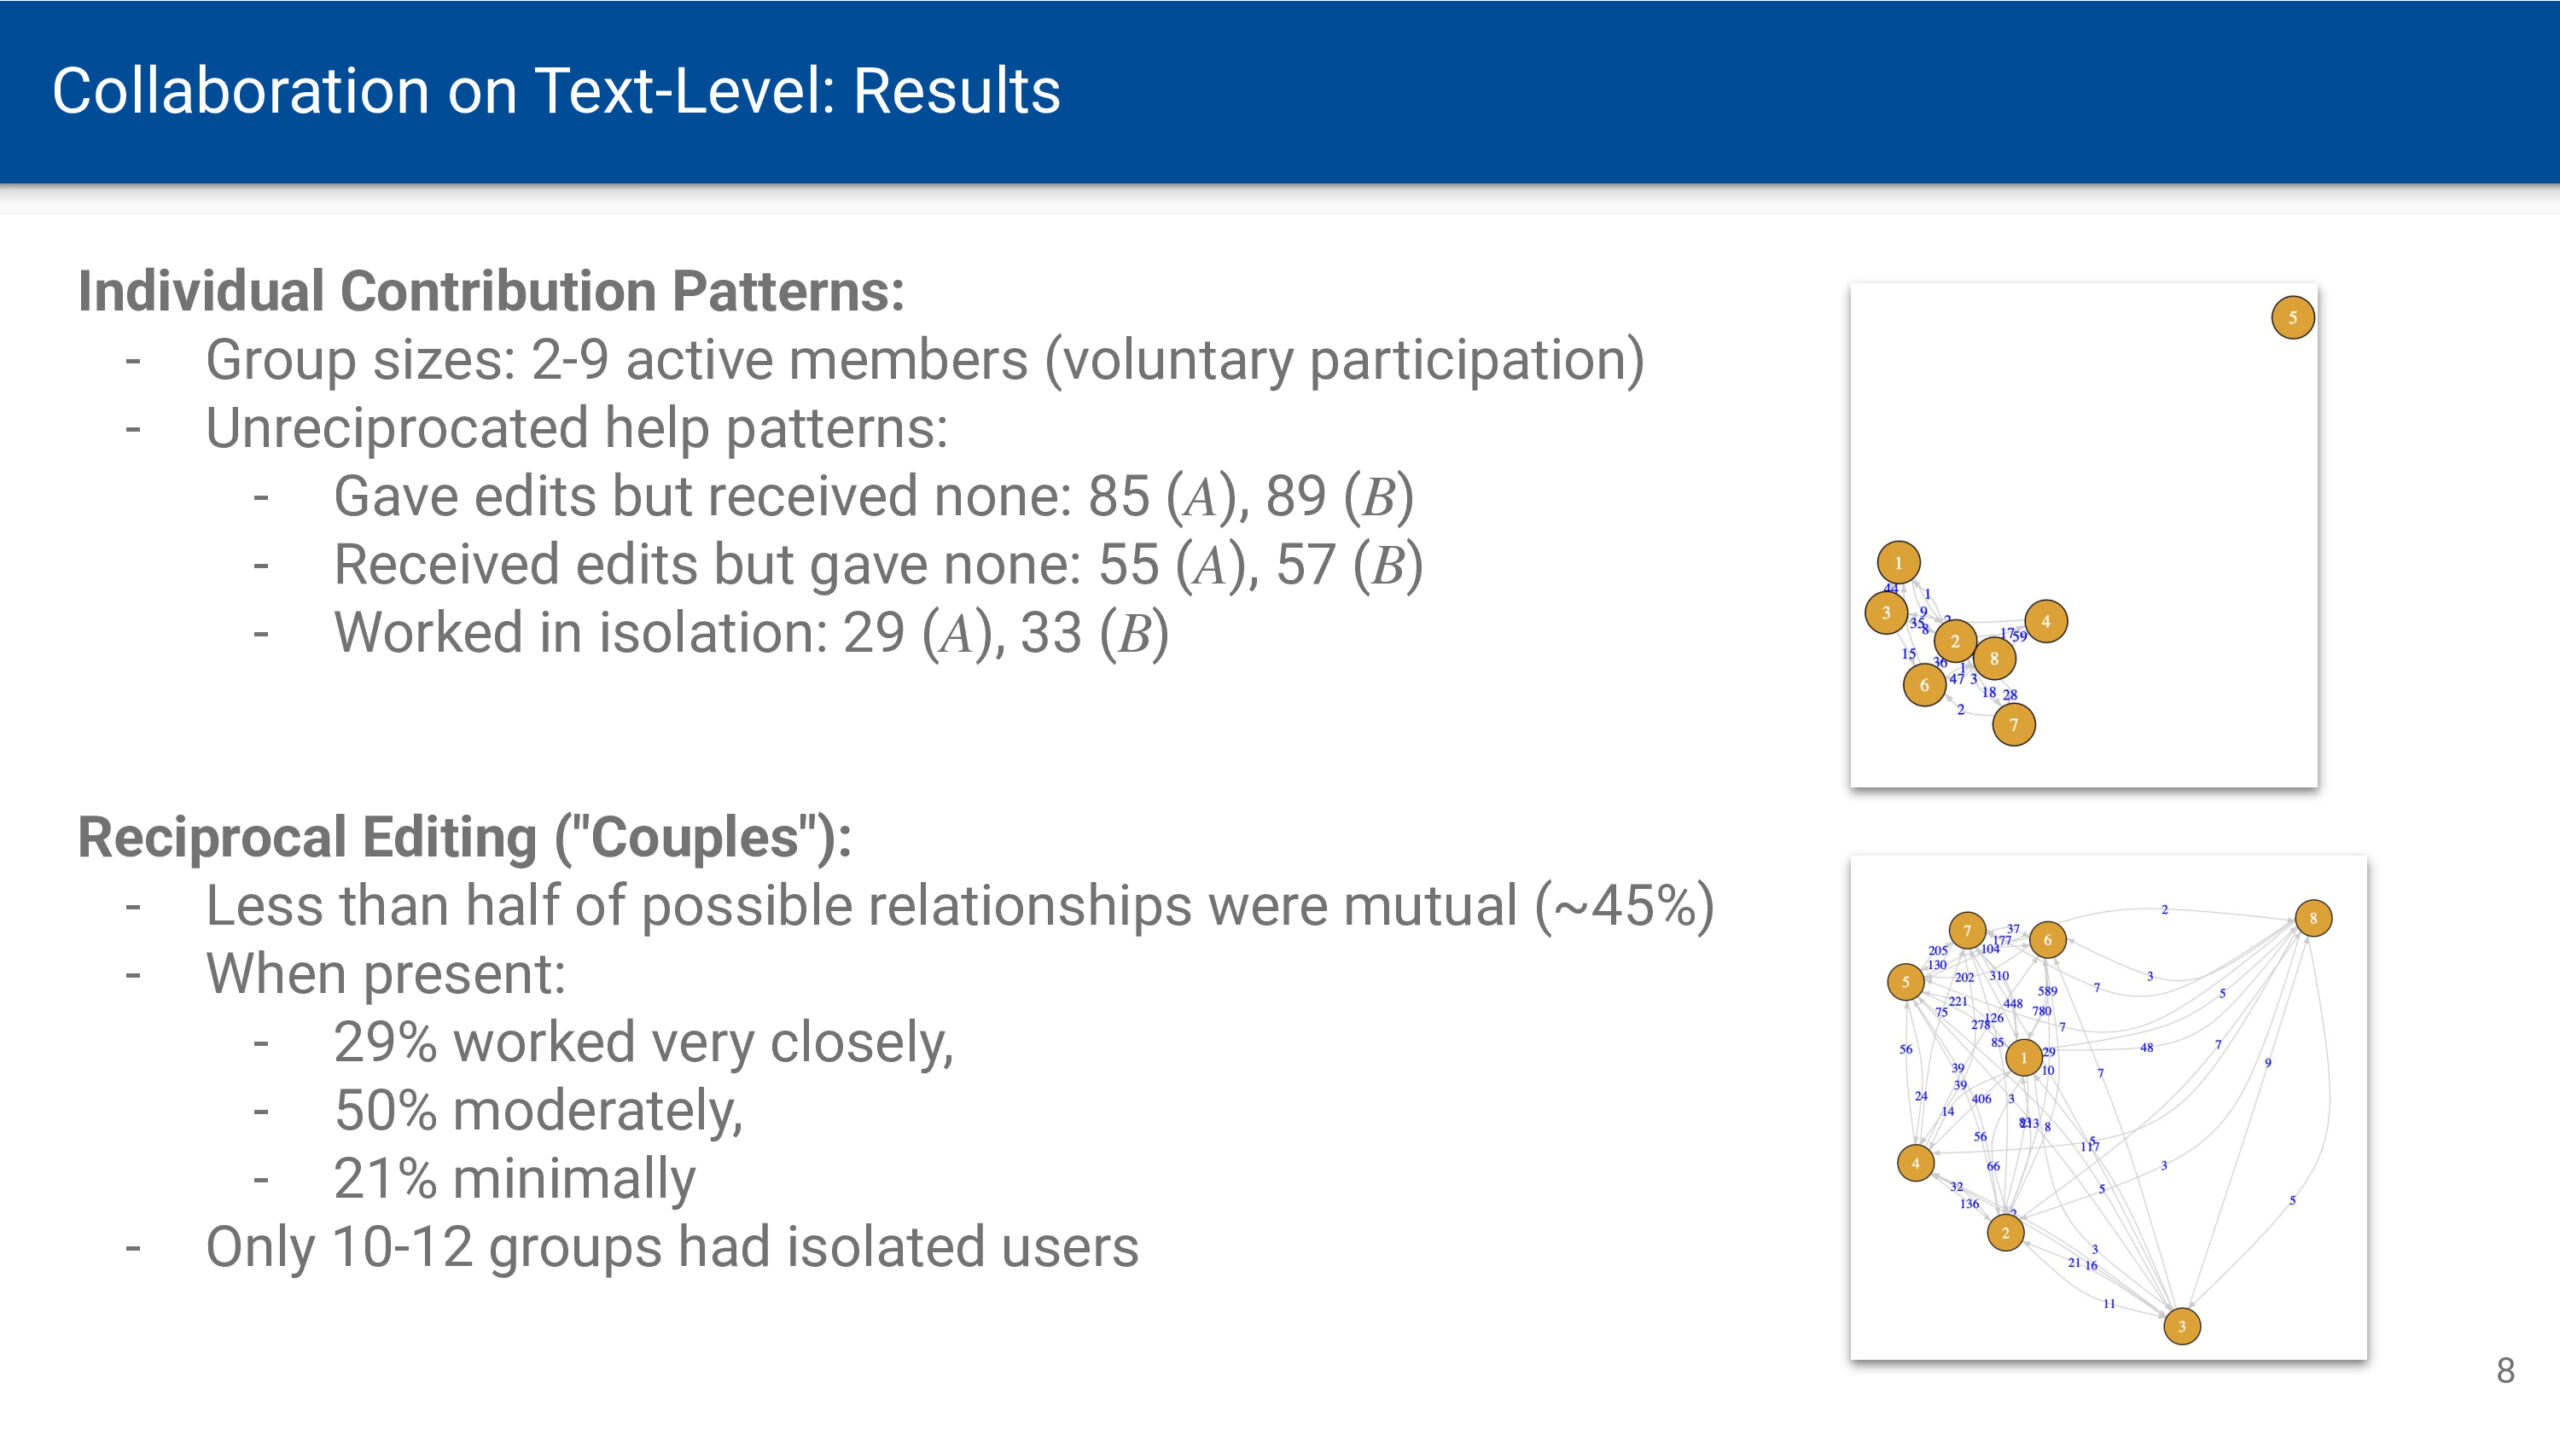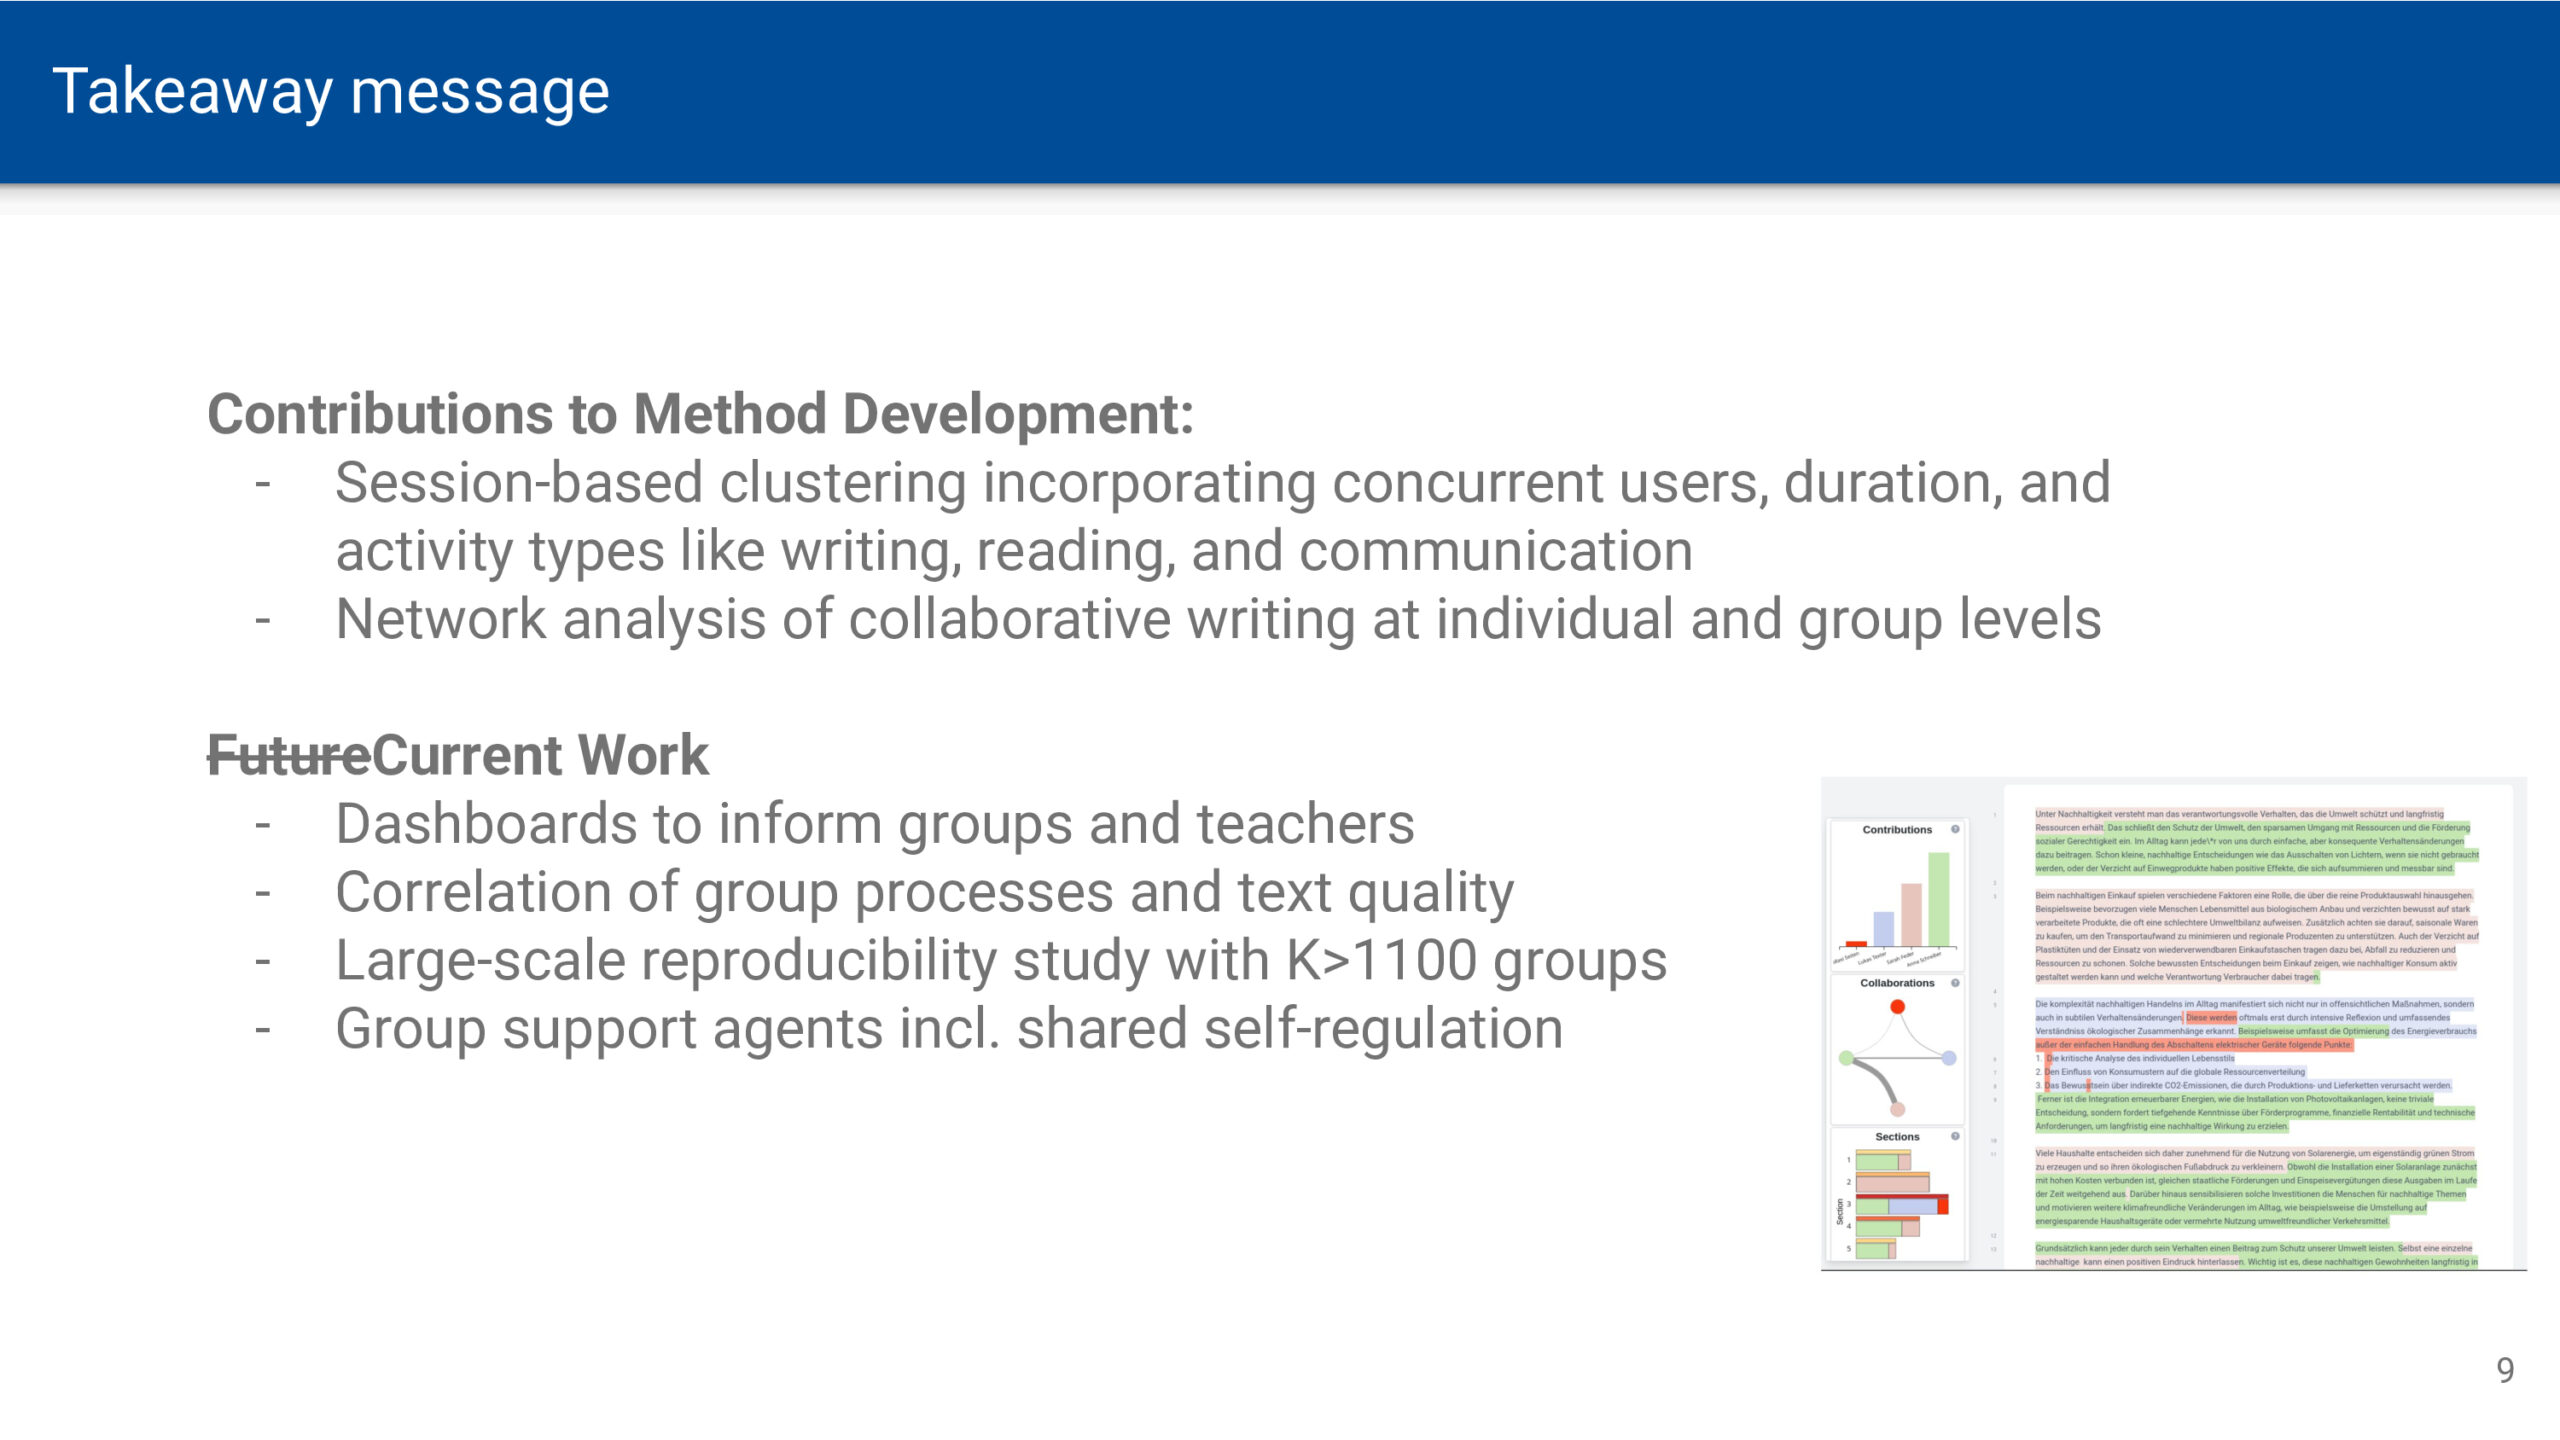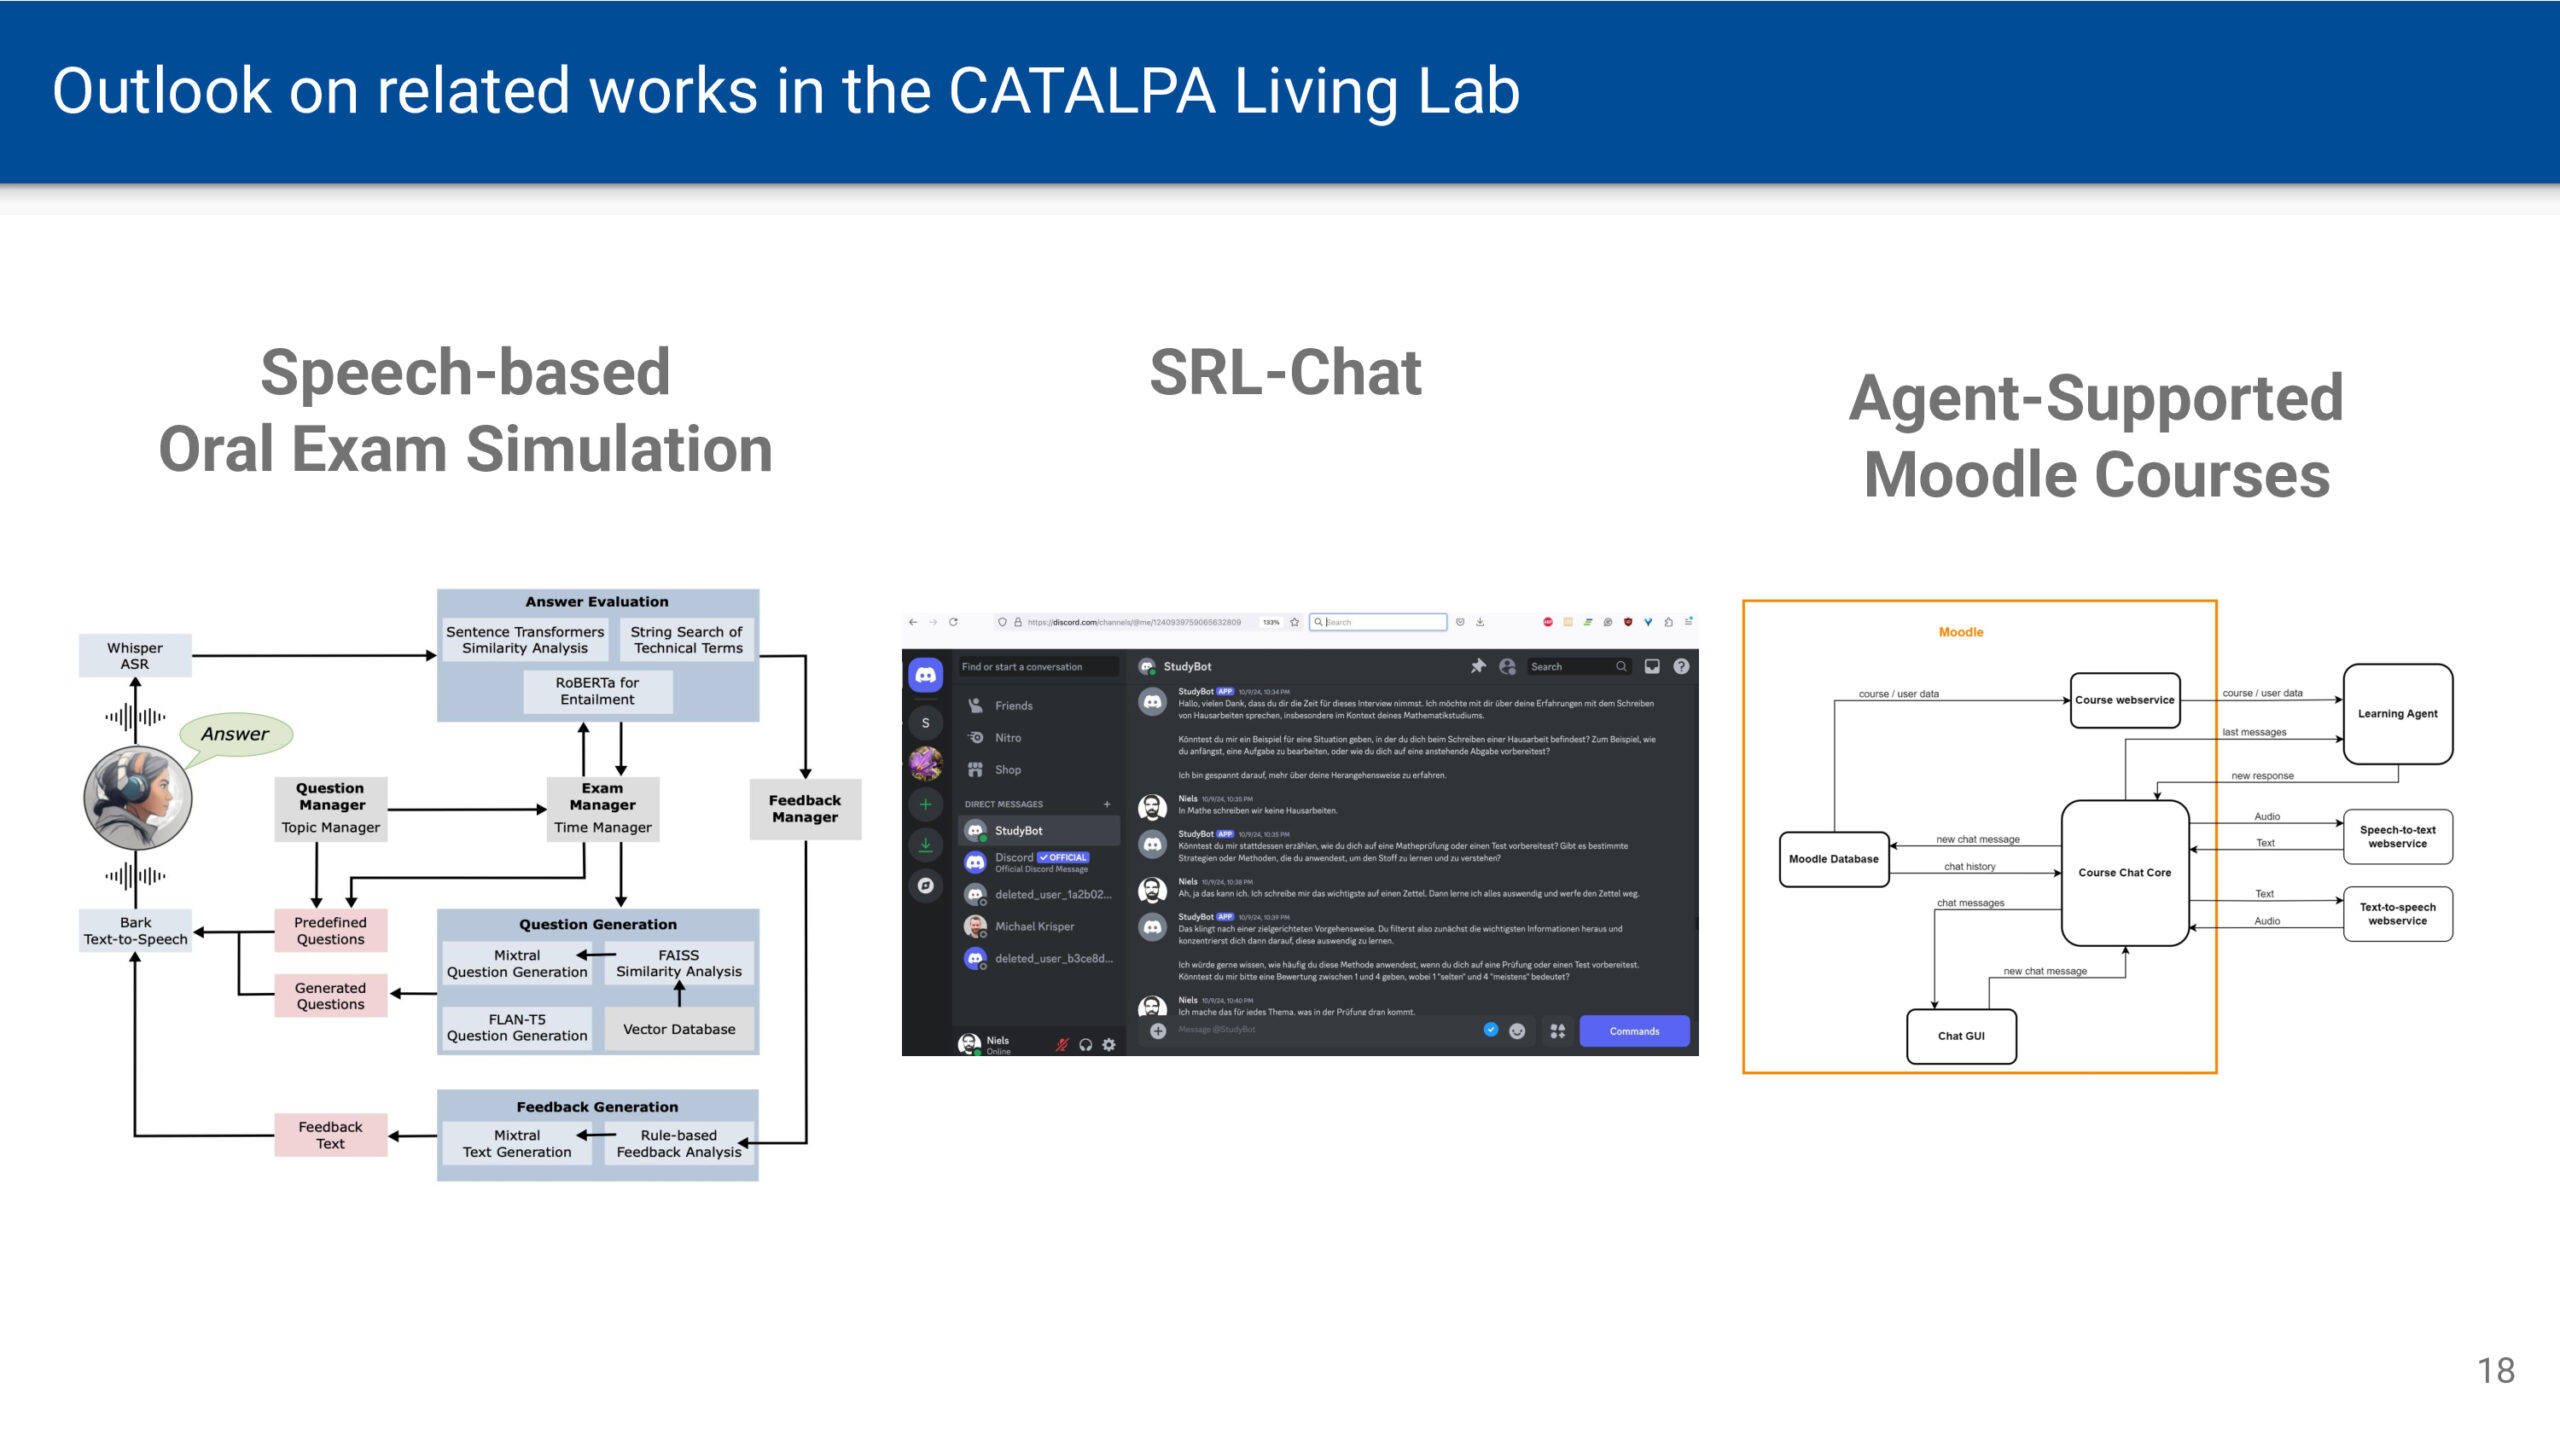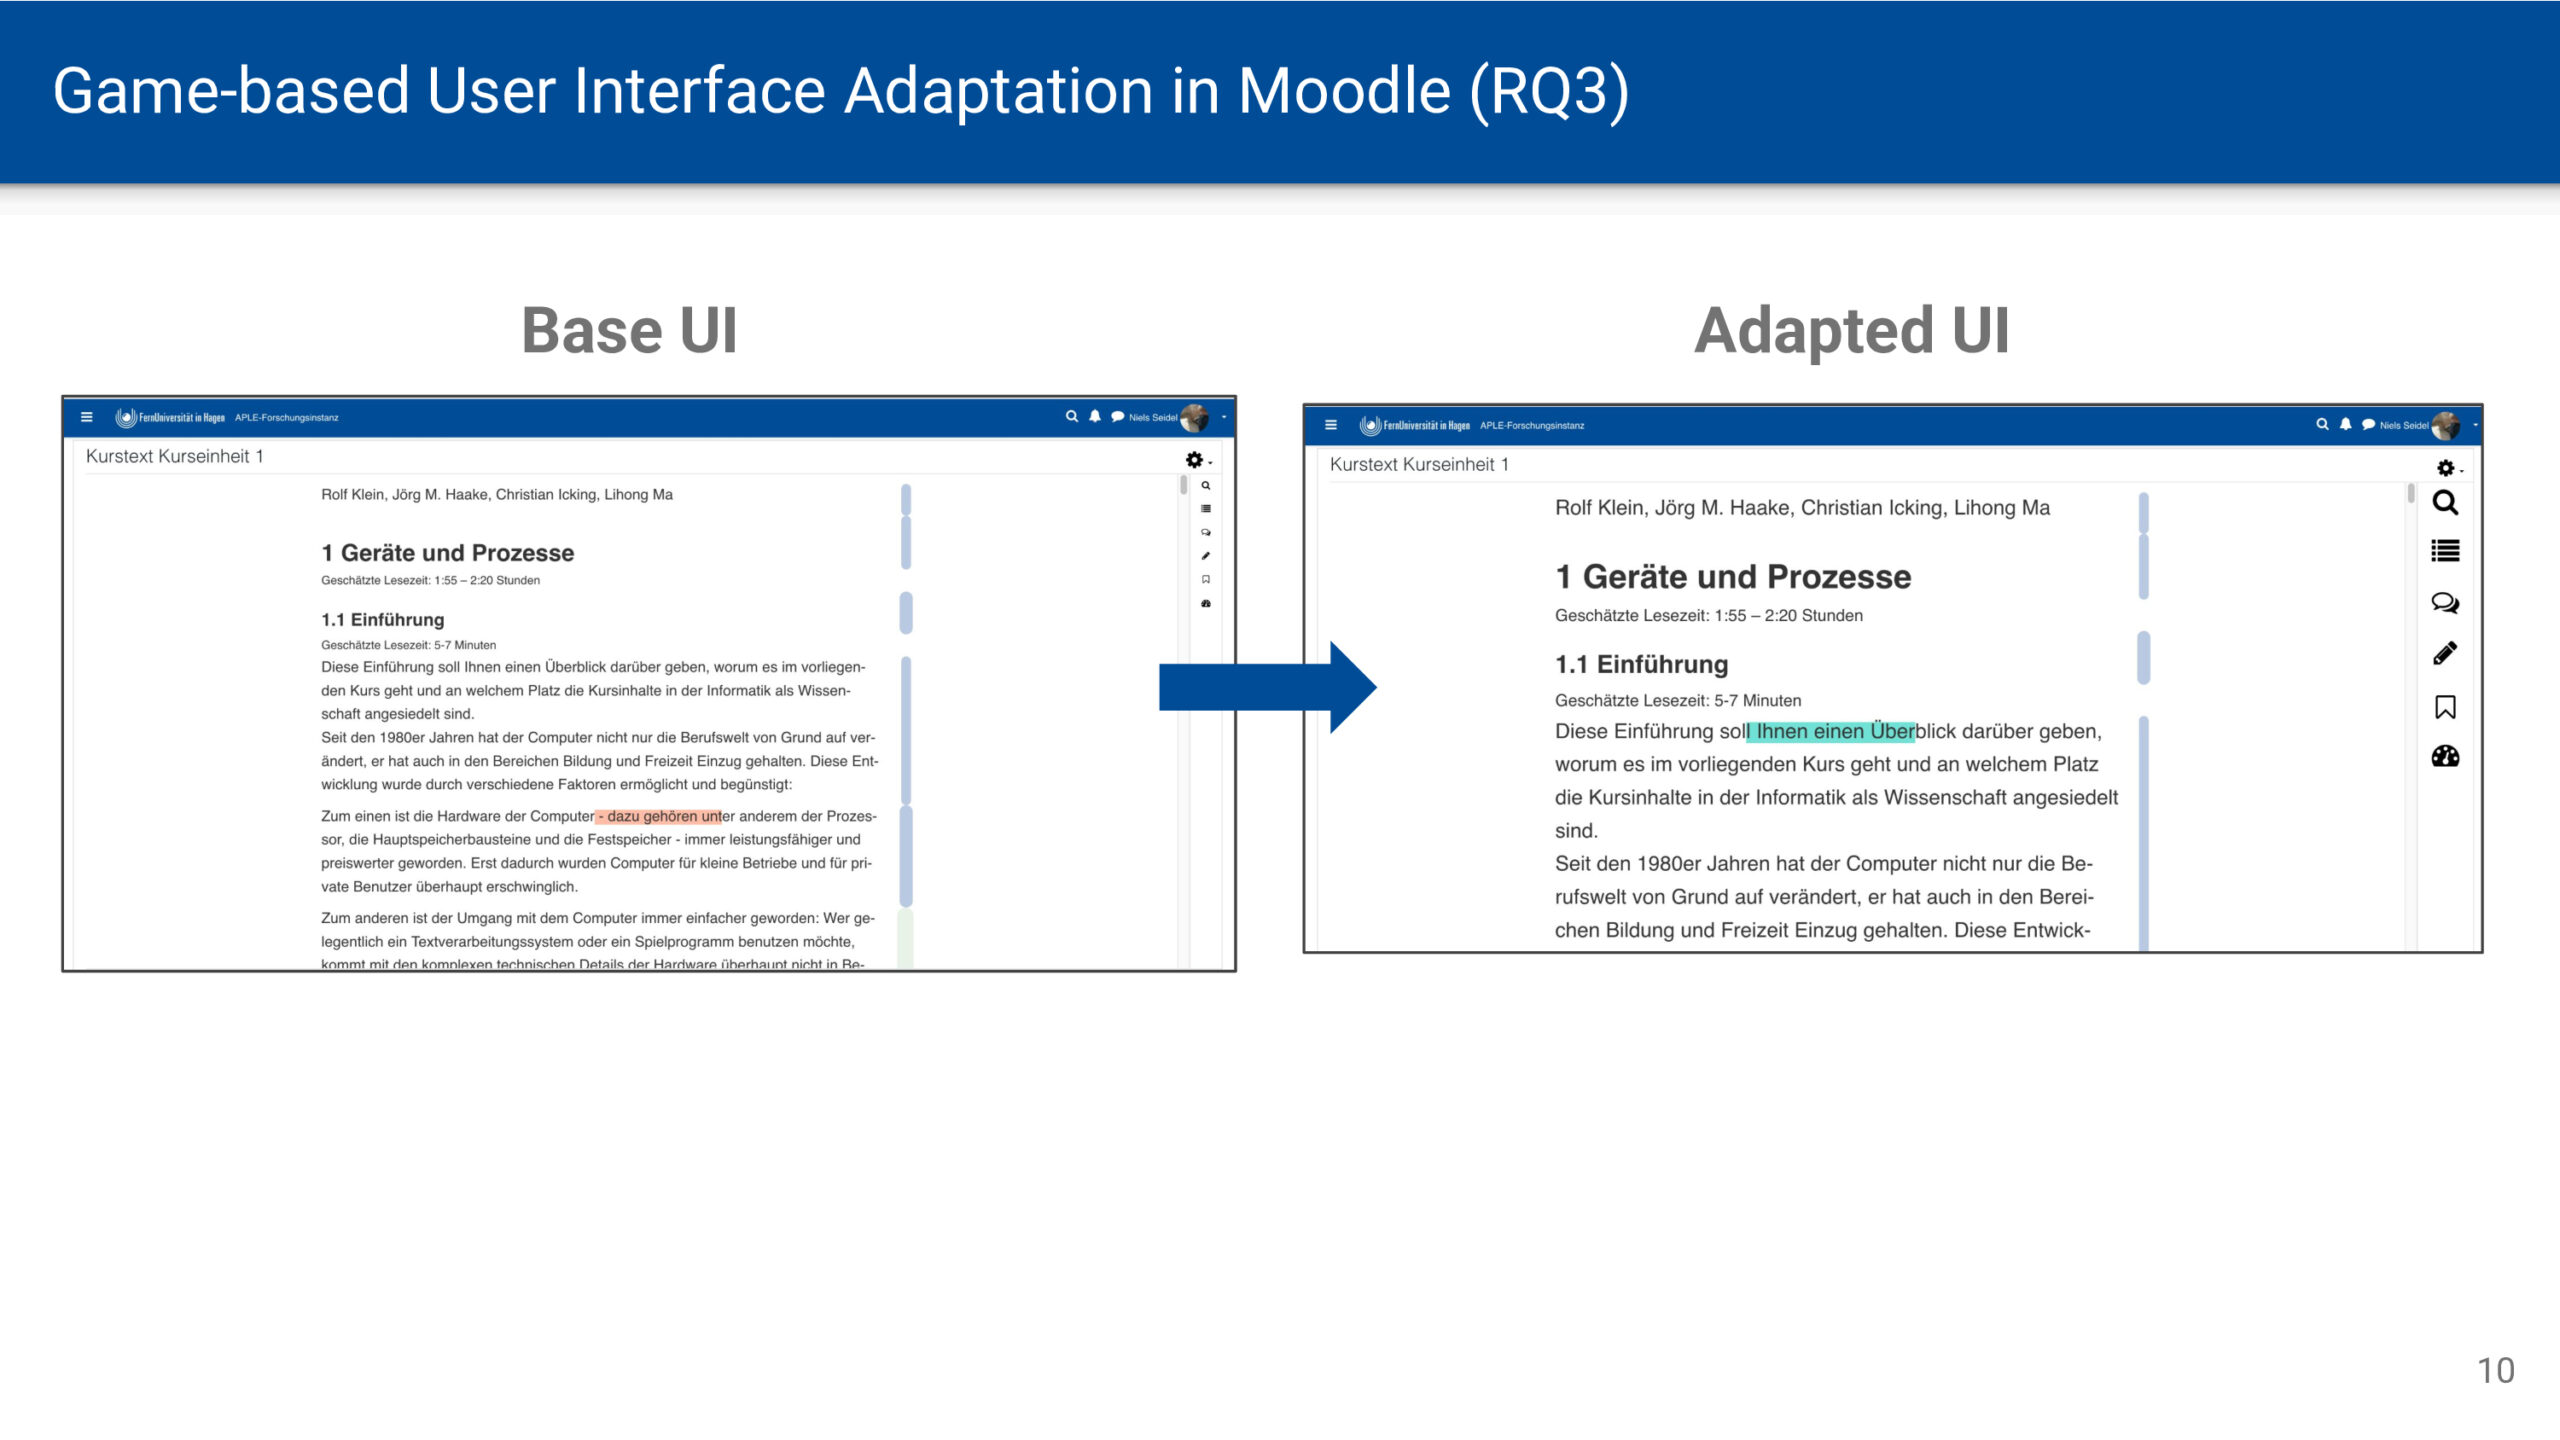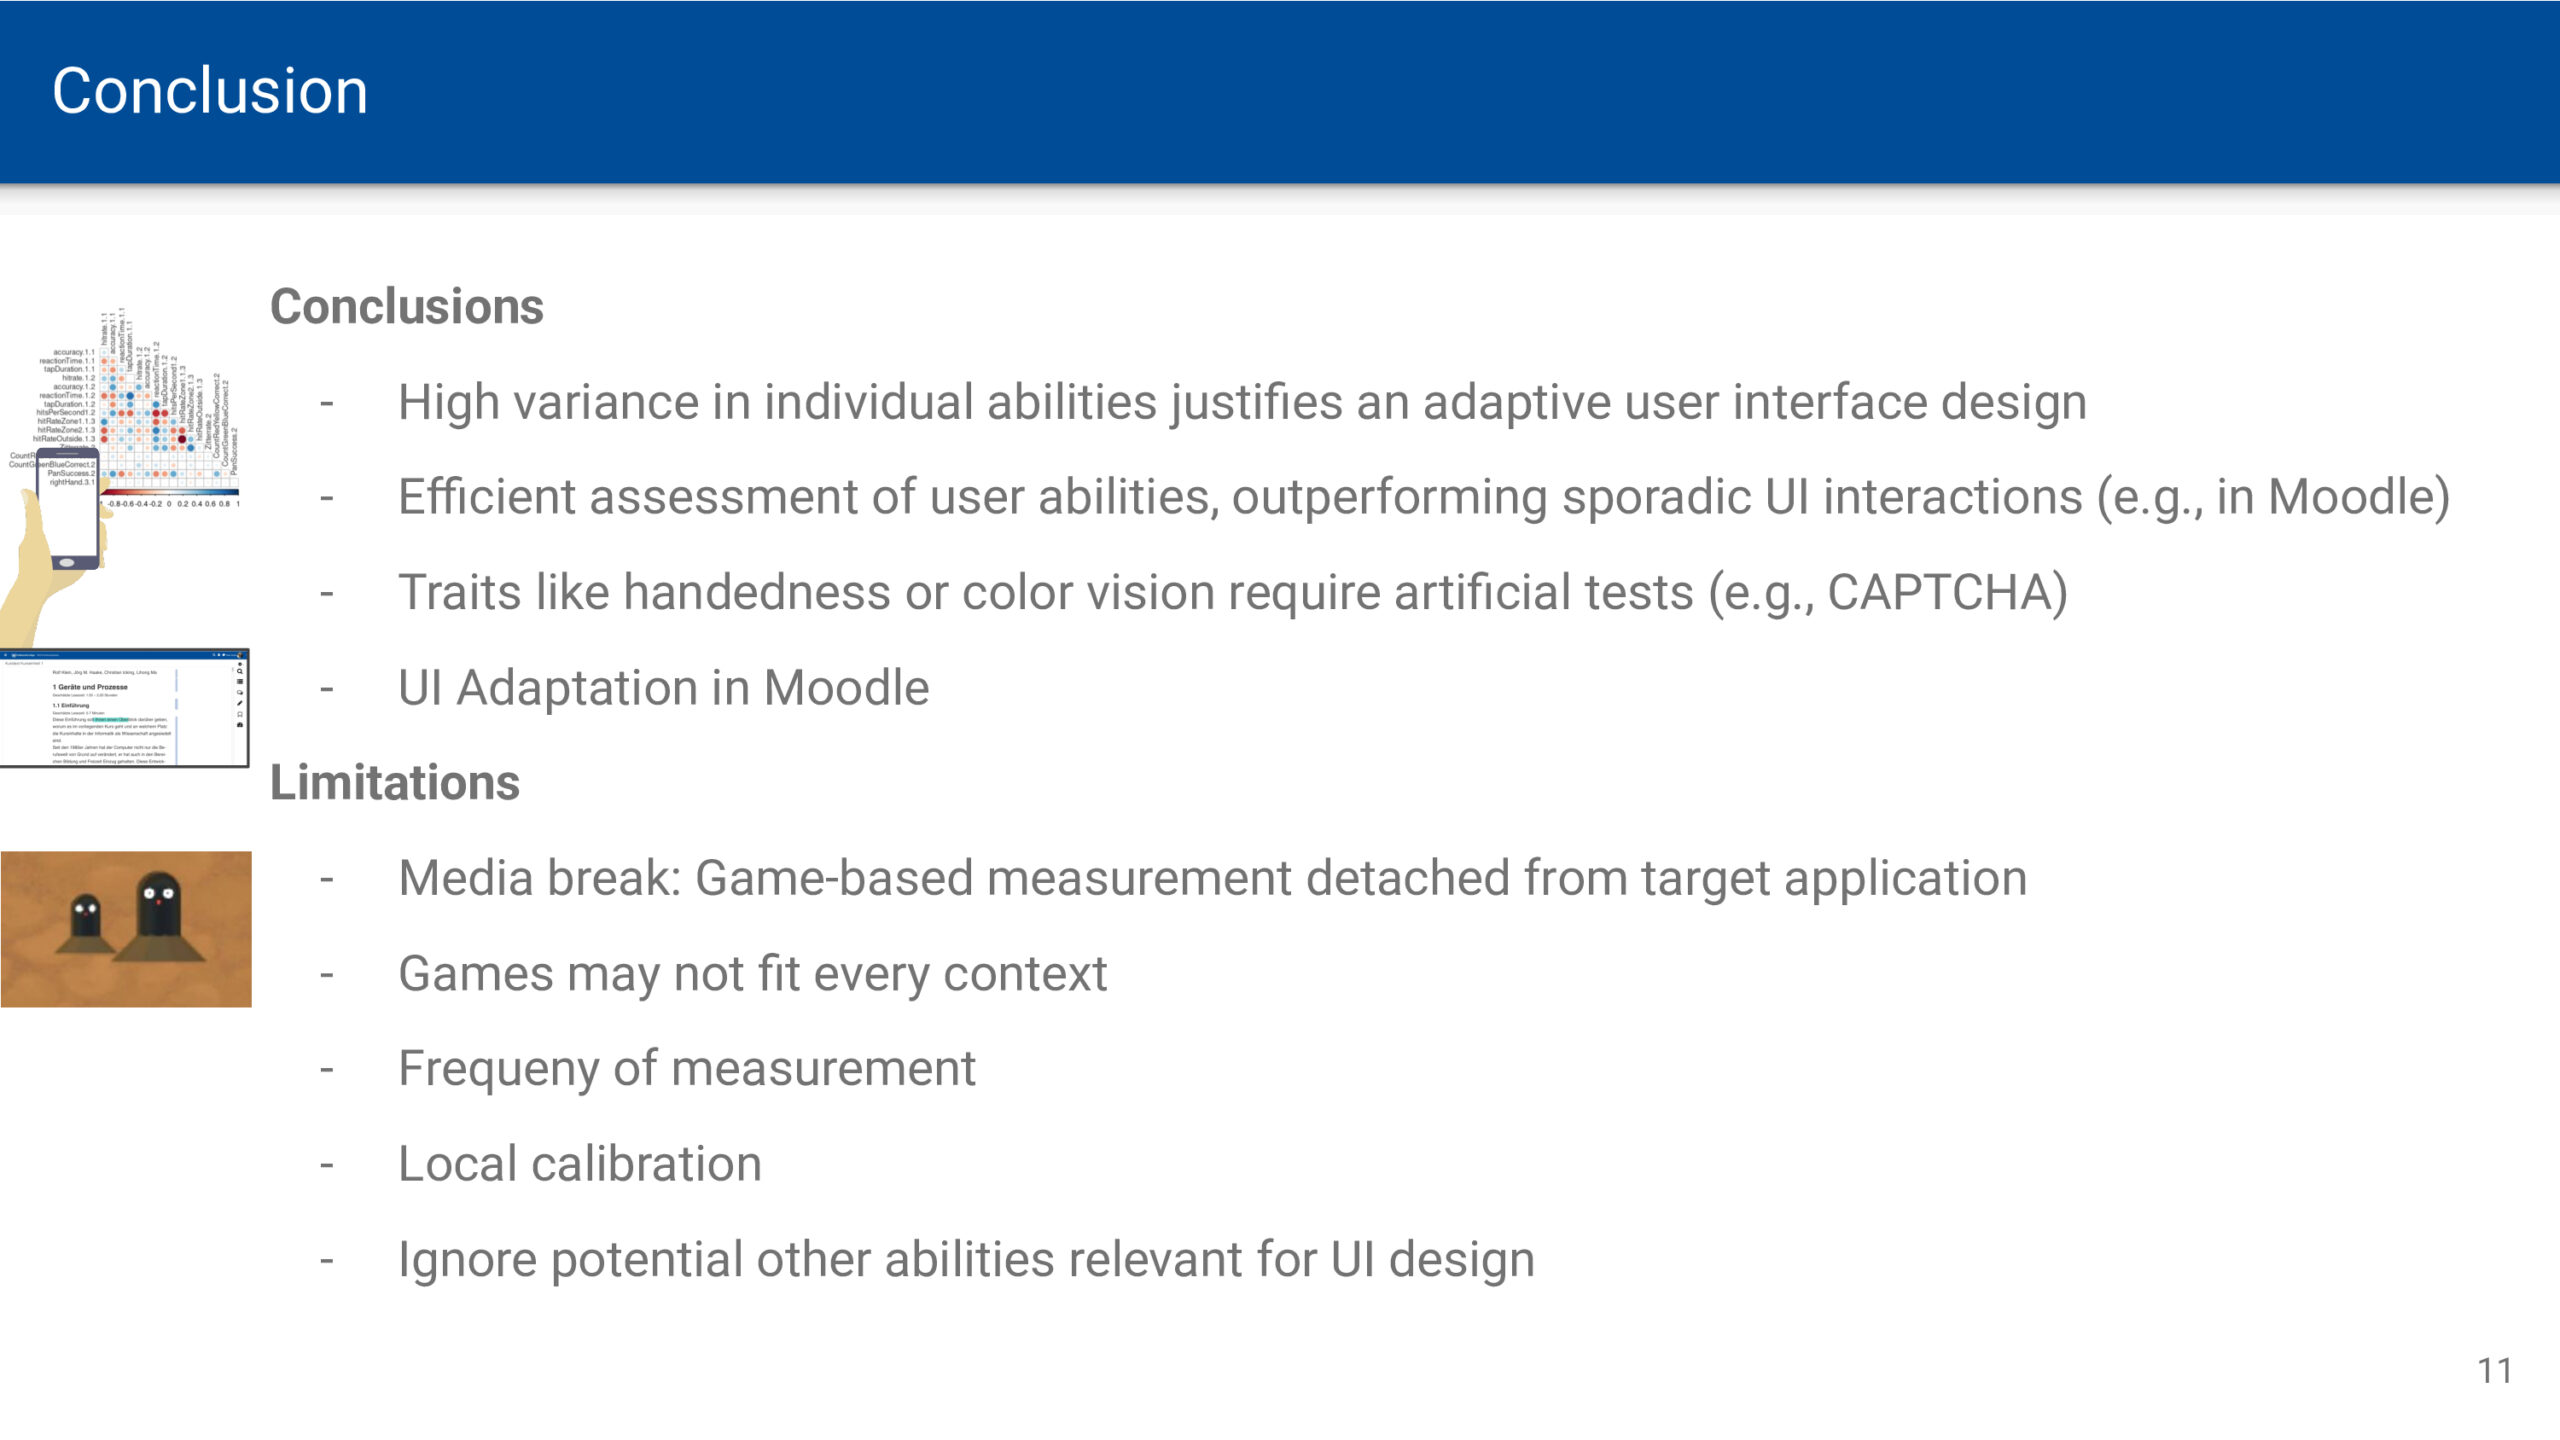
Die Hochschule als Graph repräsentiert

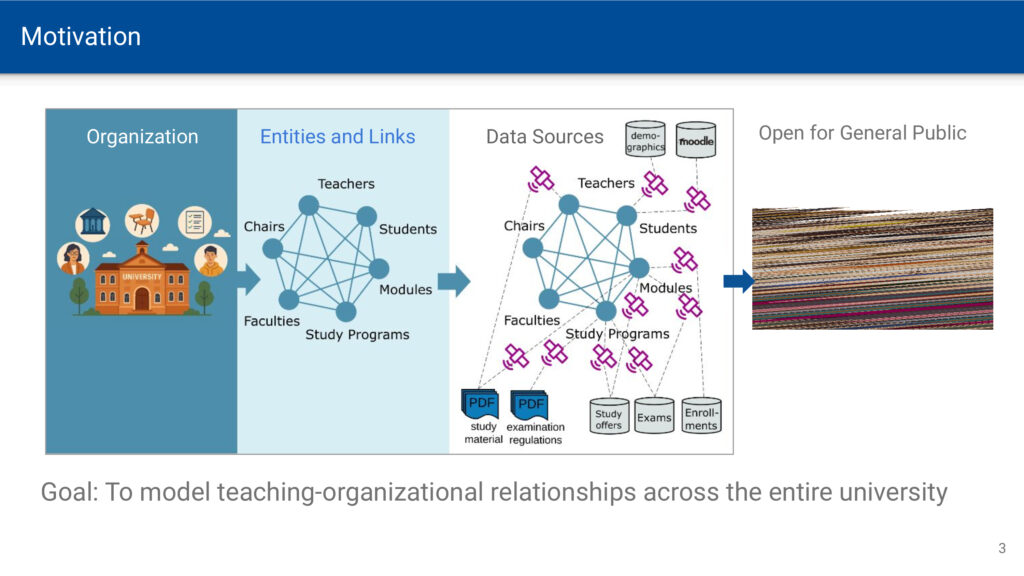
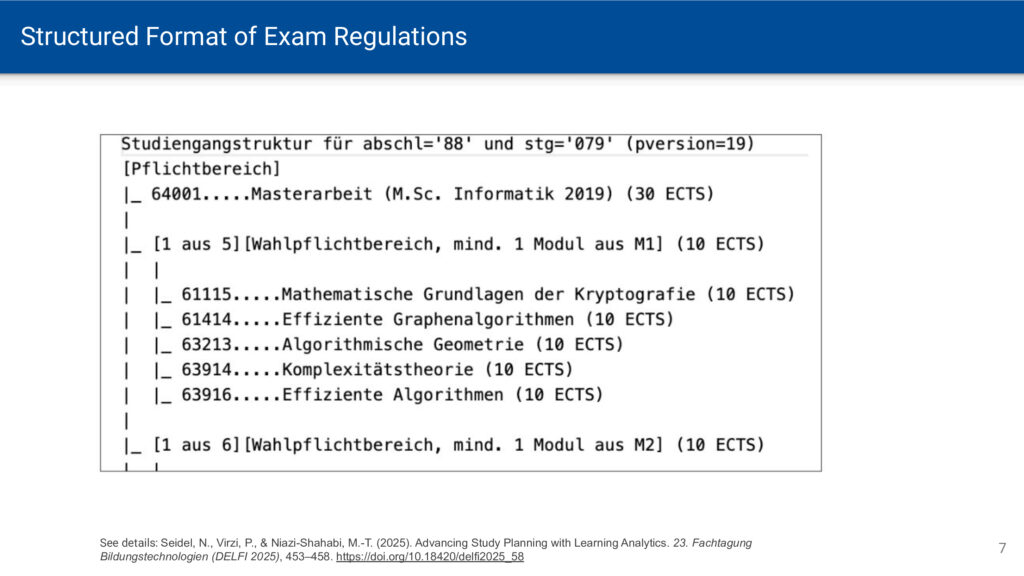
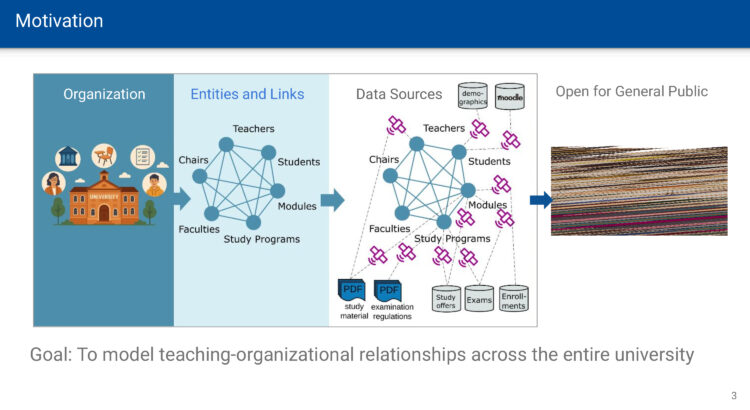
Hochschulen organisieren Lehre und Lernen nicht nur physisch, sondern auch digital. Die Bestandteile der Organisation wie Fakultäten, Studiengänge und Module sind digital abgebildet und werden auf Webseiten, in Modulhandbüchern und in Prüfungsordnungen für Menschen sichtbar und nutzbar. Für datenverarbeitende Maschinen sind diese Informationen jedoch unstrukturiert und deshalb schwer miteinander in Beziehung zu setzen. Wie gut Computerprogramme auf Informationen zugreifen können, nennt man Maschinenlesbarkeit. Eine Maschine kann die Zusammenhänge einer Hochschule nur dann richtig lesen, wenn die einzelnen Bestandteile und ihre Beziehungen zueinander eindeutig beschrieben sind. Zum Beispiel muss klar erkennbar sein, welche Module ein Studiengang anbietet und welche Kombinationen von Modulen für einen Abschluss nötig sind. Auf Basis unstrukturierter Daten können Maschinen eine Organisation also nicht „verstehen“, und Nutzer:innen können sich mithilfe von Software keine Fragen zur Organisation beantworten lassen.

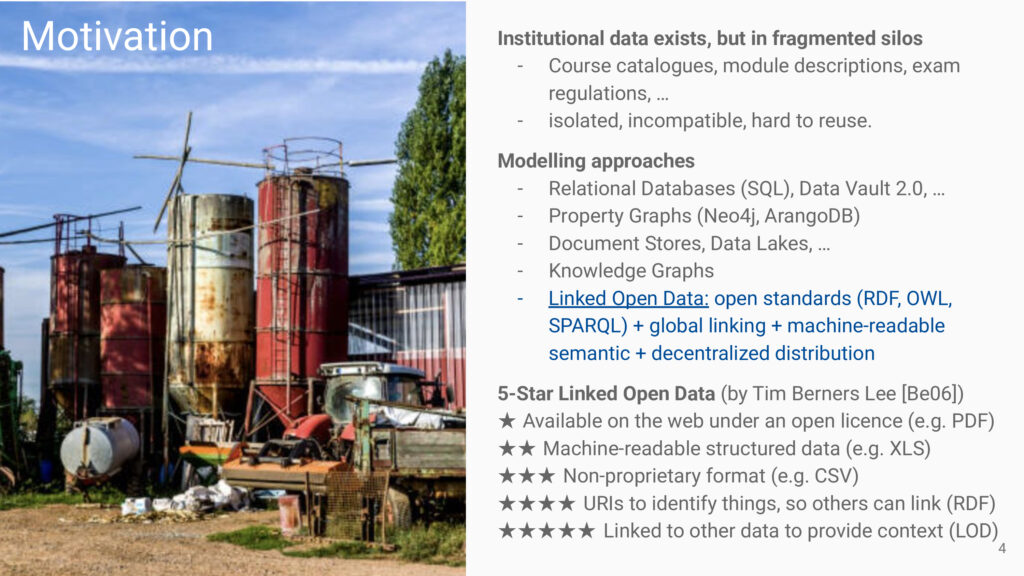
Oft kennt nicht einmal die Hochschule selbst das ganze Bild. Die Informationen verteilen sich auf PDF-Dokumente, Campus-Management-Systeme, Fakultätsseiten und das Wissen einzelner Mitarbeitender. Das ist erstaunlich, denn seit den 2000er-Jahren veröffentlichen Behörden immer mehr offene Daten, also Daten, die alle frei nutzen, weitergeben und wiederverwenden dürfen. Auch Hochschulen setzen sich für Open Access und offene Forschungsdaten ein. Daten darüber, wie die Hochschule selbst aufgebaut ist, sind dagegen kaum offen verfügbar.

Unser Lösungsansatz

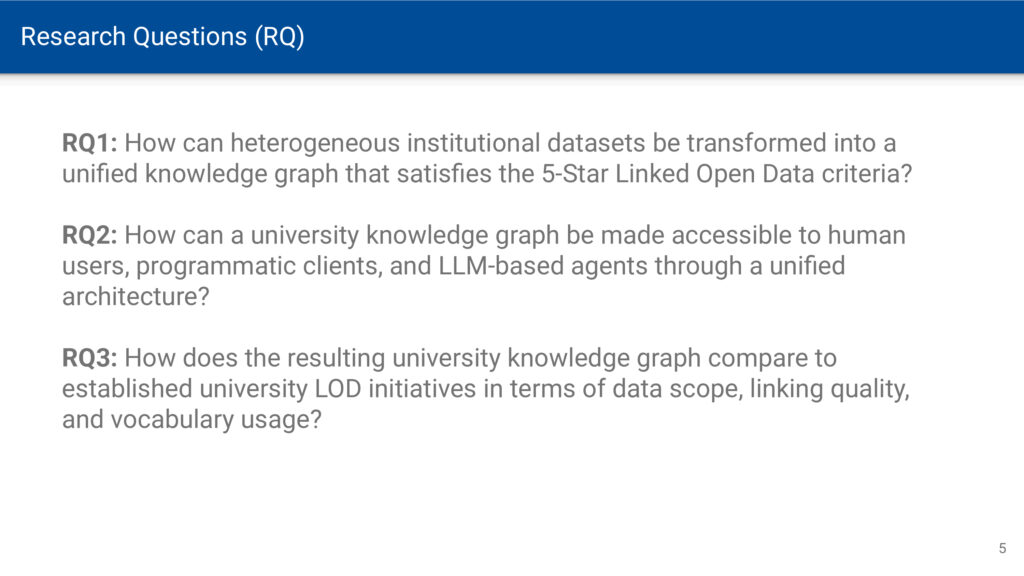
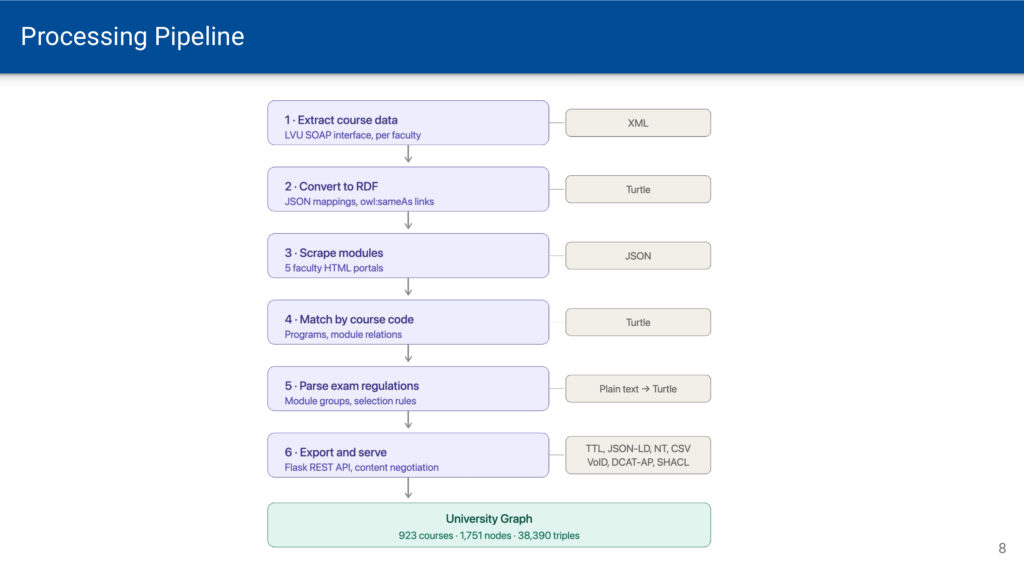
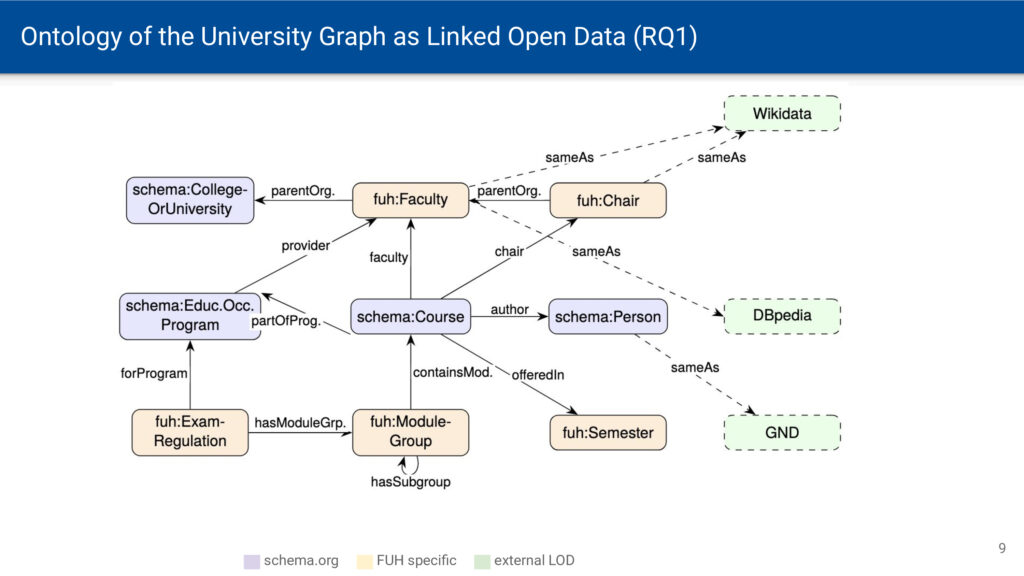
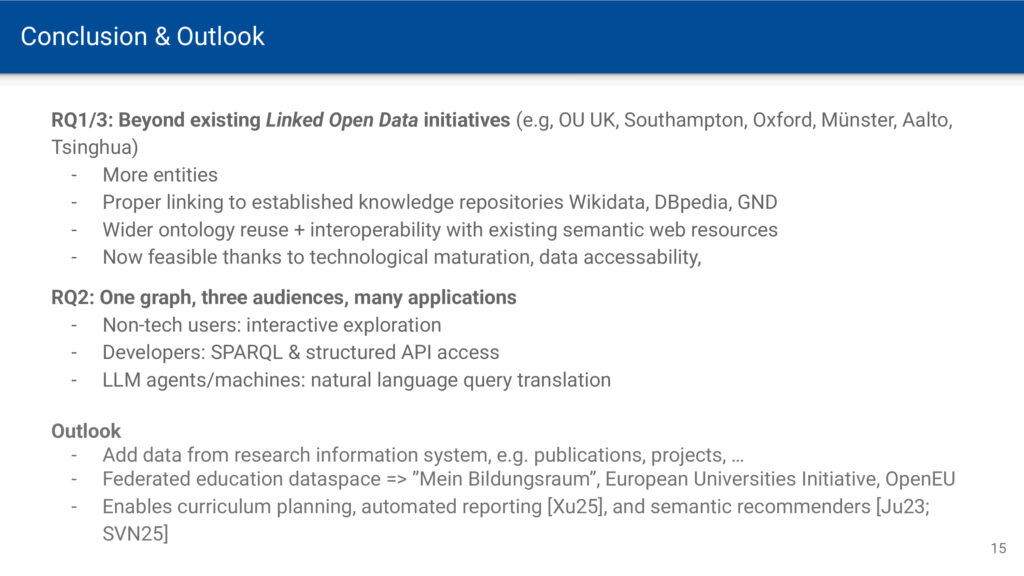
In unserem neuen Paper untersuchen wir, welche Daten in den Informationssystemen der FernUniversität in Hagen vorhanden sind, welche davon für Menschen außerhalb der Hochschule nützlich sind und wie man sie zugänglich machen kann. Dazu haben wir das Vorlesungsverzeichnis über mehrere Semester hinweg aufbereitet, mit Fakultäten, Studiengängen und Prüfungsordnungen. Die Daten liegen jetzt als sogenannte Linked Open Data vor. In der Fachsprache bezeichnet man diese Datenstruktur auch als Graph bzw. Wissensgraph. Das bedeutet: Jeder Bestandteil, etwa ein Modul oder ein Studiengang, bekommt eine eindeutige Adresse im Web, und die Beziehungen zwischen den Bestandteilen sind ausdrücklich beschrieben. Außerdem sind die Daten mit anderen Quellen im Web verknüpft.

Drei Zugänge zu denselben Daten

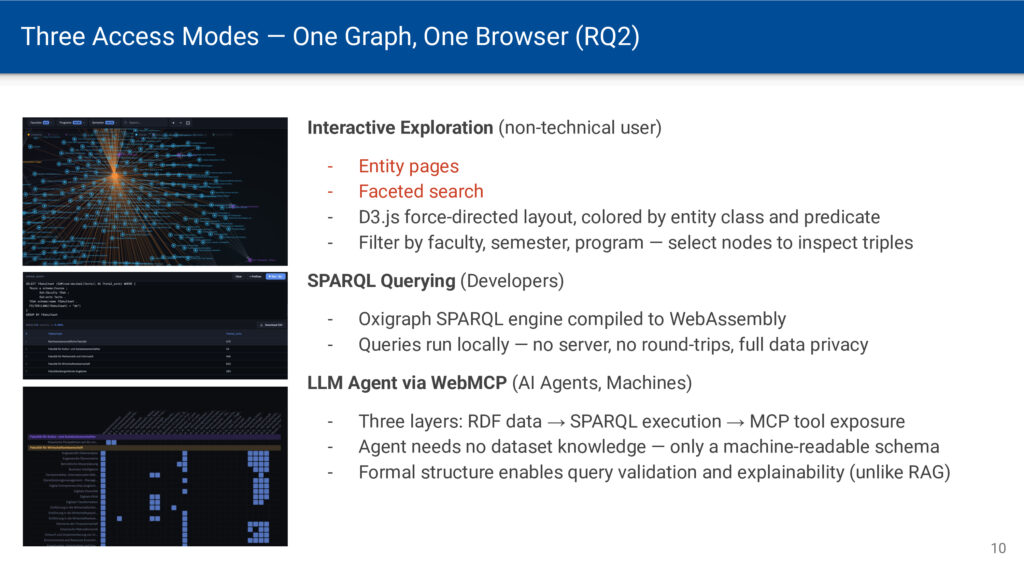
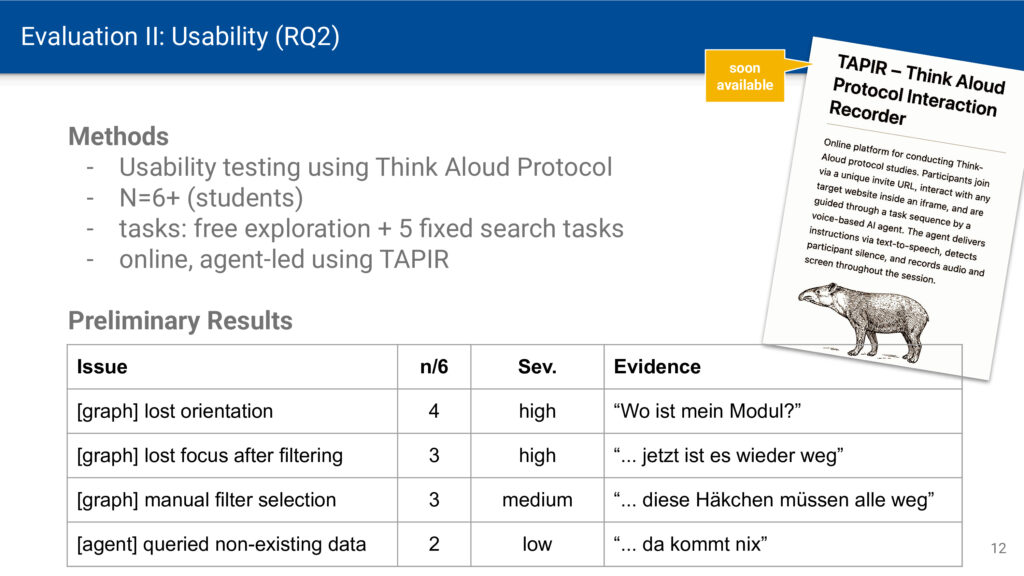
Die Software, die wir veröffentlicht haben, bietet drei Wege zu den Daten. Menschen können die Zusammenhänge in einer visuellen Oberfläche erkunden und sich durch Fakultäten, Studiengänge und Module klicken. Computerprogramme können die Daten über eine SPARQL-Schnittstelle abfragen, eine Standardsprache für solche vernetzten Daten. Und KI-Agenten können über eine WebMCP-Schnittstelle direkt auf die Daten zugreifen, zum Beispiel um Fragen von Studierenden zu beantworten. Fragen, für die man bisher mühsam Dokumente durchsuchen musste, lassen sich so in Sekunden beantworten.

Wie gut funktioniert das?

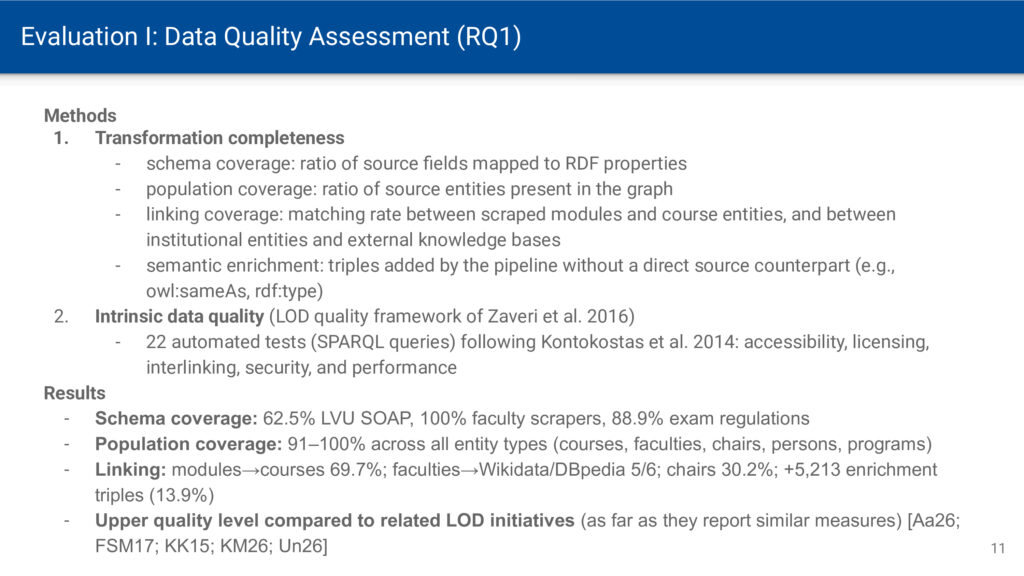
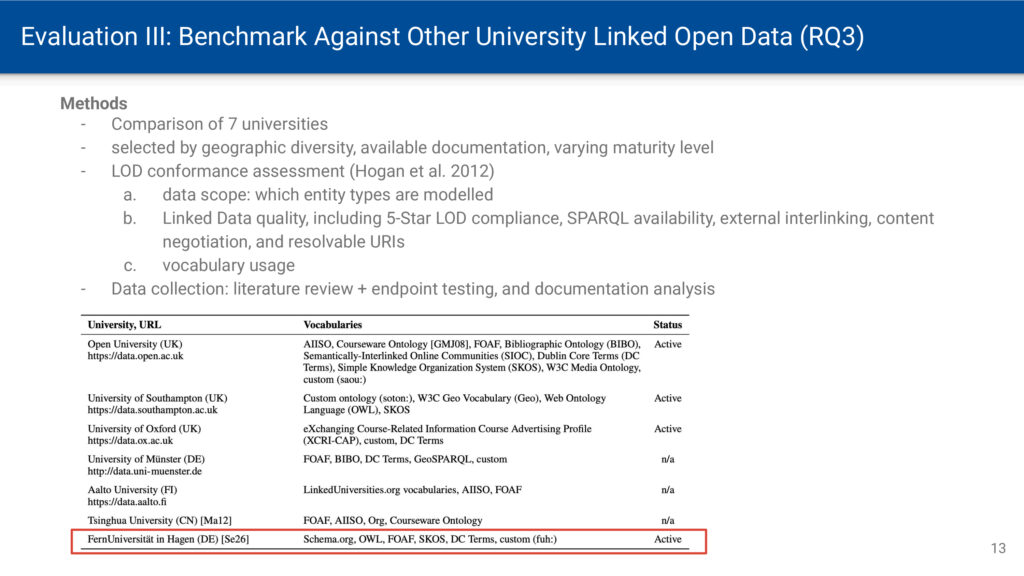
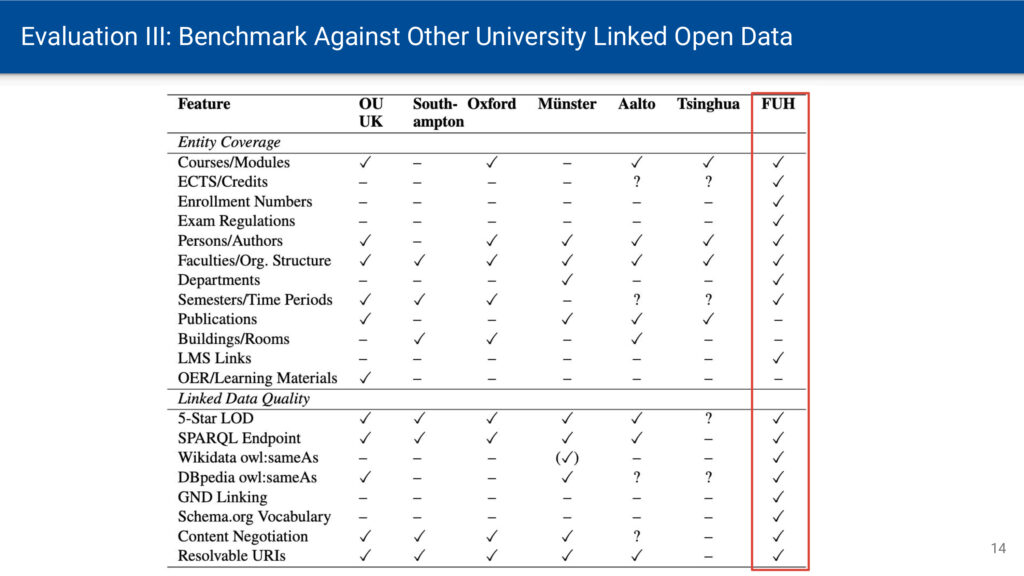
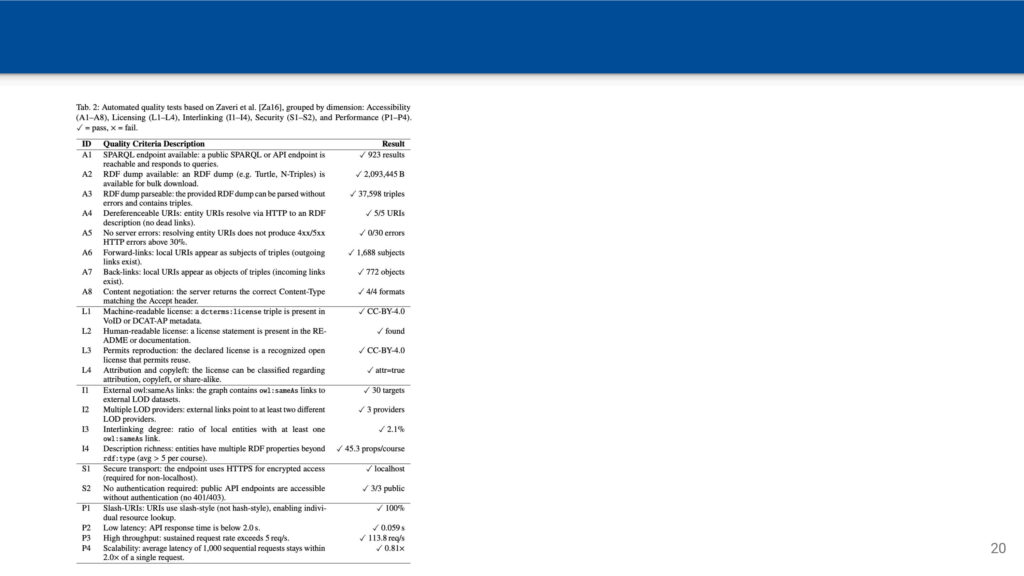
Wir haben die Qualität der Daten geprüft und unseren Ansatz mit sechs etablierten offenen Datenangeboten anderer Hochschulen verglichen. Das Ergebnis zeigt, wie viel ungenutztes Potenzial in offenen Hochschuldaten steckt. Unsere Arbeit soll eine Grundlage dafür sein, dass mehr Hochschulen ihre Strukturen offen und maschinenlesbar bereitstellen.

Vorgestellt haben ich die Arbeit im Best-Paper-Track der DELFI 2026 an der Universität Potsdam. Das Paper und die Software finden Sie hier:
Paper: https://dl.gi.de/handle/20.500.12116/49137
Software-Paper: https://dl.gi.de/handle/20.500.12116/49162

Um die Vortragsfolien zu betrachten, genügt ein Klick auf eines der Bilder.
Die Temporaluhr: Stunden, die sich an Sonnenauf- und -untergang anpassen

Wenn am Wochenende oder im Urlaub zeitliche Verpflichtungen durch Arbeit und Schule wegfallen, kann man sich zeitlich freier entfalten. Der Sonnenauf- und -untergang bleibt jedoch als Determinante von Hell und Dunkel bestehen. Zur Sonnenwende ist dieser Gegensatz umso deutlicher, je weiter man vom Äquator entfernt ist. Die Zeitmessung mittels Atomuhren bedingt eine gleichbleibende Dauer von Sekunden, Minuten und Stunden. Zeit vergeht dabei vollkommen gleichförmig und ohne äußere Einflüsse – eine notwendige Voraussetzung für astronomische Zeitmessung. Für Menschen, die sich an Tages- und Nachtrhythmen orientieren, ist diese Gleichförmigkeit jedoch eine künstliche Abstraktion, die der natürlichen Wahrnehmung von Zeit widerspricht.

Noch bevor sich astronomisch genaue Uhren durchsetzten, wendeten Mönche eine an die Sonnenbewegung angepasste Zeitmessung an. Ein Tag entsprach zwar 24 Stunden, doch wurden die 12 Tagesstunden (vom Sonnenaufgang bis zum Sonnenuntergang) und die 12 Nachtstunden (vom Sonnenuntergang bis zum Sonnenaufgang) jeweils in gleich lange Abschnitte geteilt. Da die Länge von Tag und Nacht je nach Jahreszeit variiert, waren diese Stunden unterschiedlich lang – man bezeichnet sie als Temporal-Stunde.

Im Winter sind die nächtlichen Temporalstunden länger als die Temporalstunden am Tage. Im Sommer ist es umgekehrt. Nur zur Tag-Nacht-Gleiche, d.h. am 21. März und 21. September, sind die Temporalstunden tags und nachts gleich lang und entsprechen der Dauer einer astronomischen Stunde.

Temporalzeit bestimmen

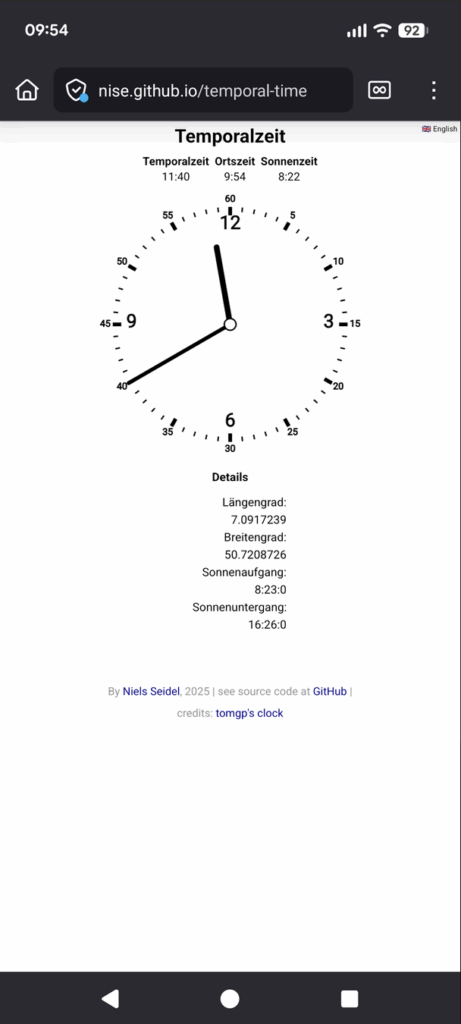
Um sich eine solche Uhr besser vorstellen zu können, habe ich eine Anwendung programmiert. Für die Berechnung der Temporalzeit wird zunächst die geografische Position und in Folge die Zeiten für Sonnenauf- und Untergang bestimmt. Anschließend werden die Zeitintervalle zwischen dem Auf- und Untergang in 12 gleich große Abschnitte unterteilt. Die in Stunden und Minuten umgerechneten Intervalle werden im Dezimalformat und auf dem Ziffernblatt ausgegeben.

Die Anwendung ist als Webseite verfügbar und kann als WebApp auf dem Smartphone installiert werden: https://nise.github.io/temporal-time/

Wie lebt man nach der Temporalzeit?

Wie würde sich ein Leben nach der Temporaluhr auf unser Zeitempfinden und Wohlbefinden auswirken? Vermutlich würden typische Tagesaktivitäten subjektiv schneller vergehen. Ein achtstündiger Arbeitstag wäre im Winter tatsächlich kürzer und im Sommer länger als die mechanische Uhr anzeigt. Winterliche Tage ließen mehr Raum für Ruhe und Schlaf, während der Sommer noch ausgedehntere Tage und kürzere Nächte brächte – eine Betonung natürlicher Jahresrhythmen. Erstaunlicherweise fehlen zu dieser Frage wissenschaftliche Untersuchungen. Zwar erforscht die Chronobiologie die Auswirkungen verschiedener Schlafmuster und des durch Zeitumstellungen oder soziale Zwänge verursachten Jetlags, doch die gleichförmige Zeit als solche wurde noch nicht grundsätzlich infrage gestellt.

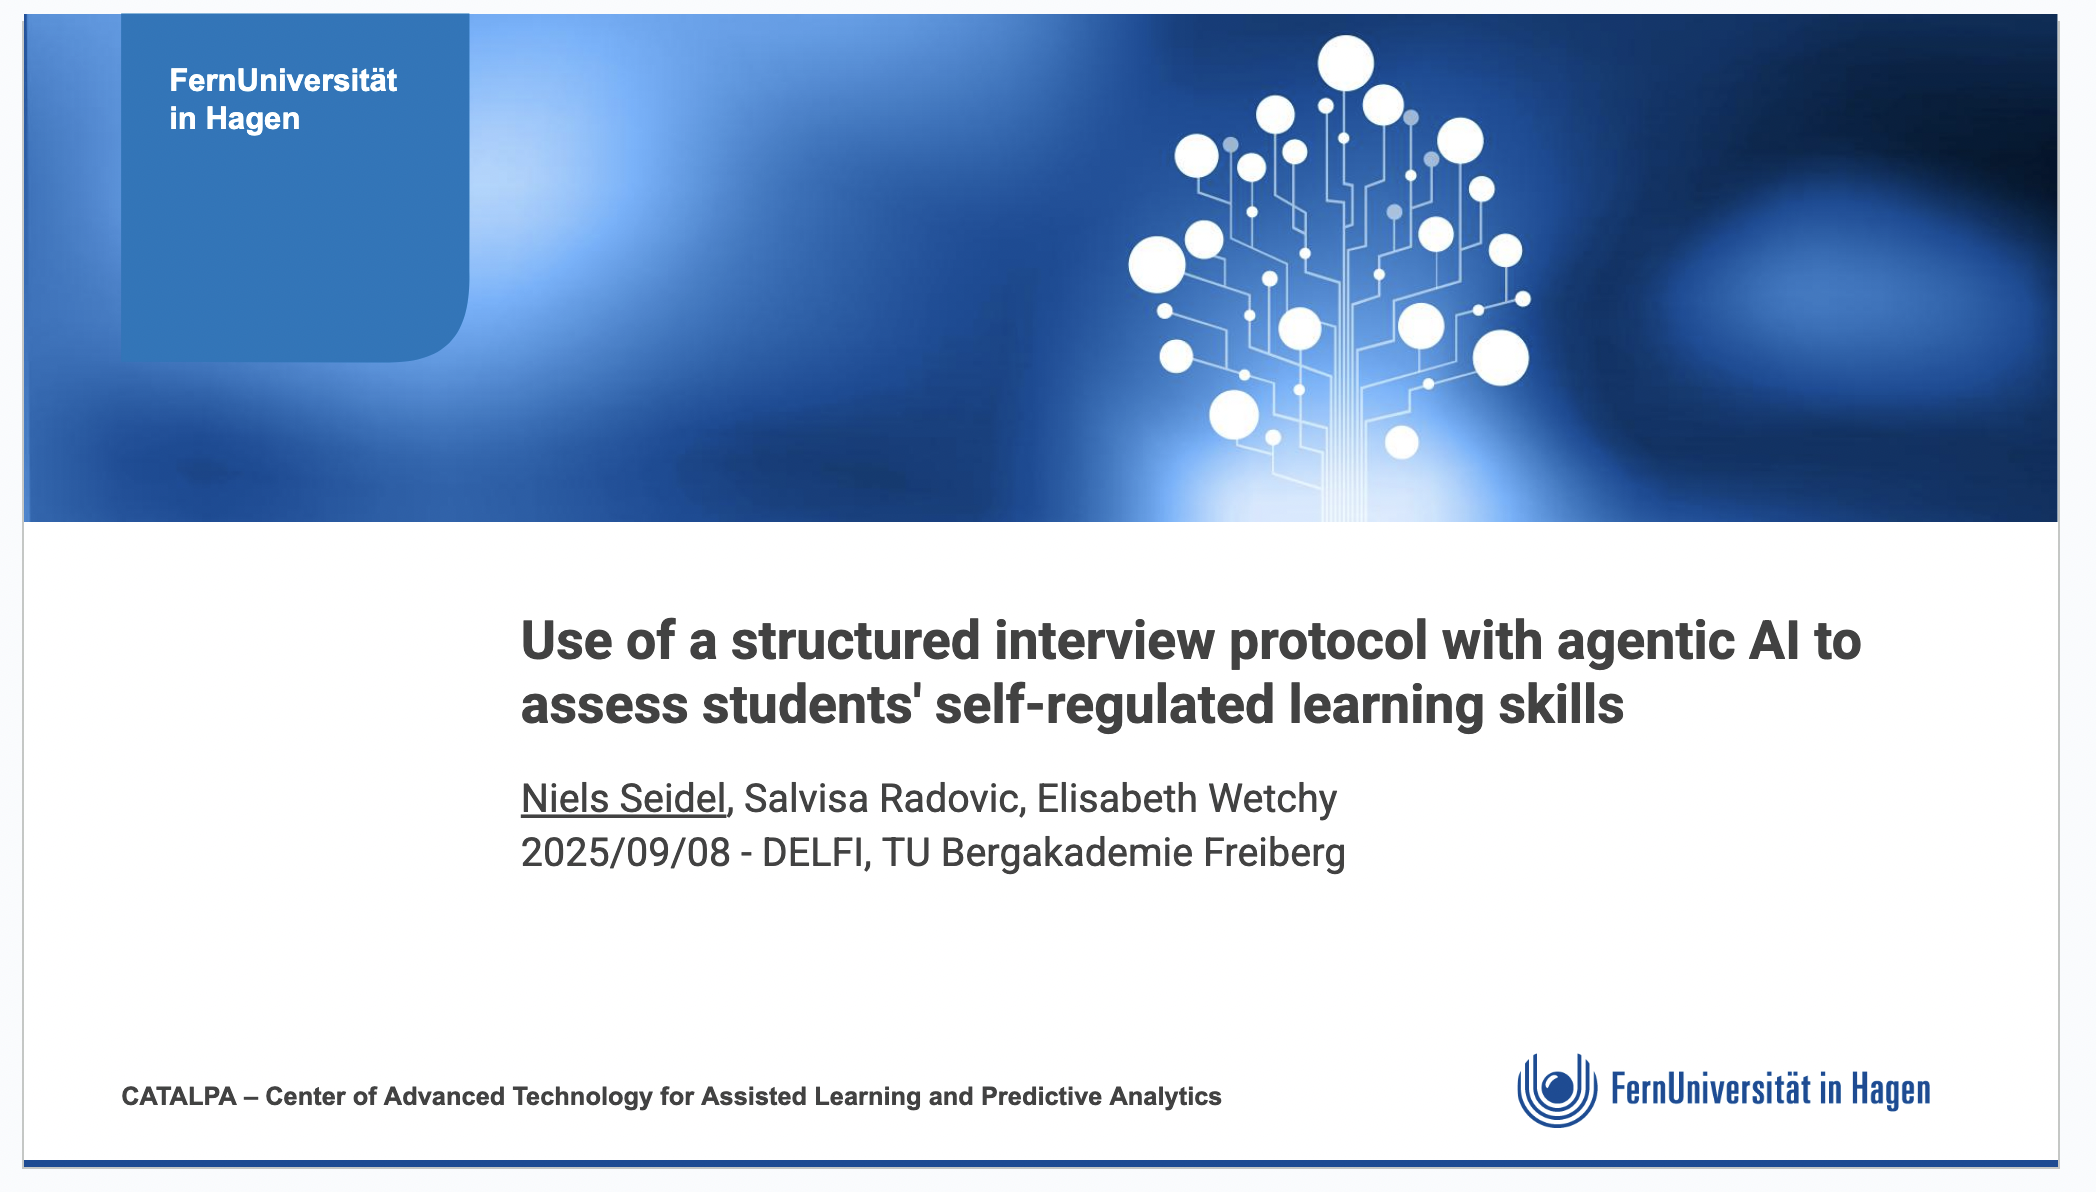
Talk: Use of a structured interview protocol with agentic AI to assess students’ self-regulated learning skills

Ever tried conducting interviews for research? It’s incredibly time-consuming, which is why most researchers avoid them in fields like Learning Analytics, where data from hundreds of students is needed.
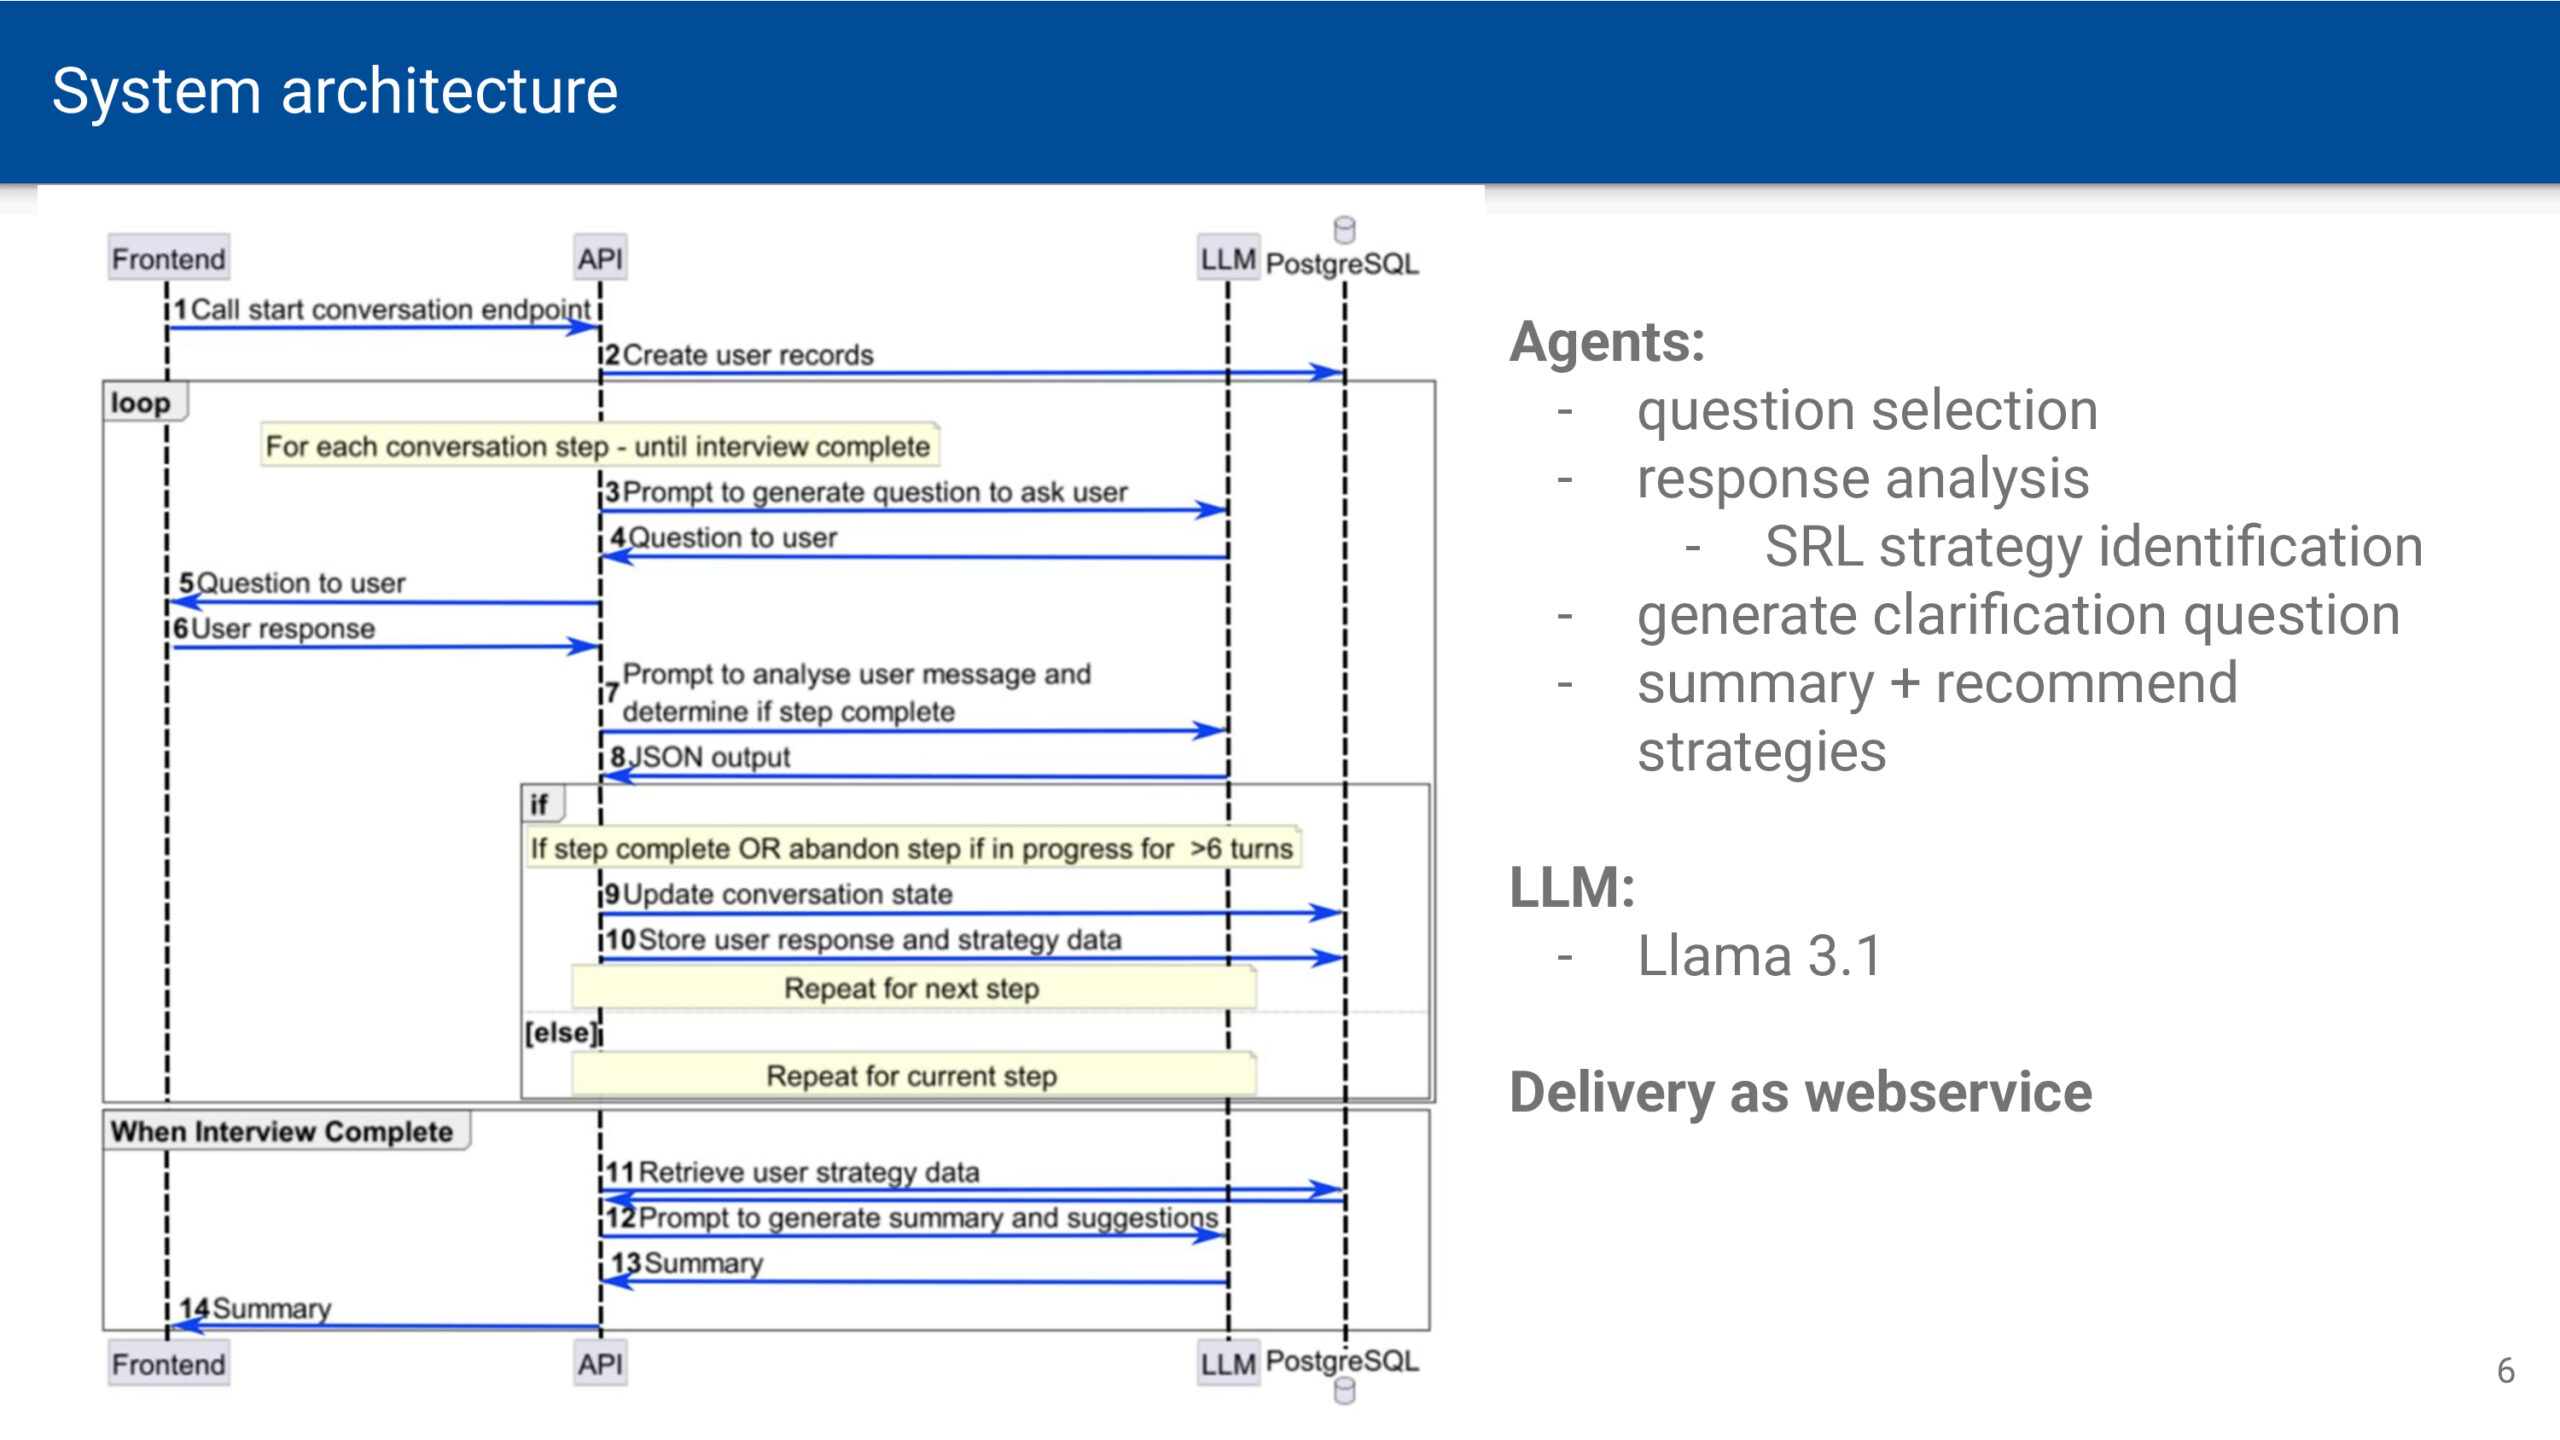
We built an AI agent that conducts structured interviews at scale. It’s patient, polite, and won’t accept vague answers – it keeps digging until it gets complete responses without annoying people.
The agent assesses self-regulated learning skills, gives immediate feedback and recommendations, and delivers consistent, high-quality data without the usual resource constraints. No more choosing between depth and scale.

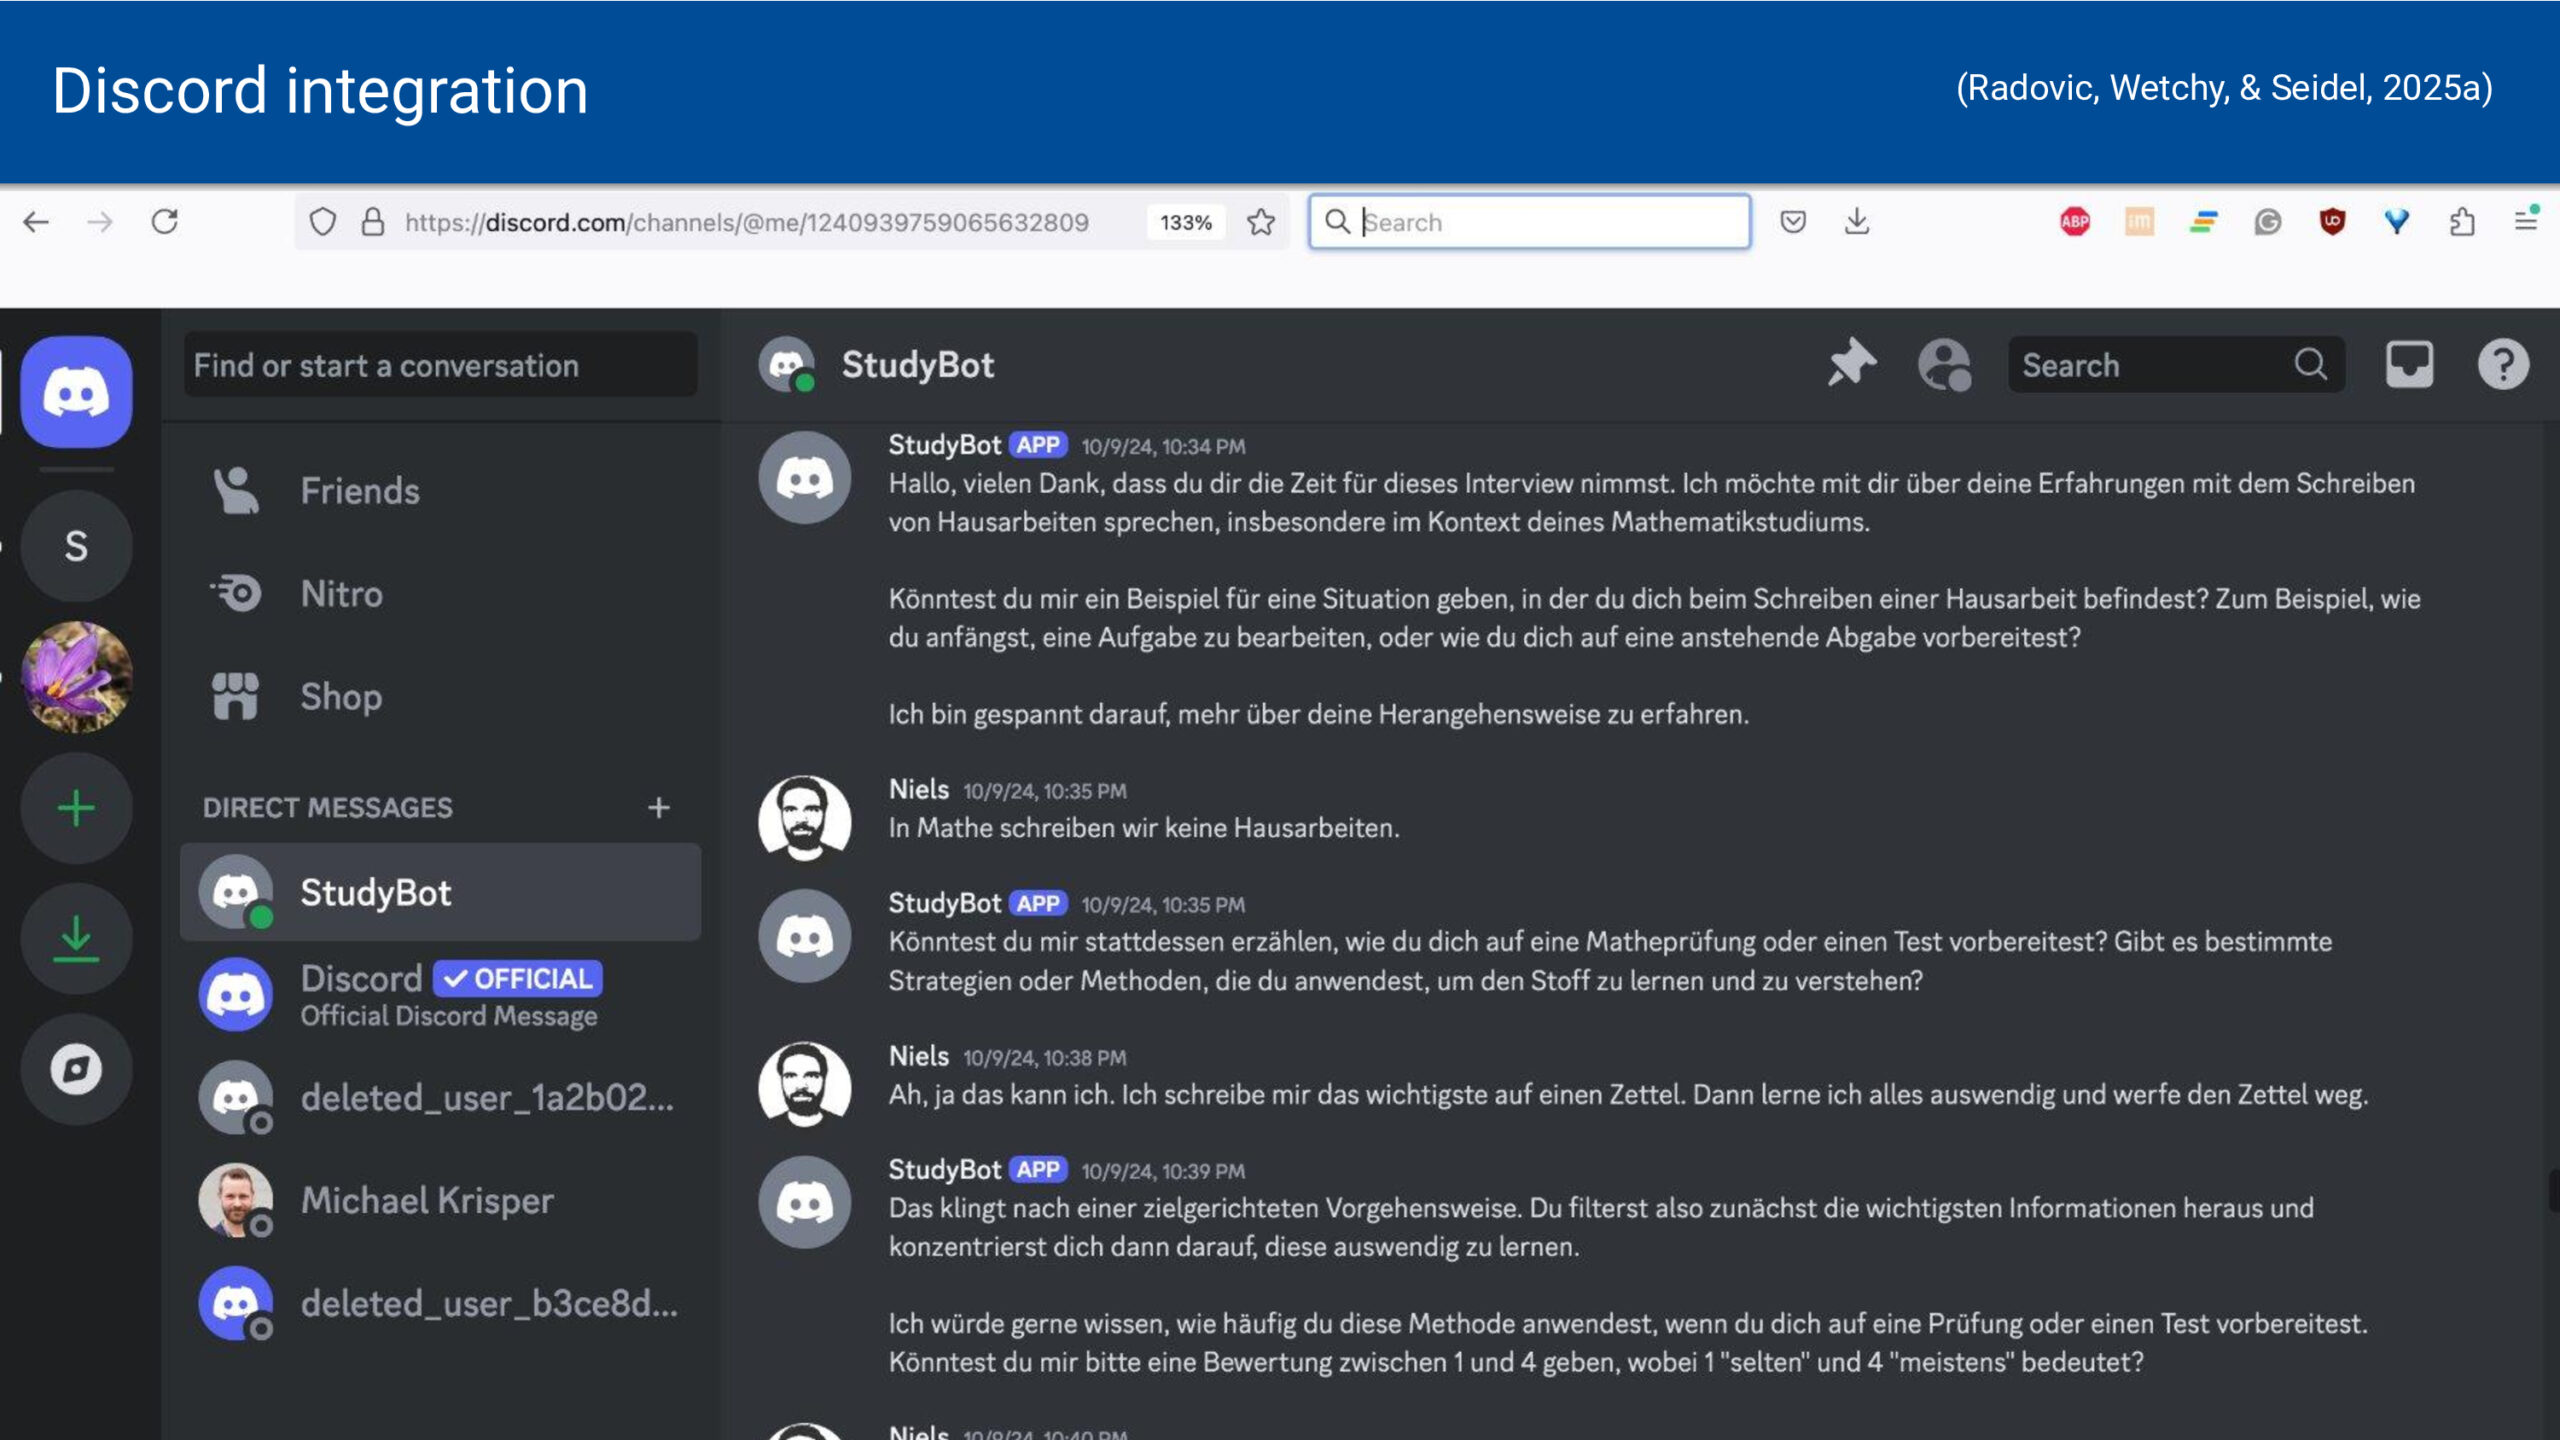
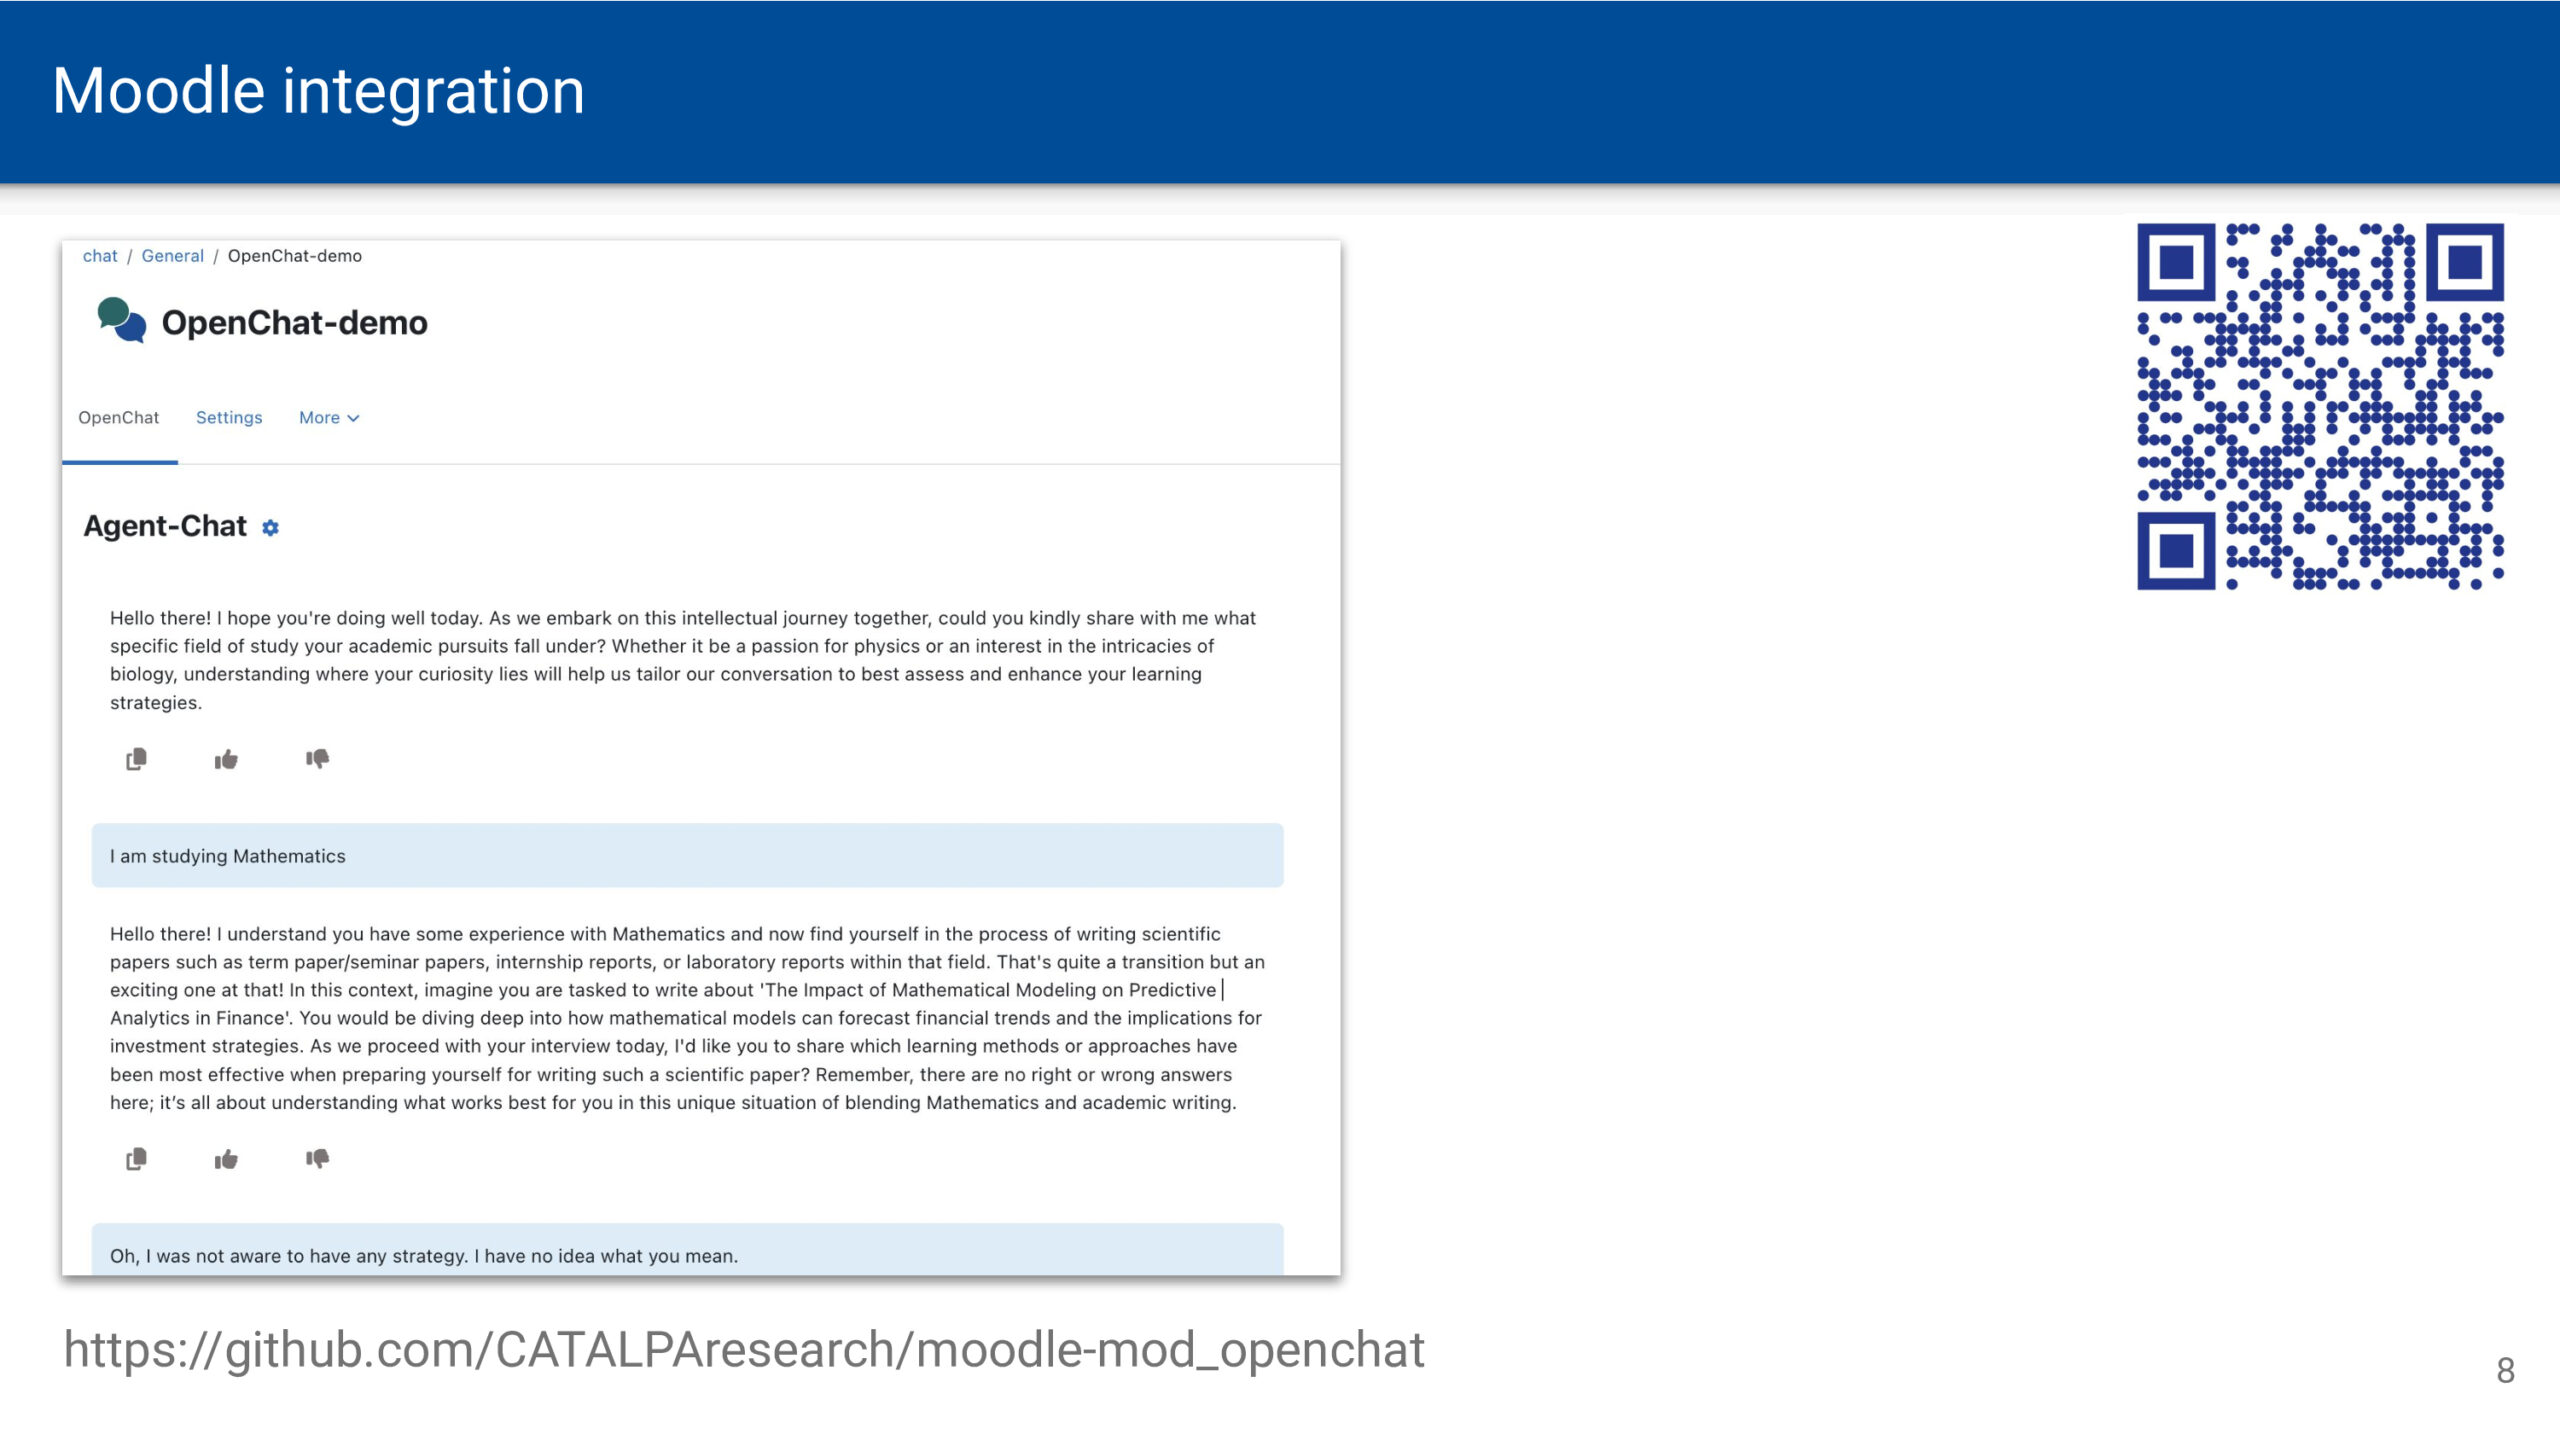
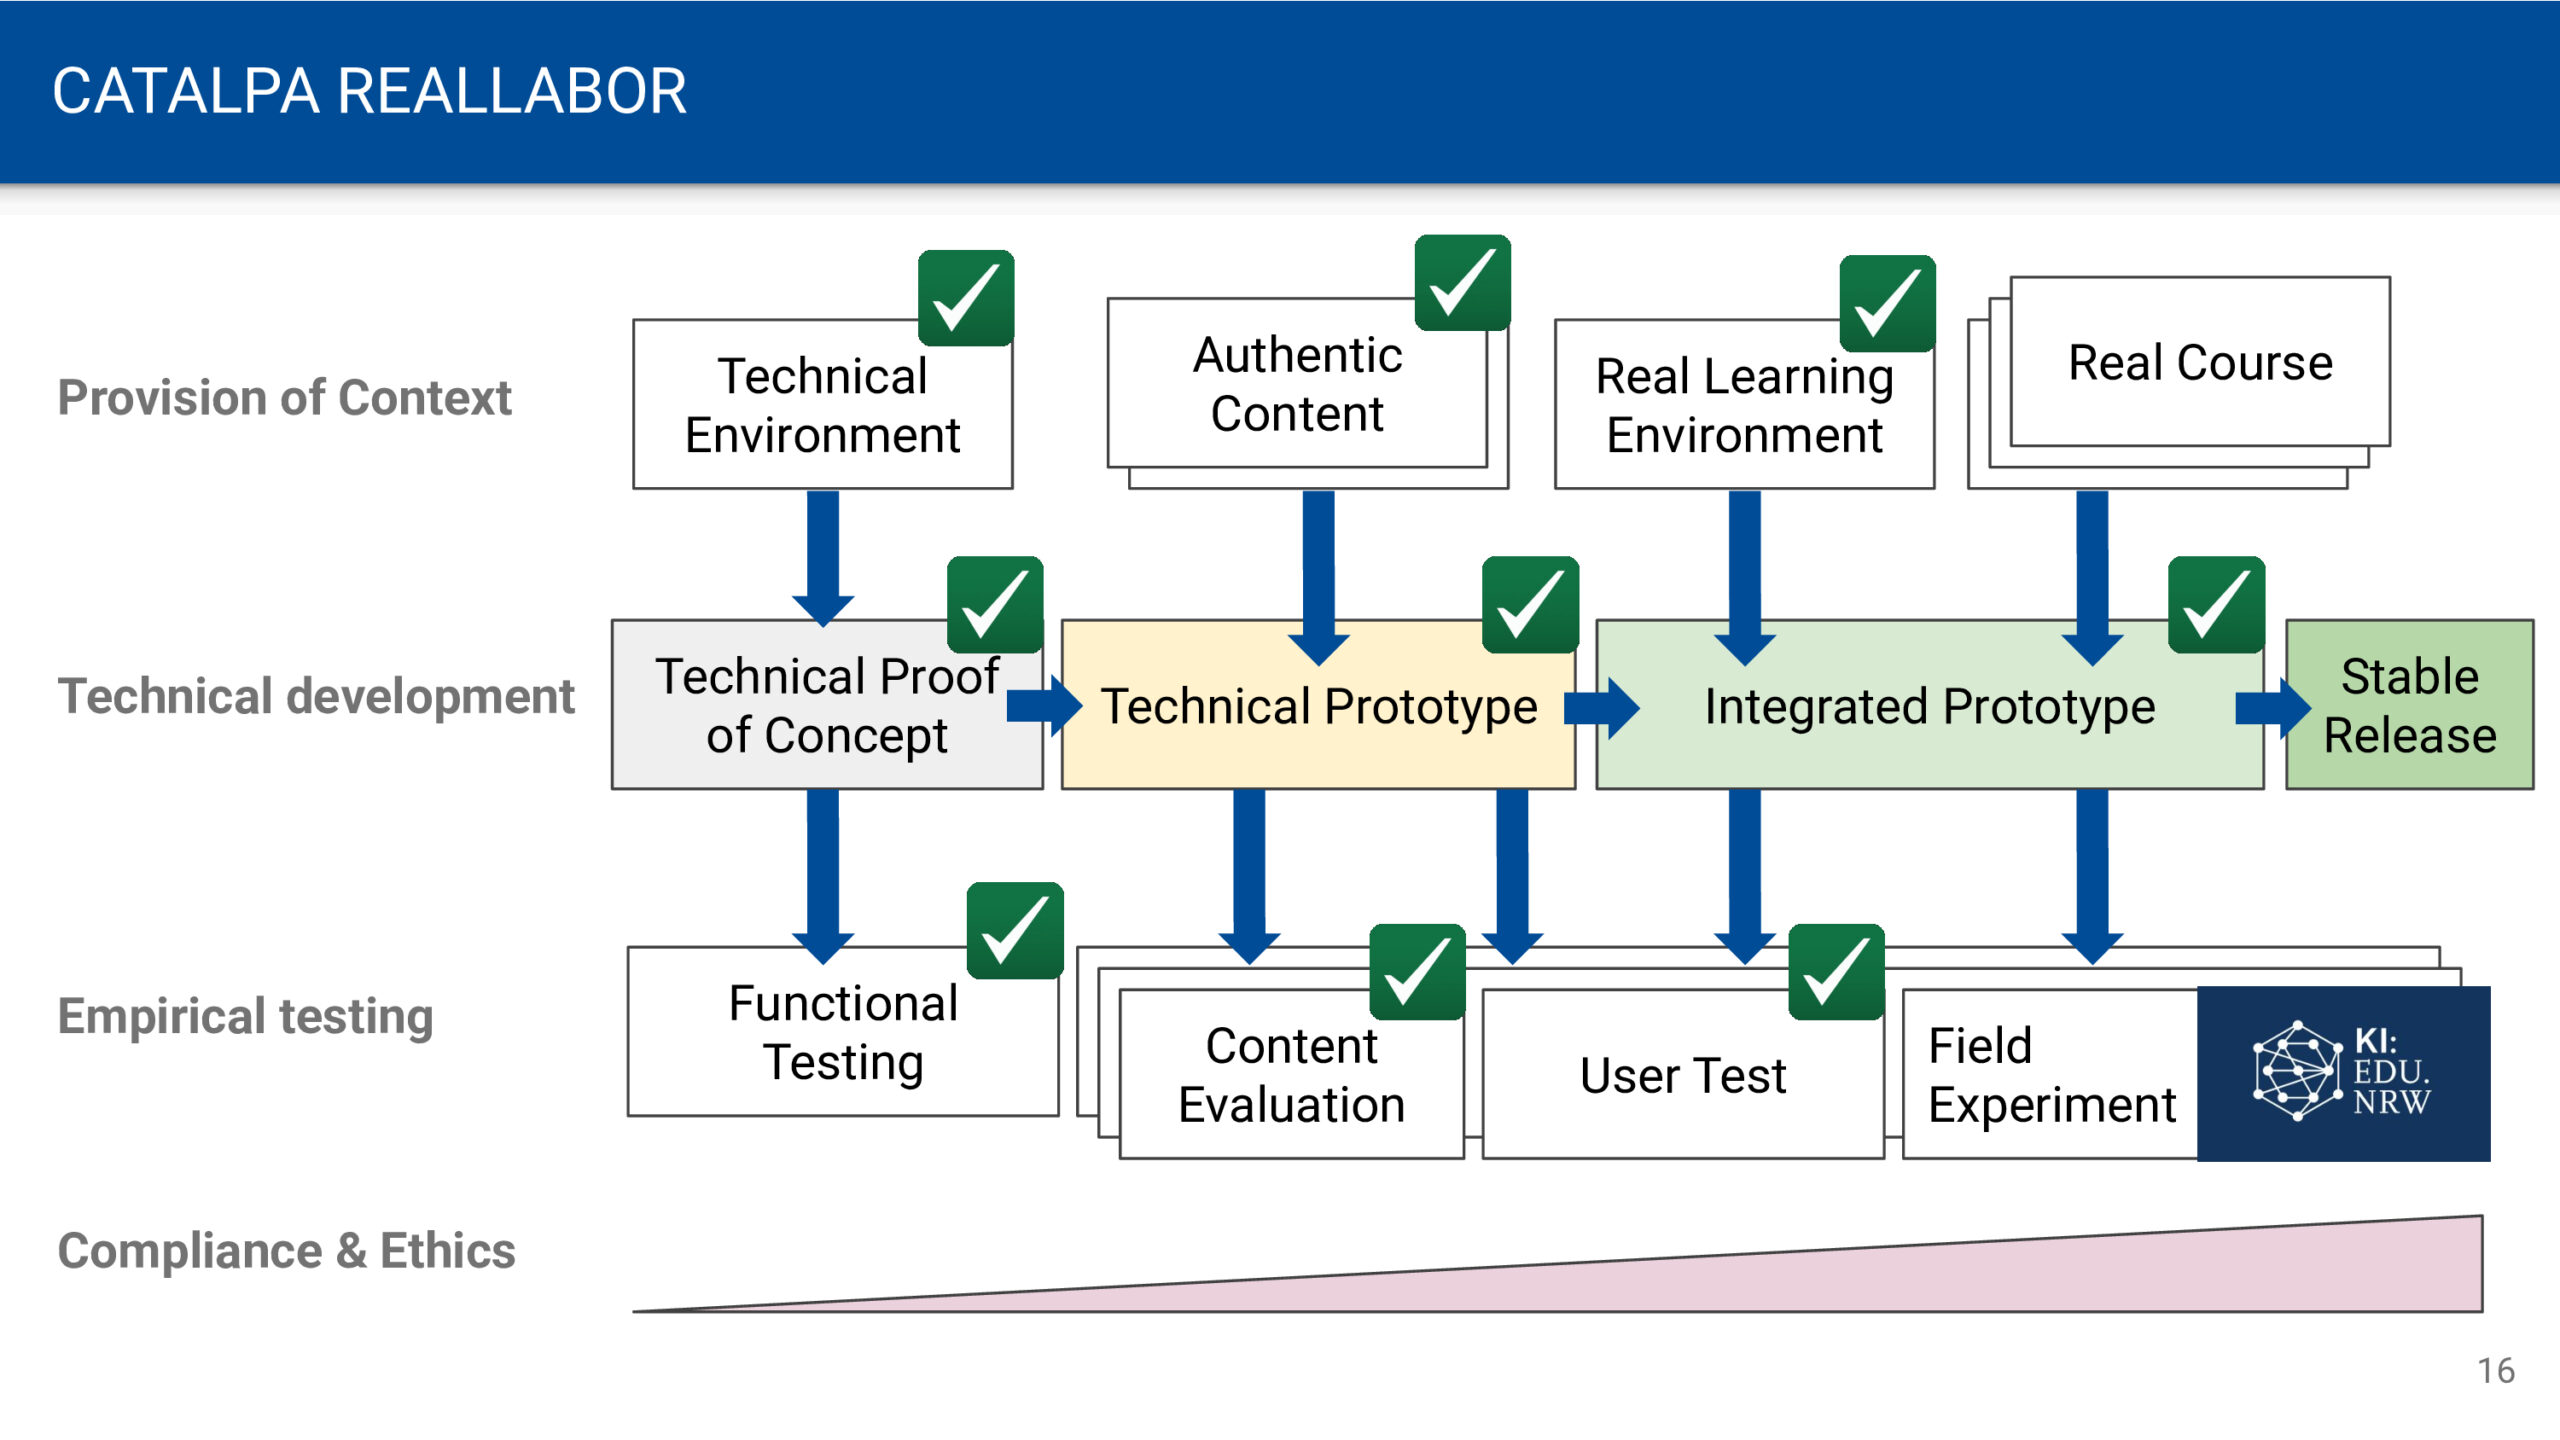
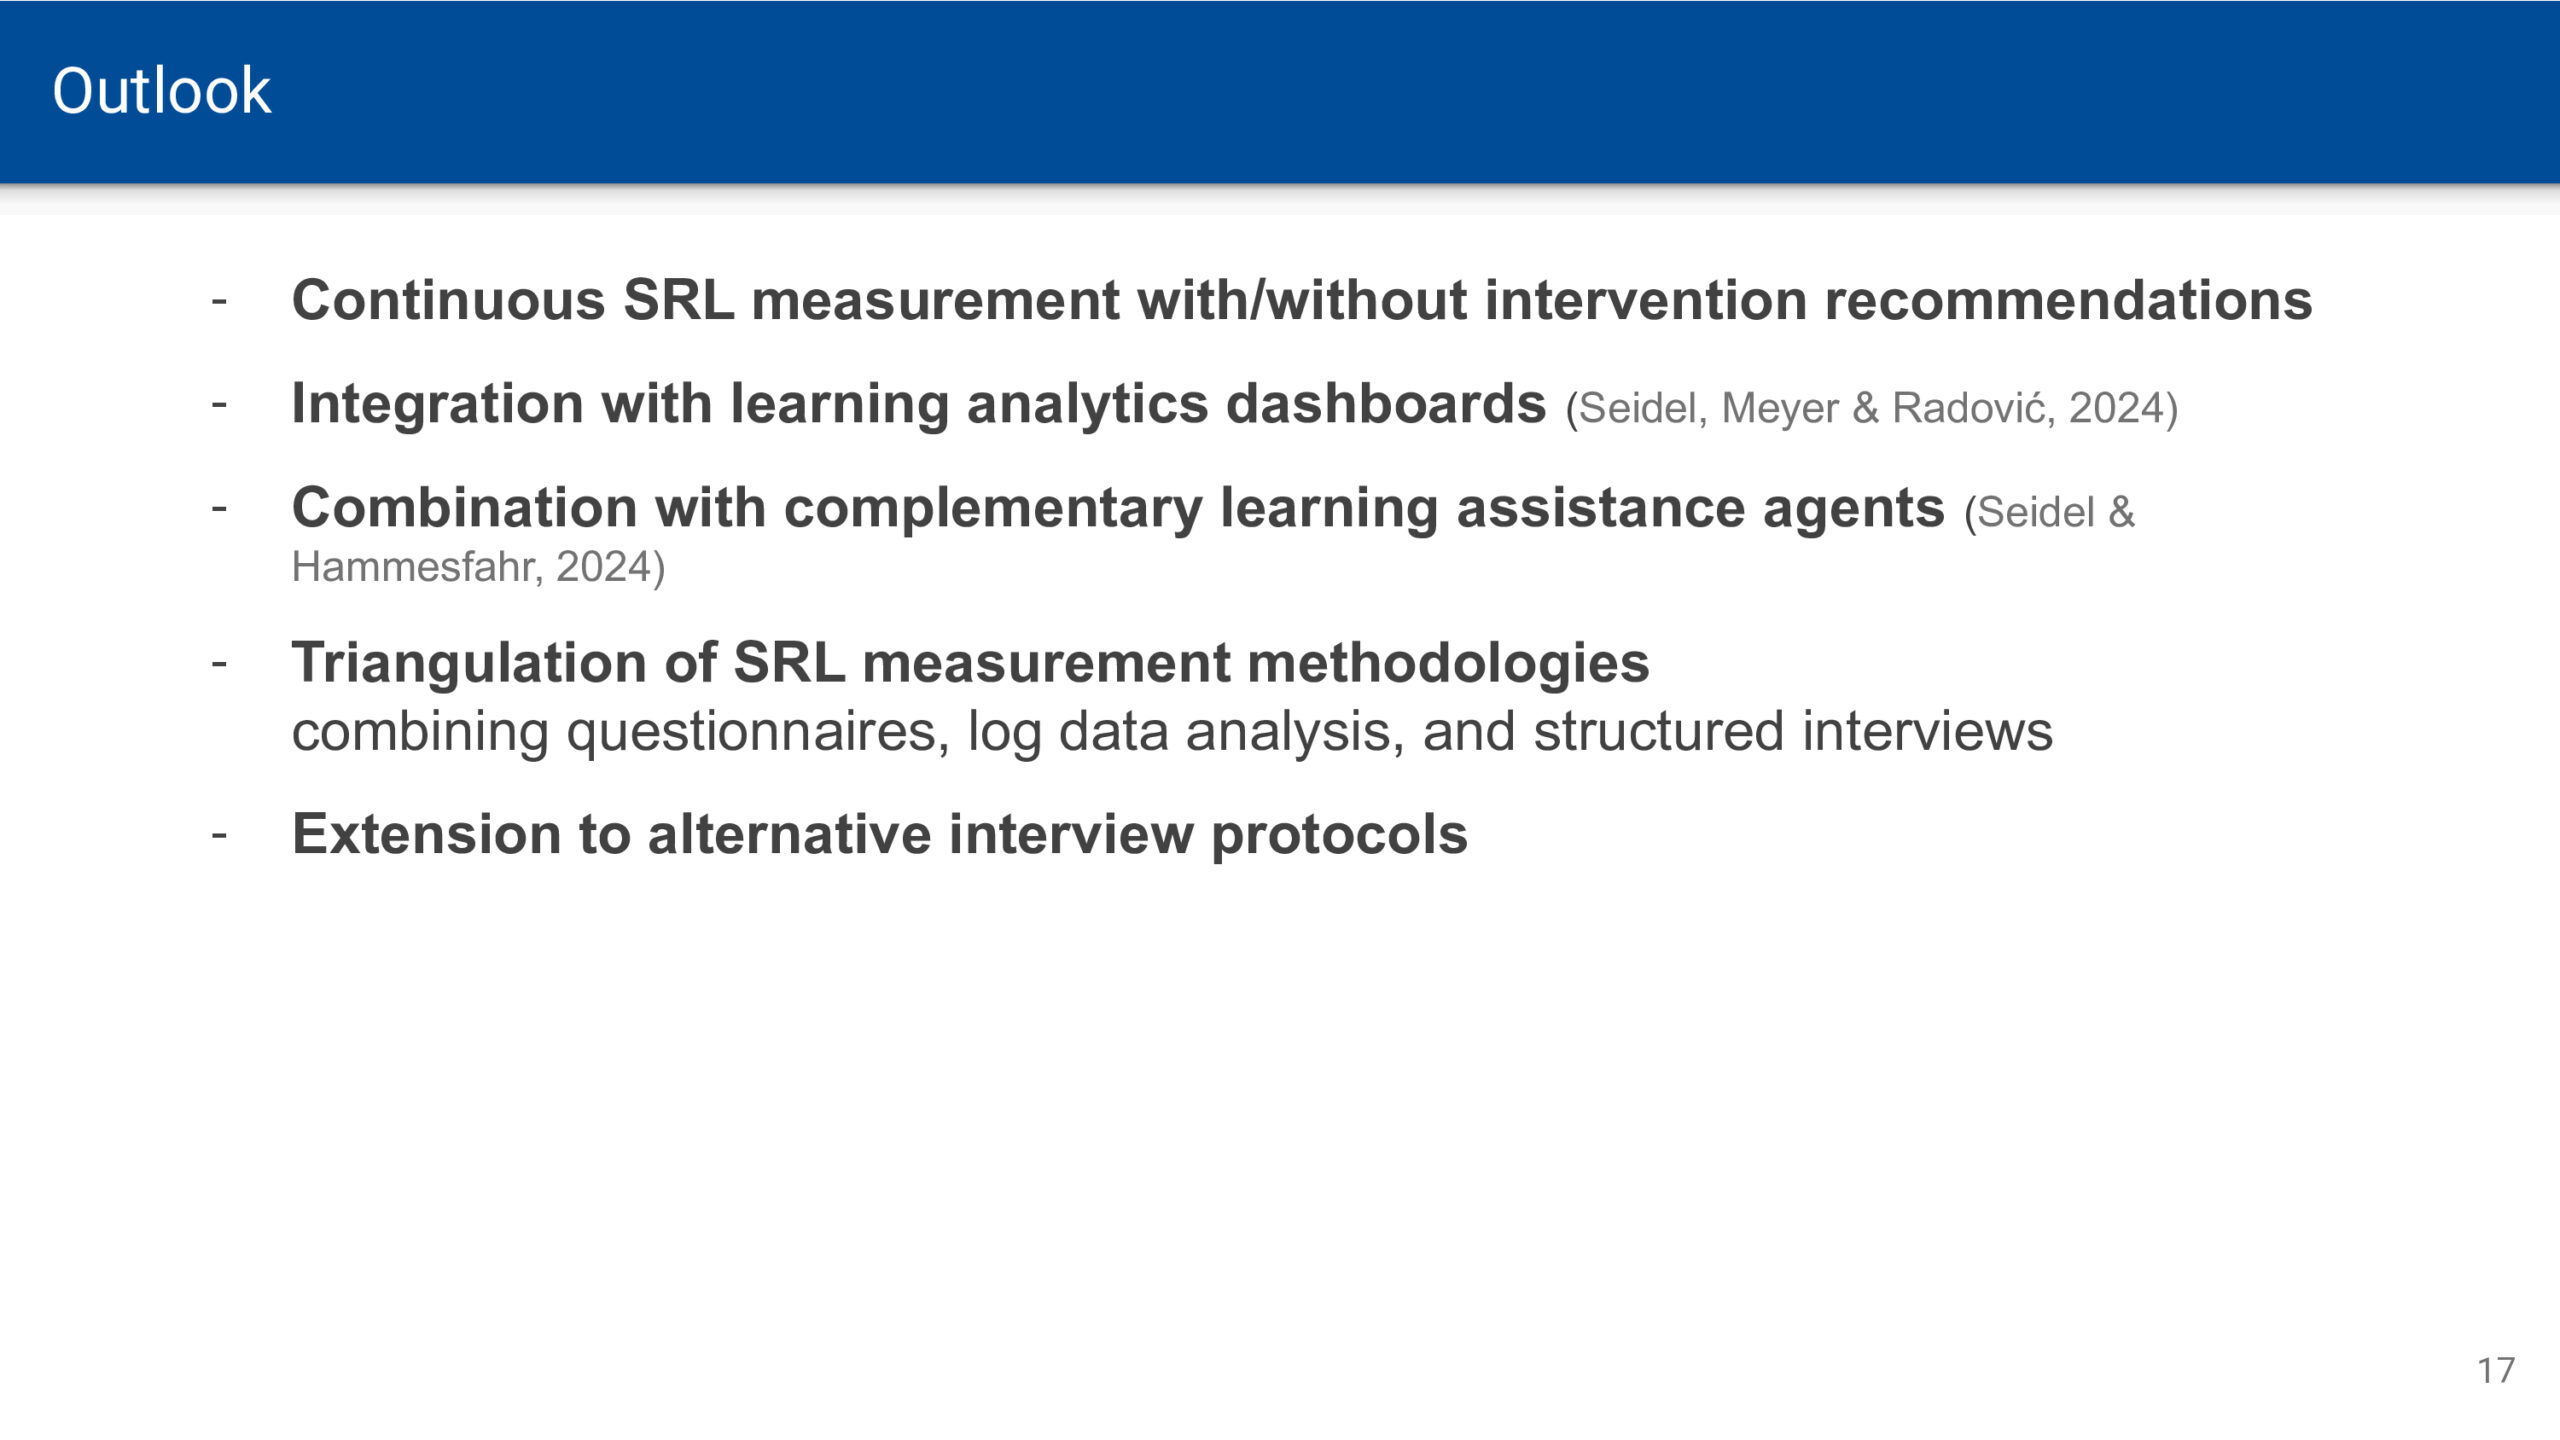
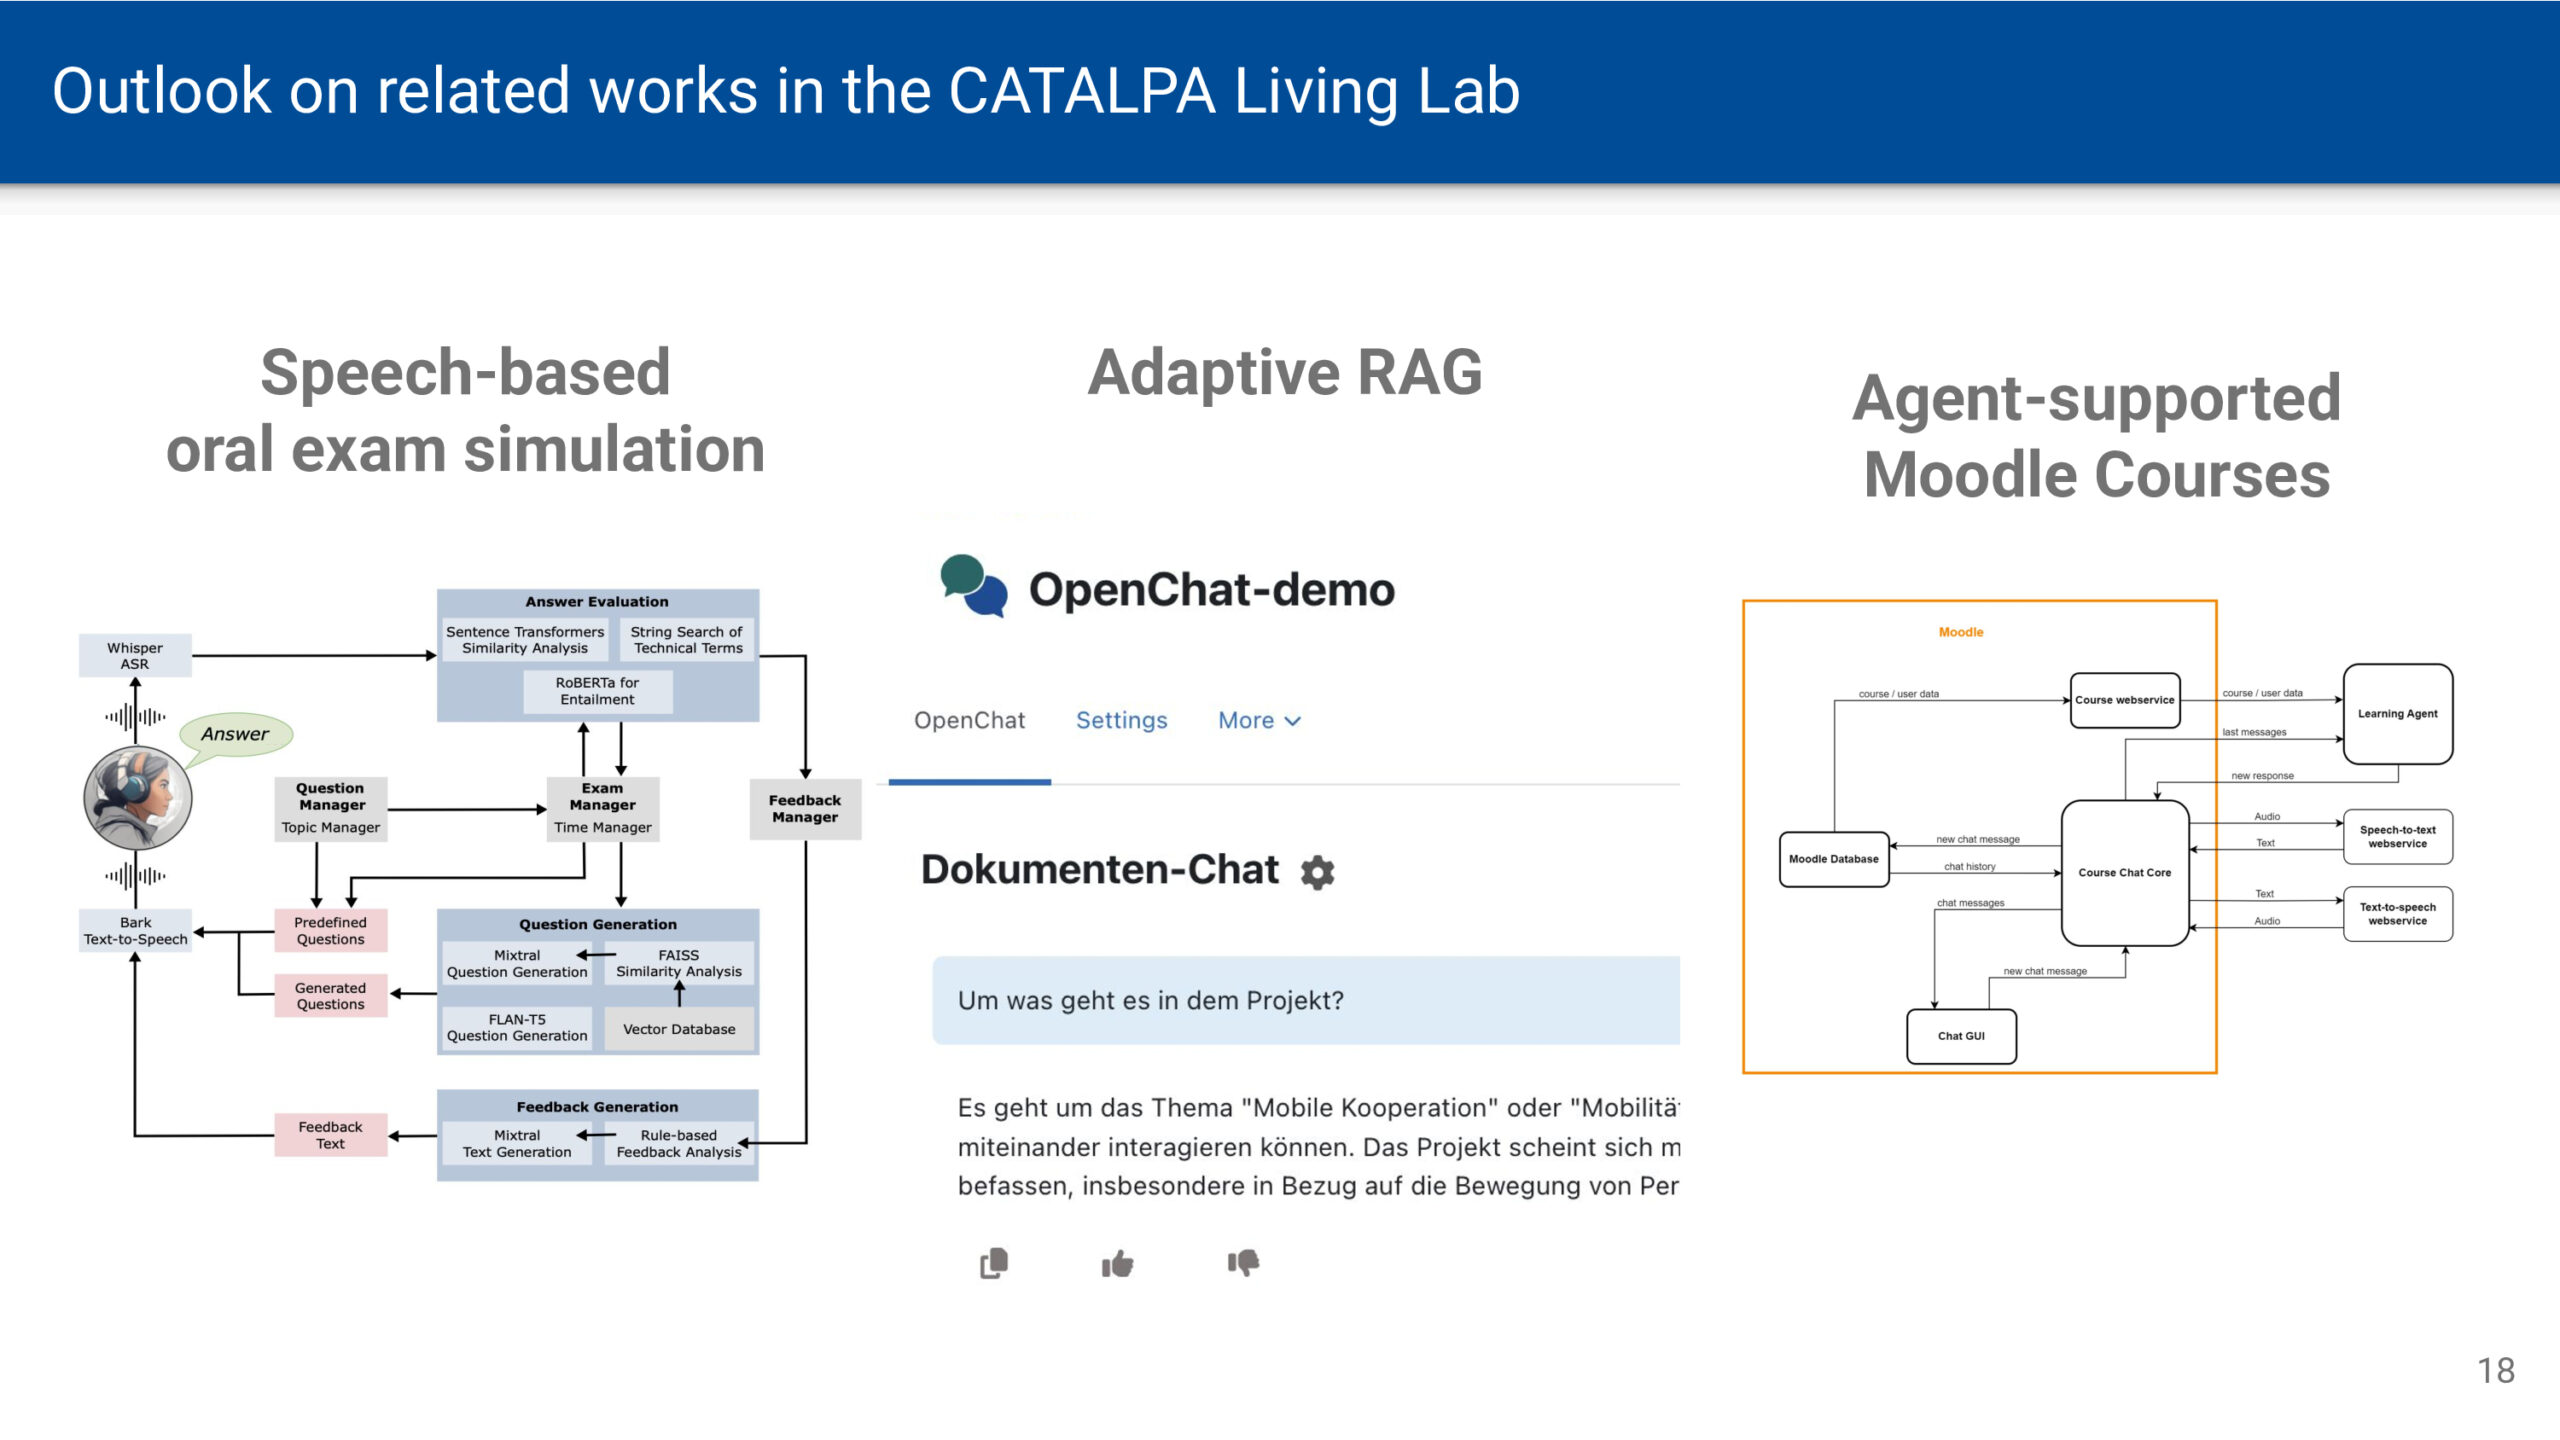
This AI agent can be integrated into Discord and Moodle. Next semester, we will evaluate it in the teaching context at the CATALPA living lab, aka Reallabor.

We have presented didactic/methodological as well as technical features of this multi-agent system at the Learning Analytics Workshop at DELFI in Freiberg.

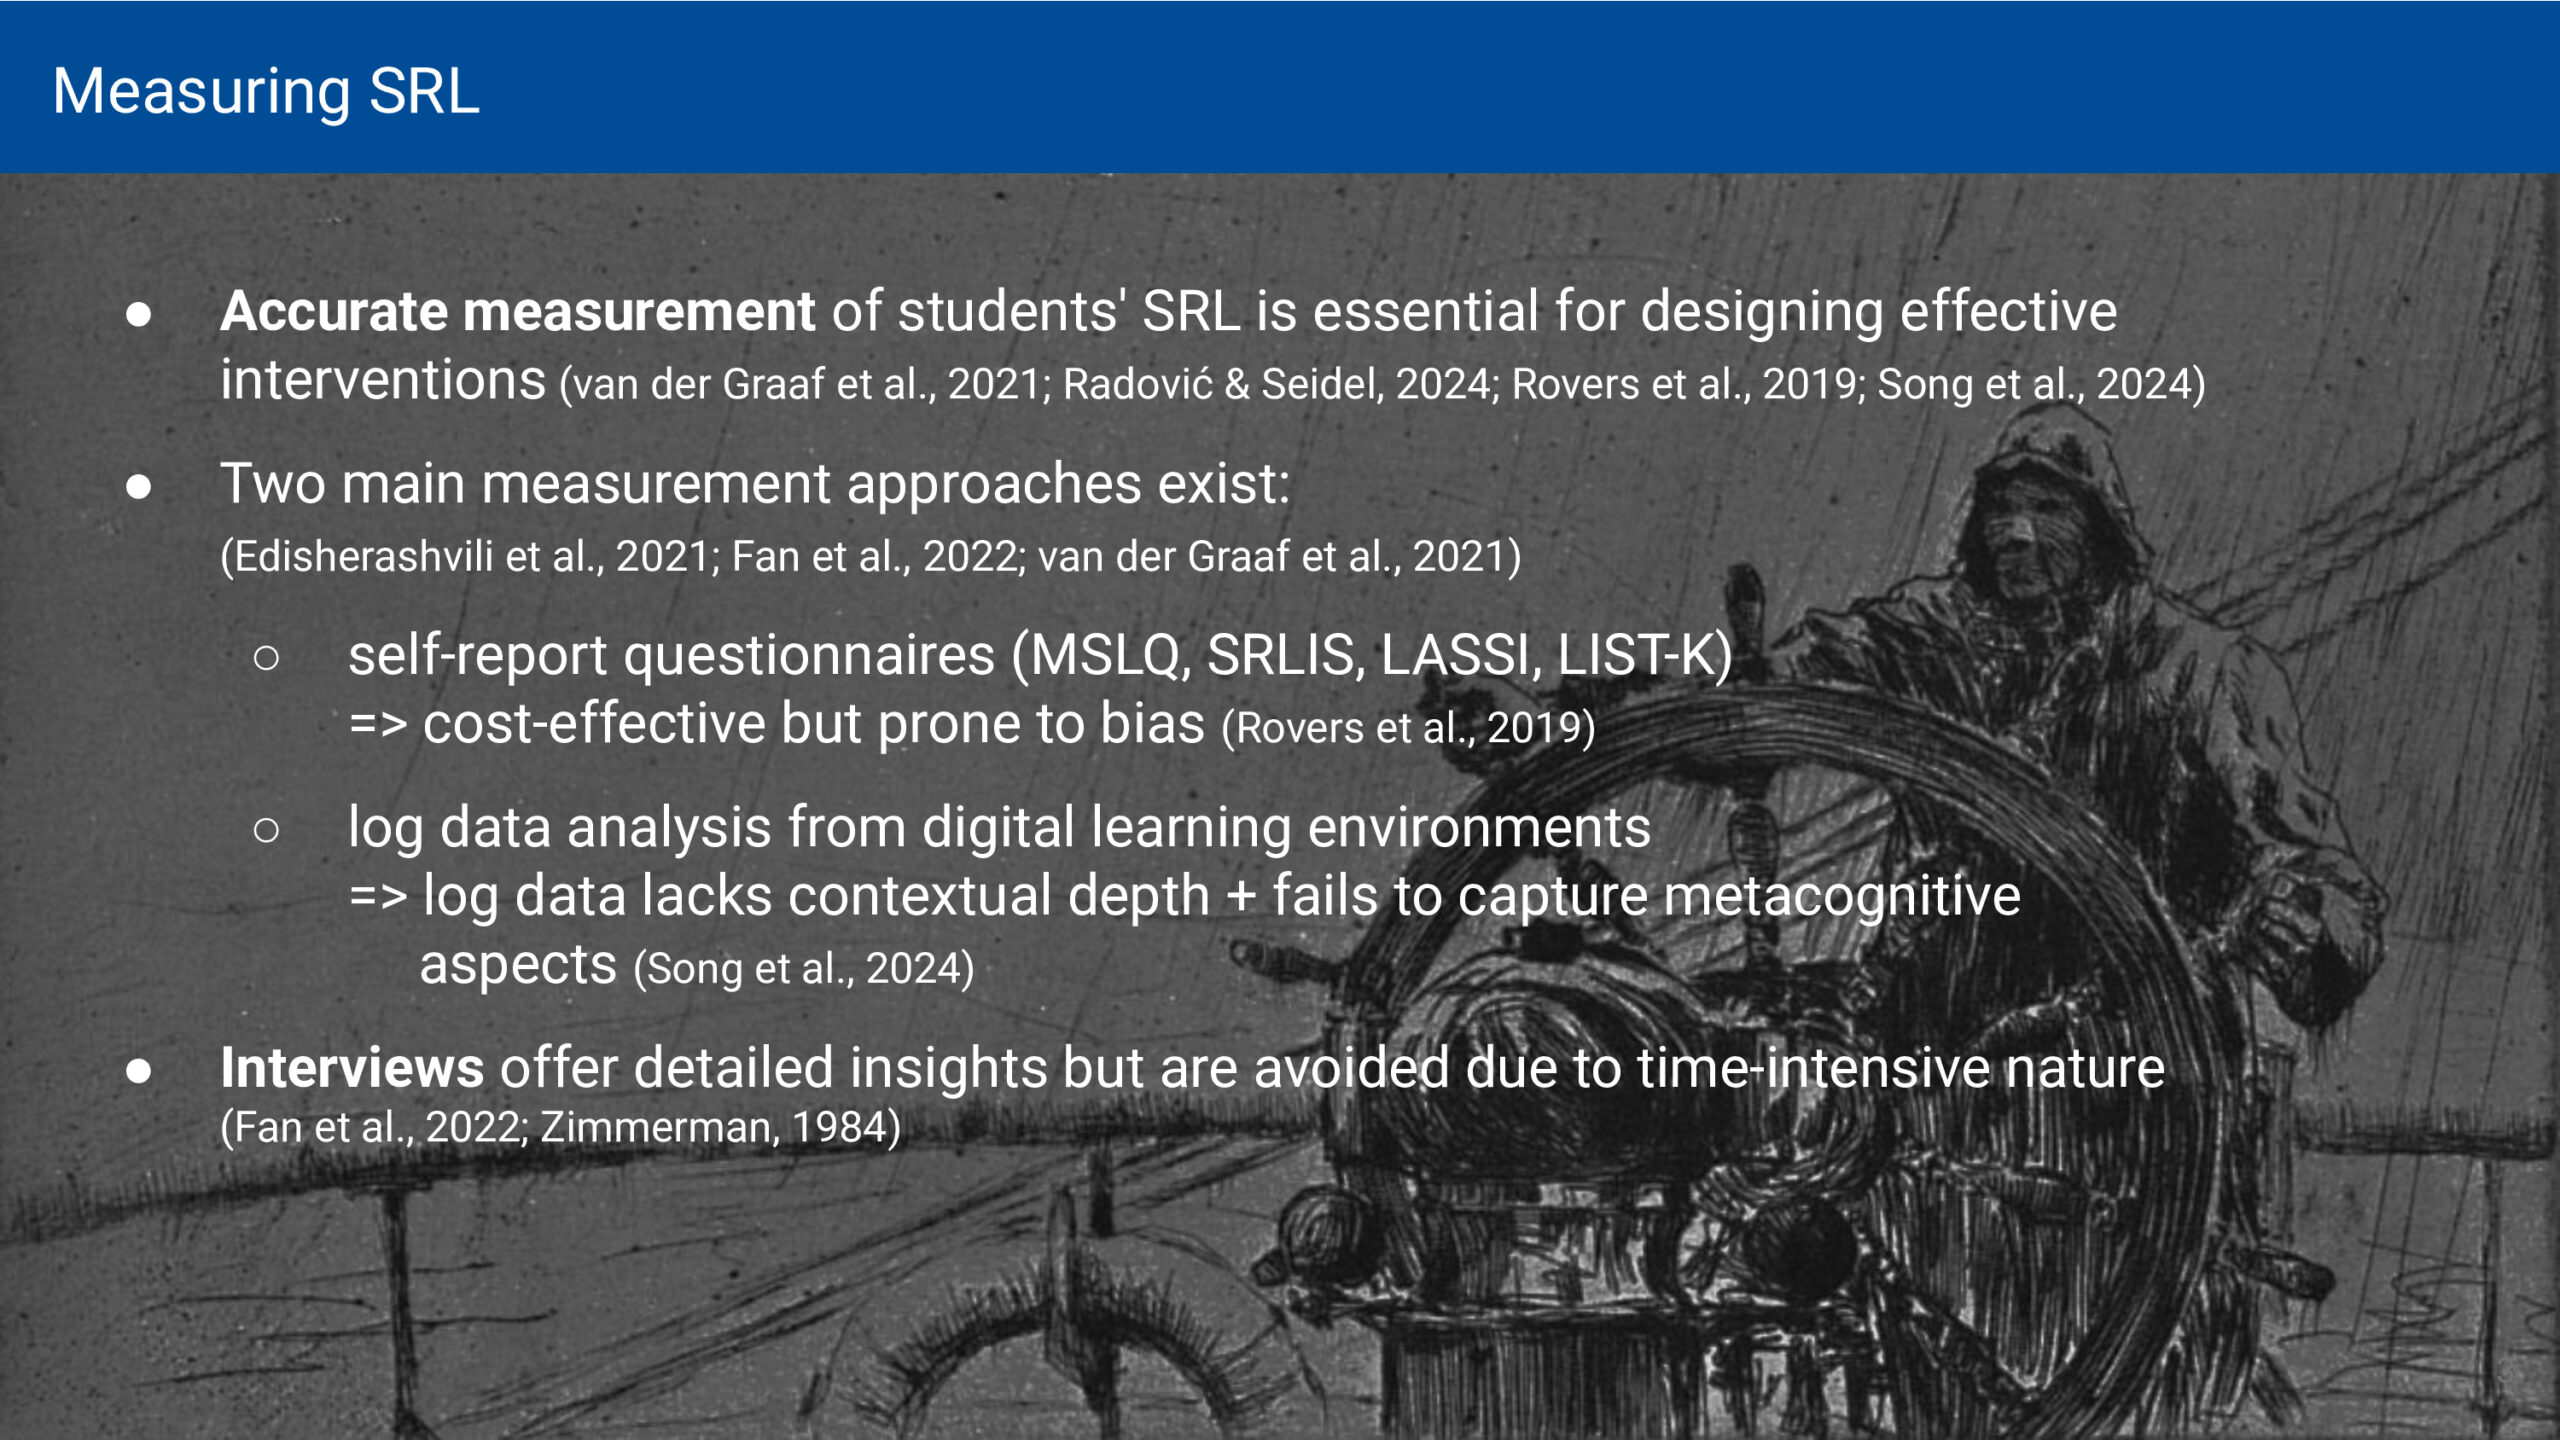
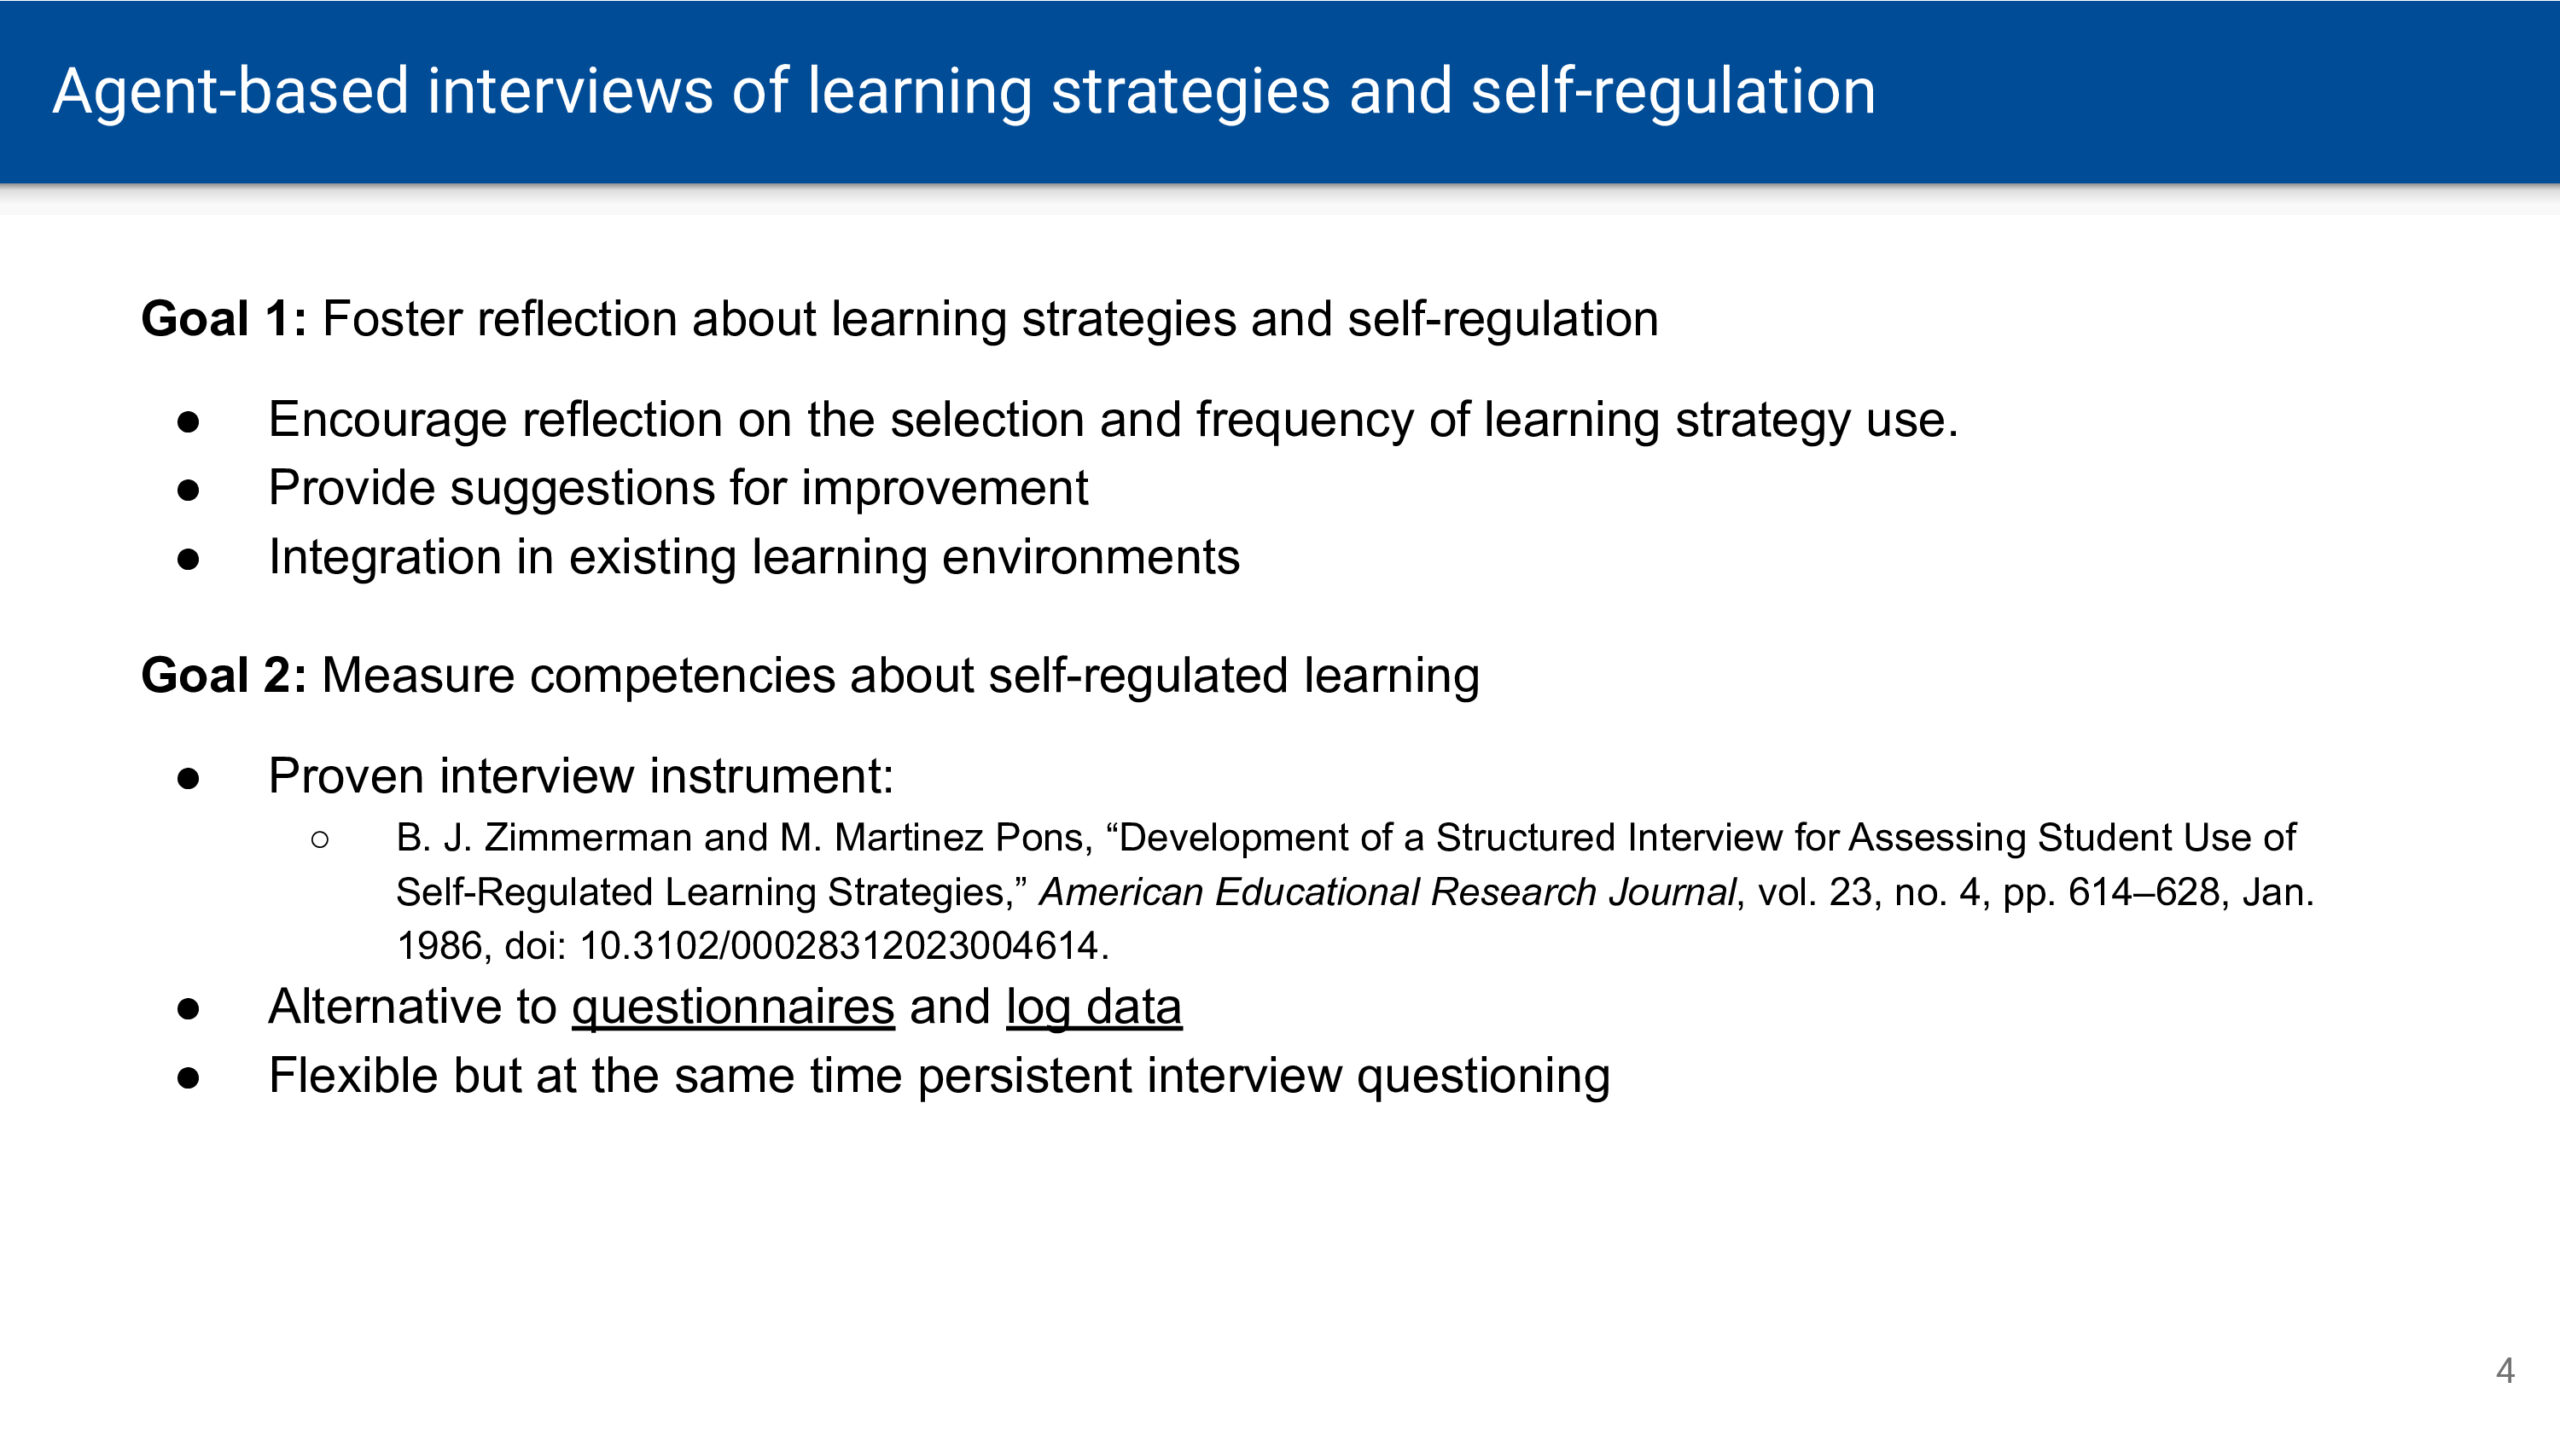
Learning AID: Der Interview-Agent zur Erfassung des selbstregulierten Lernens (SRL)

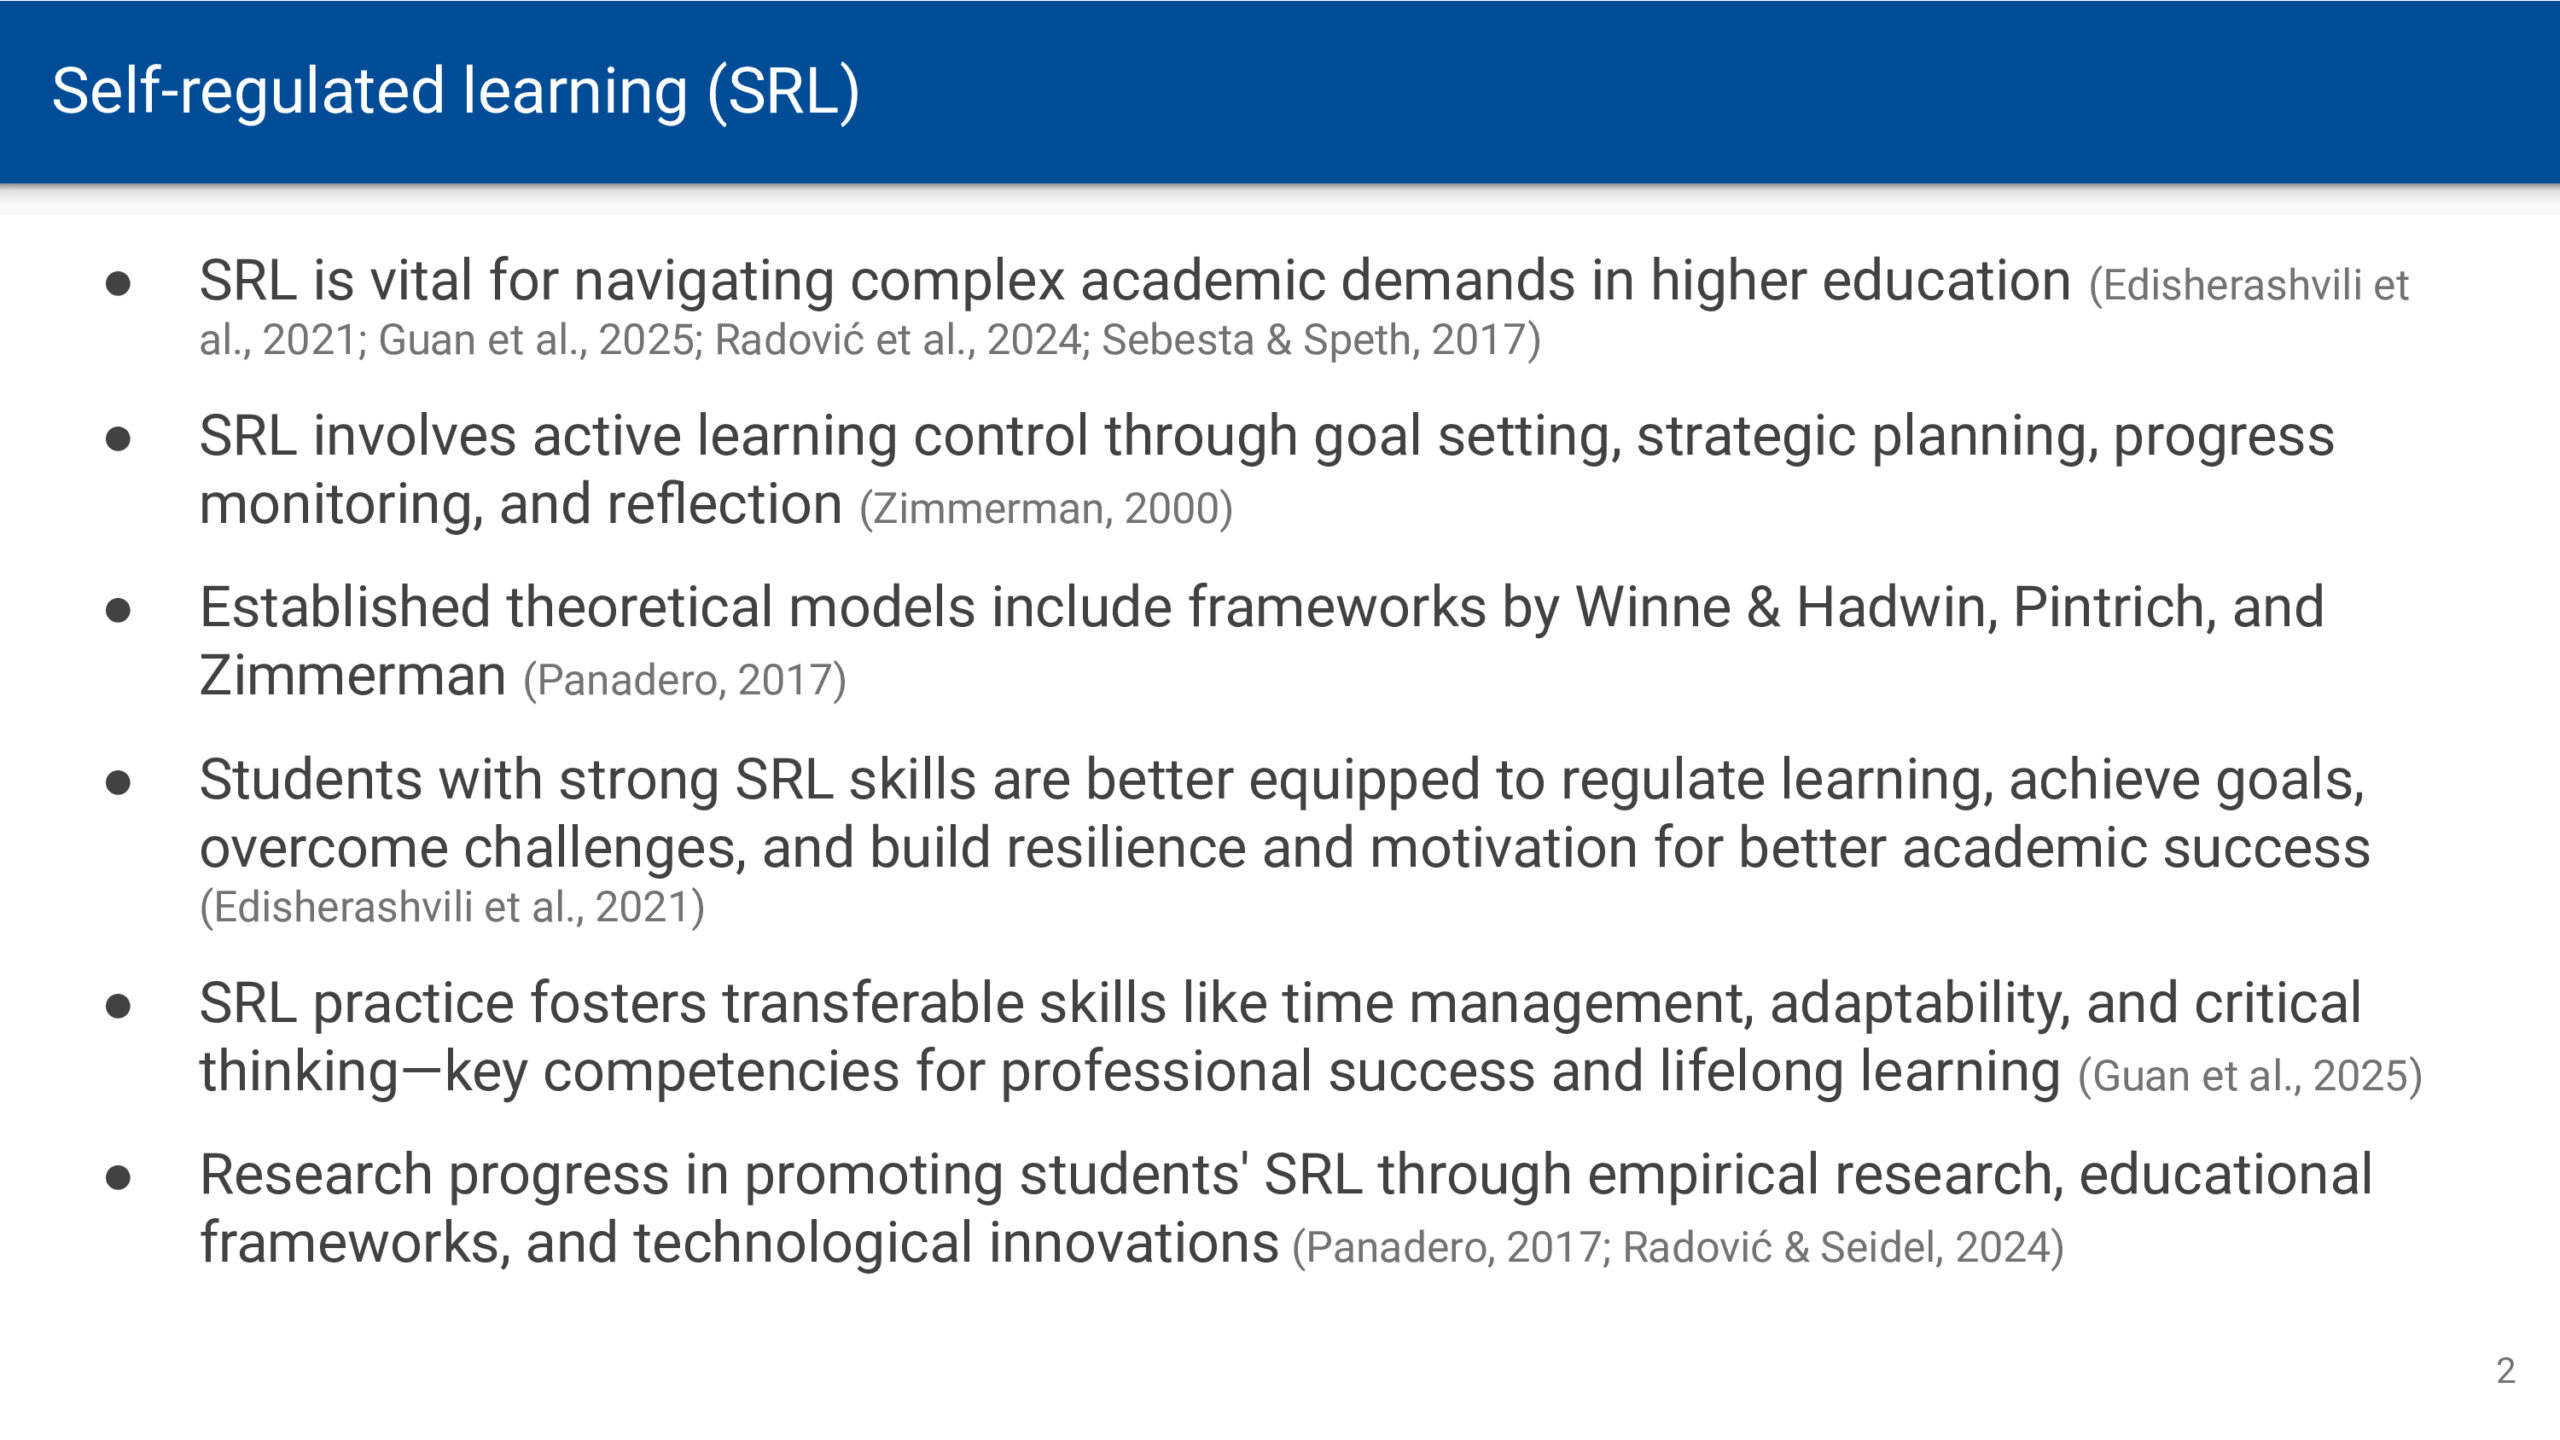
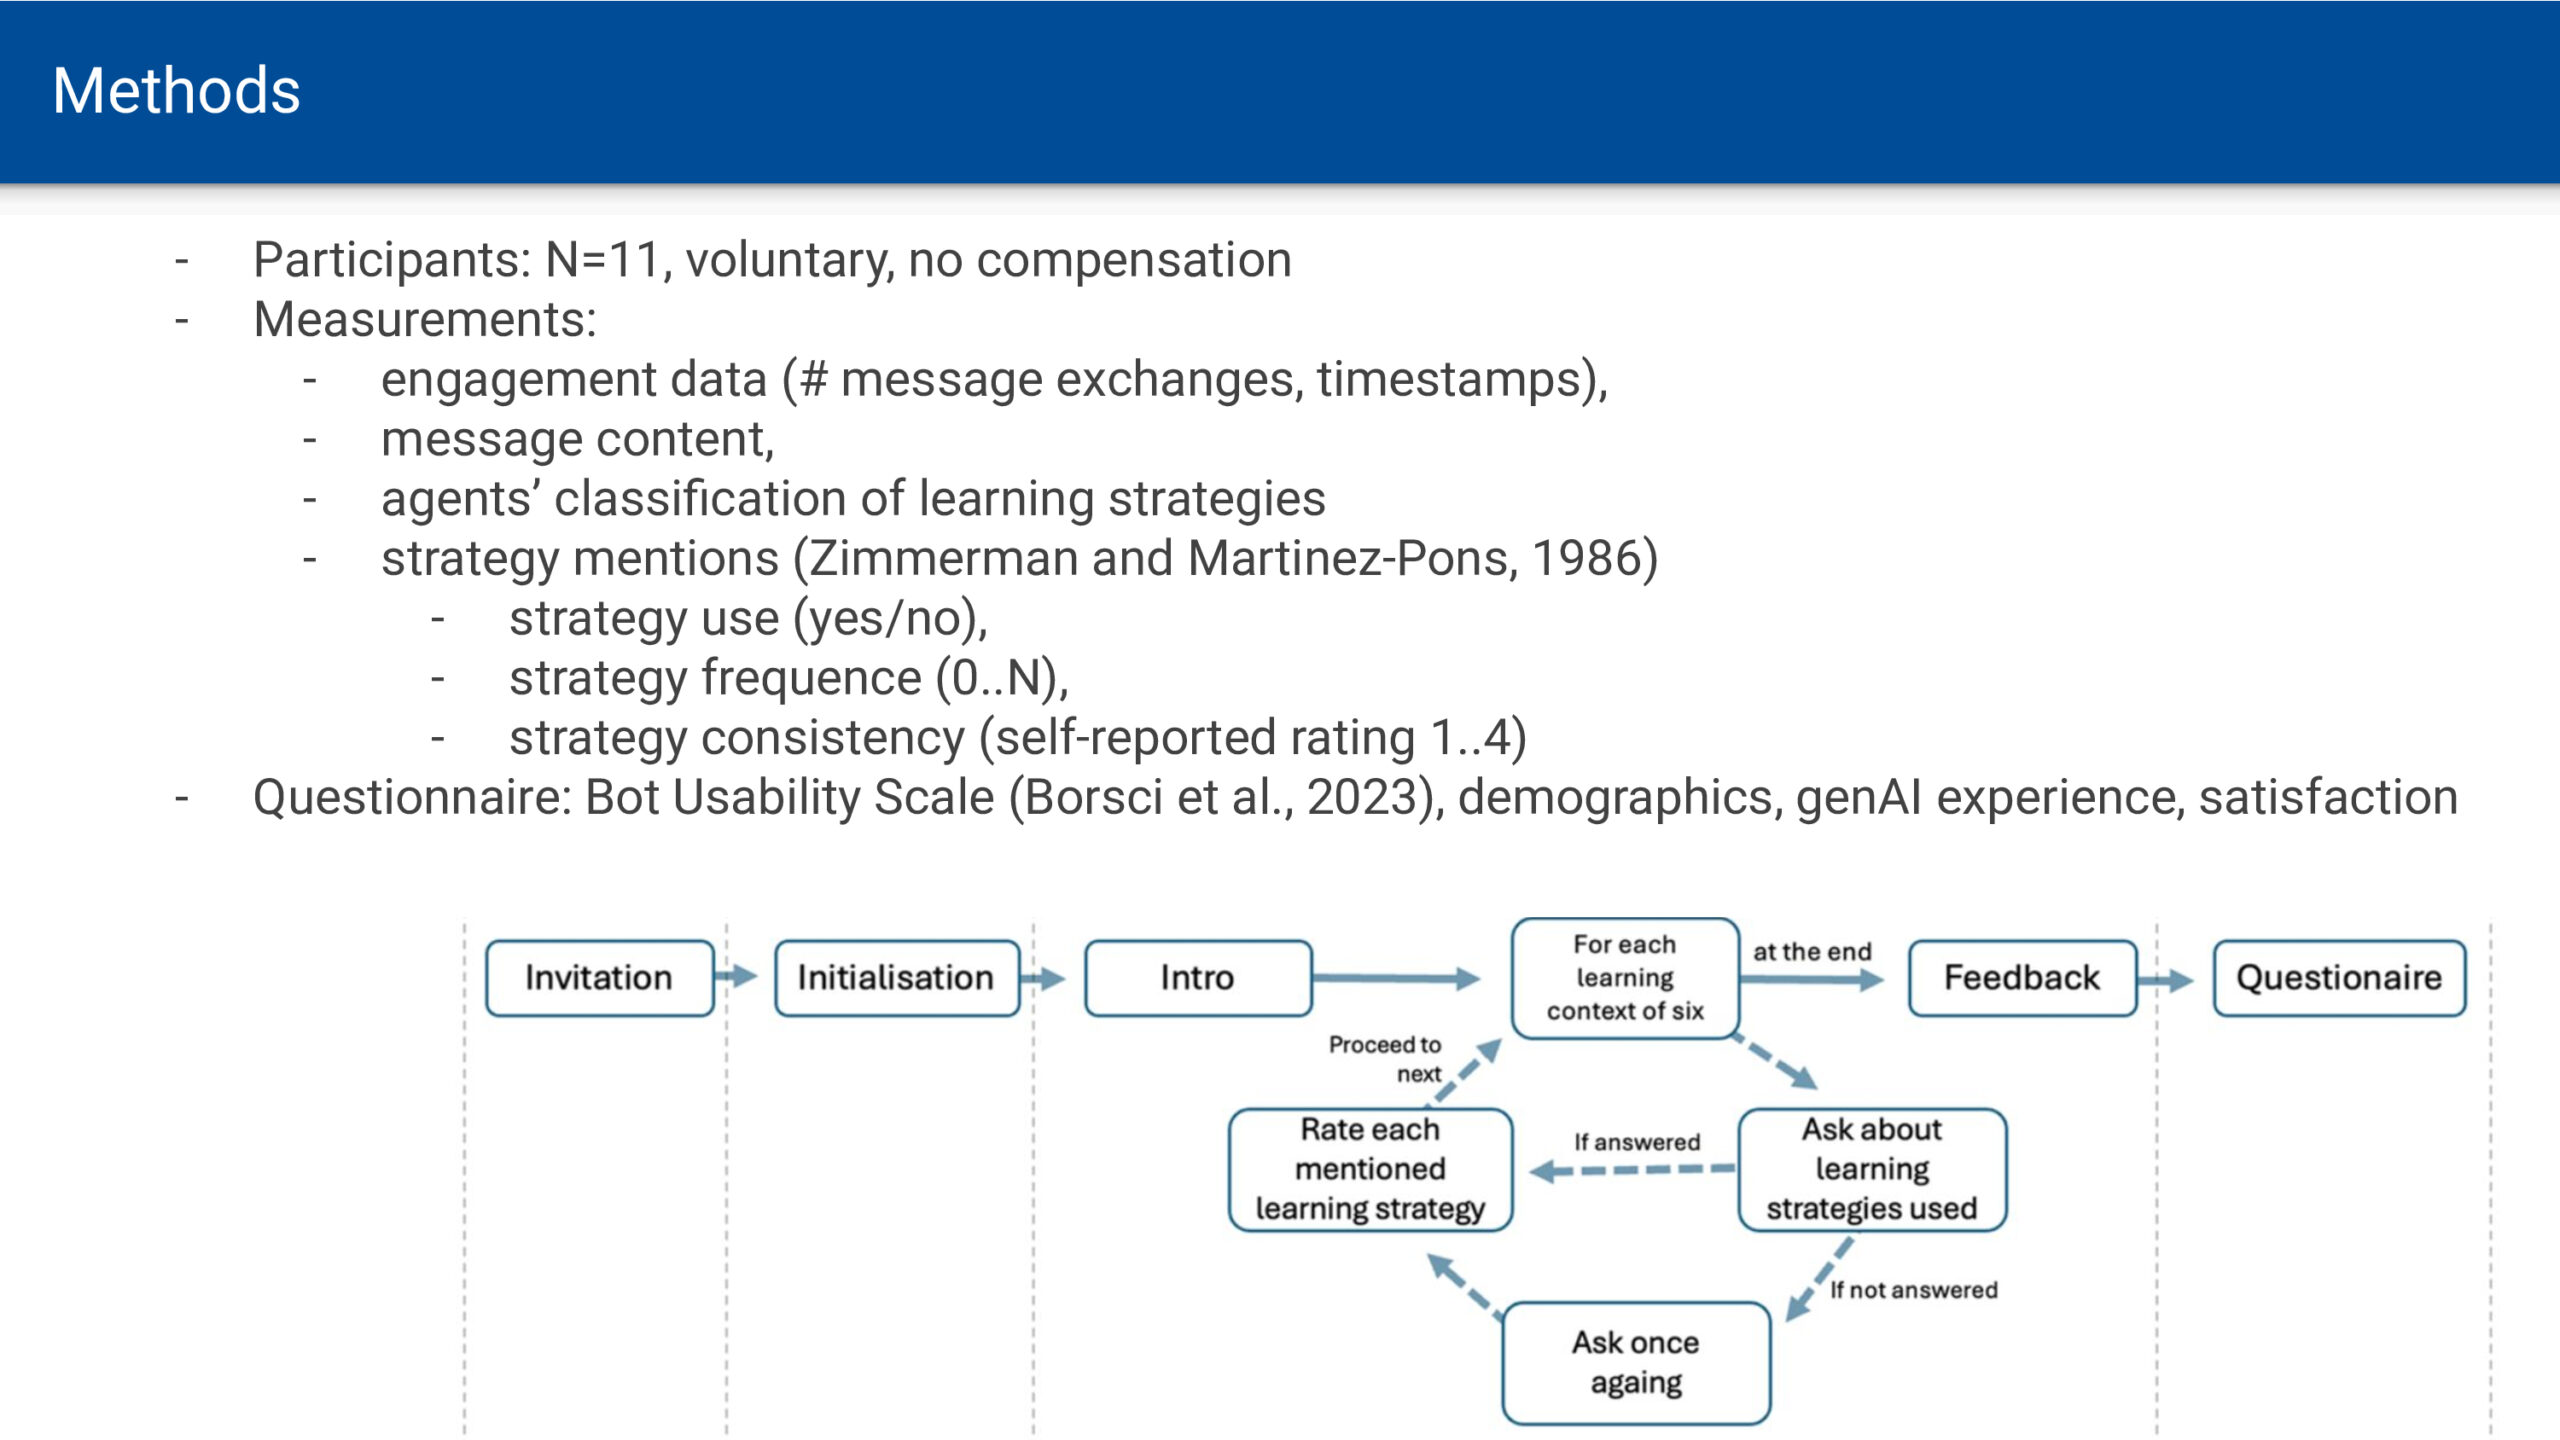
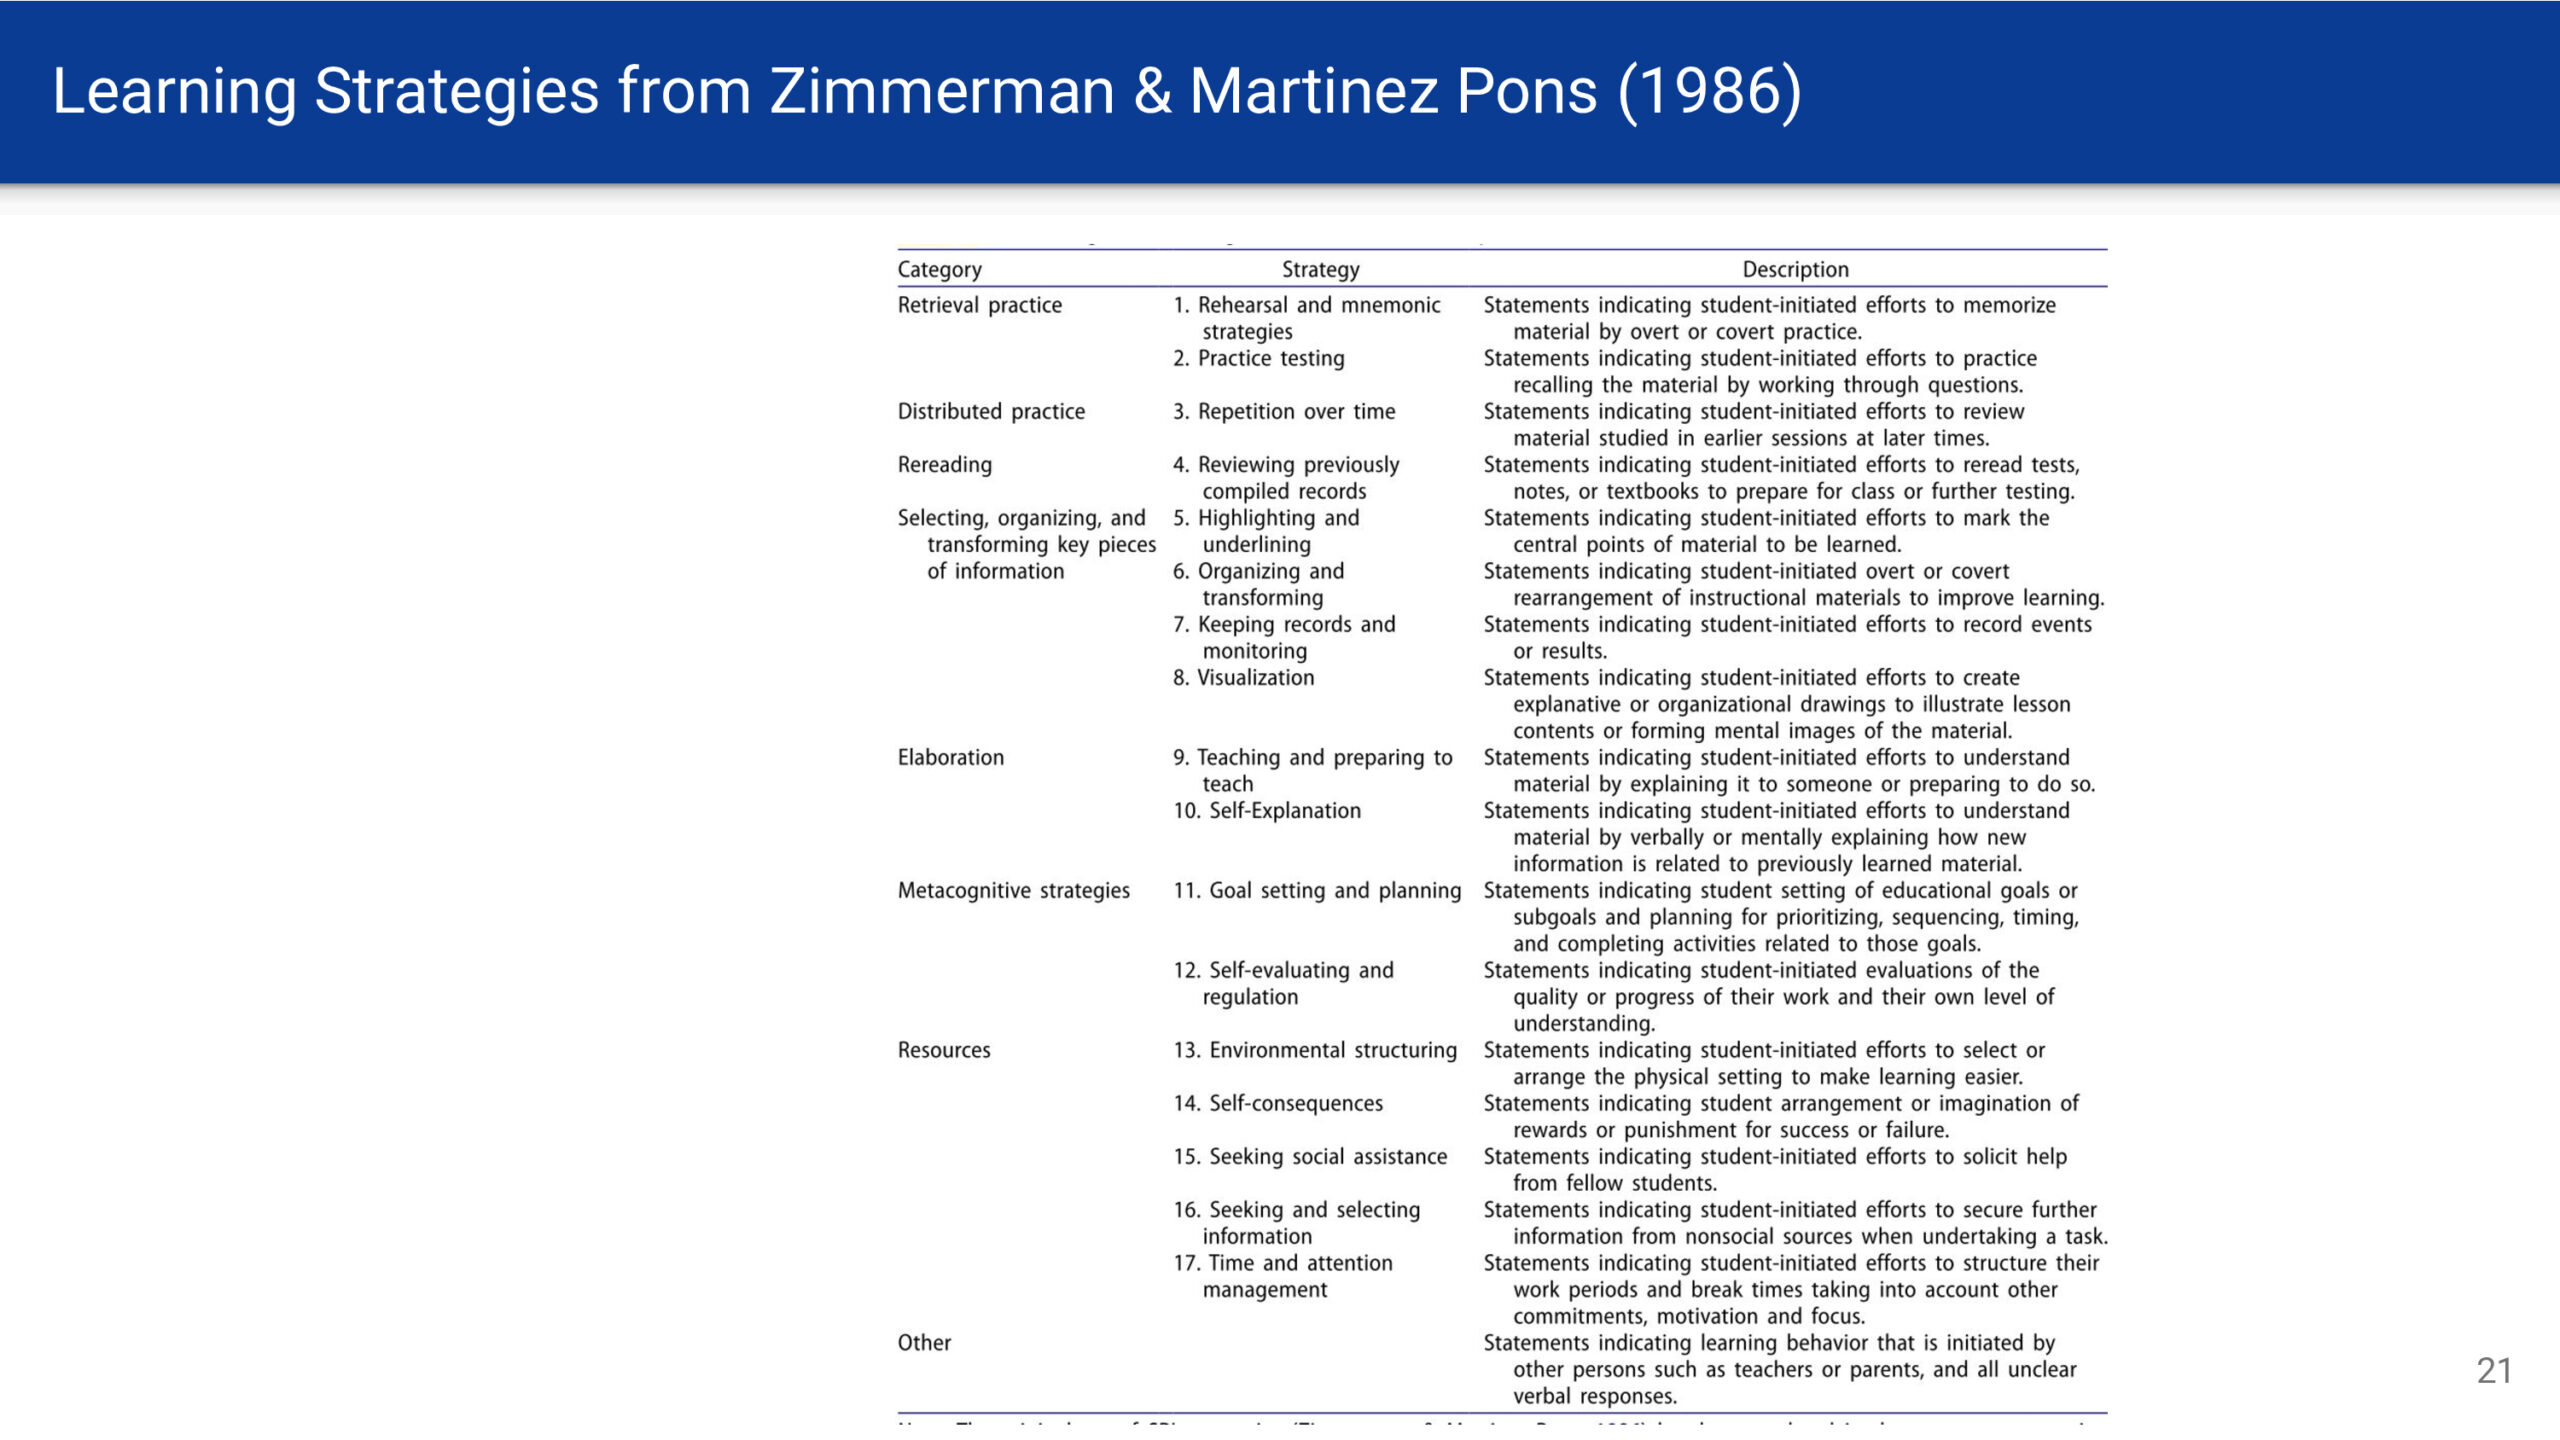
Am 2. September 2025 habe ich bei der Learning AID in Bochum unseren SRL-Agenten präsentiert. In der vorgestellten Version dient der Agent der Erhebung von Lernstrategien mit Hilfe eines Interviewprotokolls von Zimmerman und Martinez-Pons. Im CATALPA Reallabor untersuchen wir Interaktionen dieser Erhebungsmethode mit etablierten SRL-Messmethoden.

Abstract

Während das Potenzial von Large Language Models (LLMs) in jüngster Zeit in verschiedenen
Bereichen des Bildungswesens untersucht wurde, ist ihre Anwendung bei der Messung der
Fähigkeiten Studierender im Bereich des selbstgesteuerten Lernens (SRL) noch nicht ausreichend
erforscht. Aktuelle Initiativen zur Messung von SRL (Befragungen, digitale trace data) stehen vor
mehreren Herausforderungen, die die Entwicklung effektiver SRL-Maßnahmen direkt behindern.
Um diese komplexe Bildungsherausforderung anzugehen, untersucht diese Studie die
Implementierung und Evaluierung eines generativen KI-Agenten, der entwickelt wurde, um
Interviews auf der Grundlage des Self-Regulated Learning Structured Interview (SRLSI) von
Zimmerman und Martinez-Pons durchzuführen. Das System wurde mit 13 Teilnehmern hinsichtlich
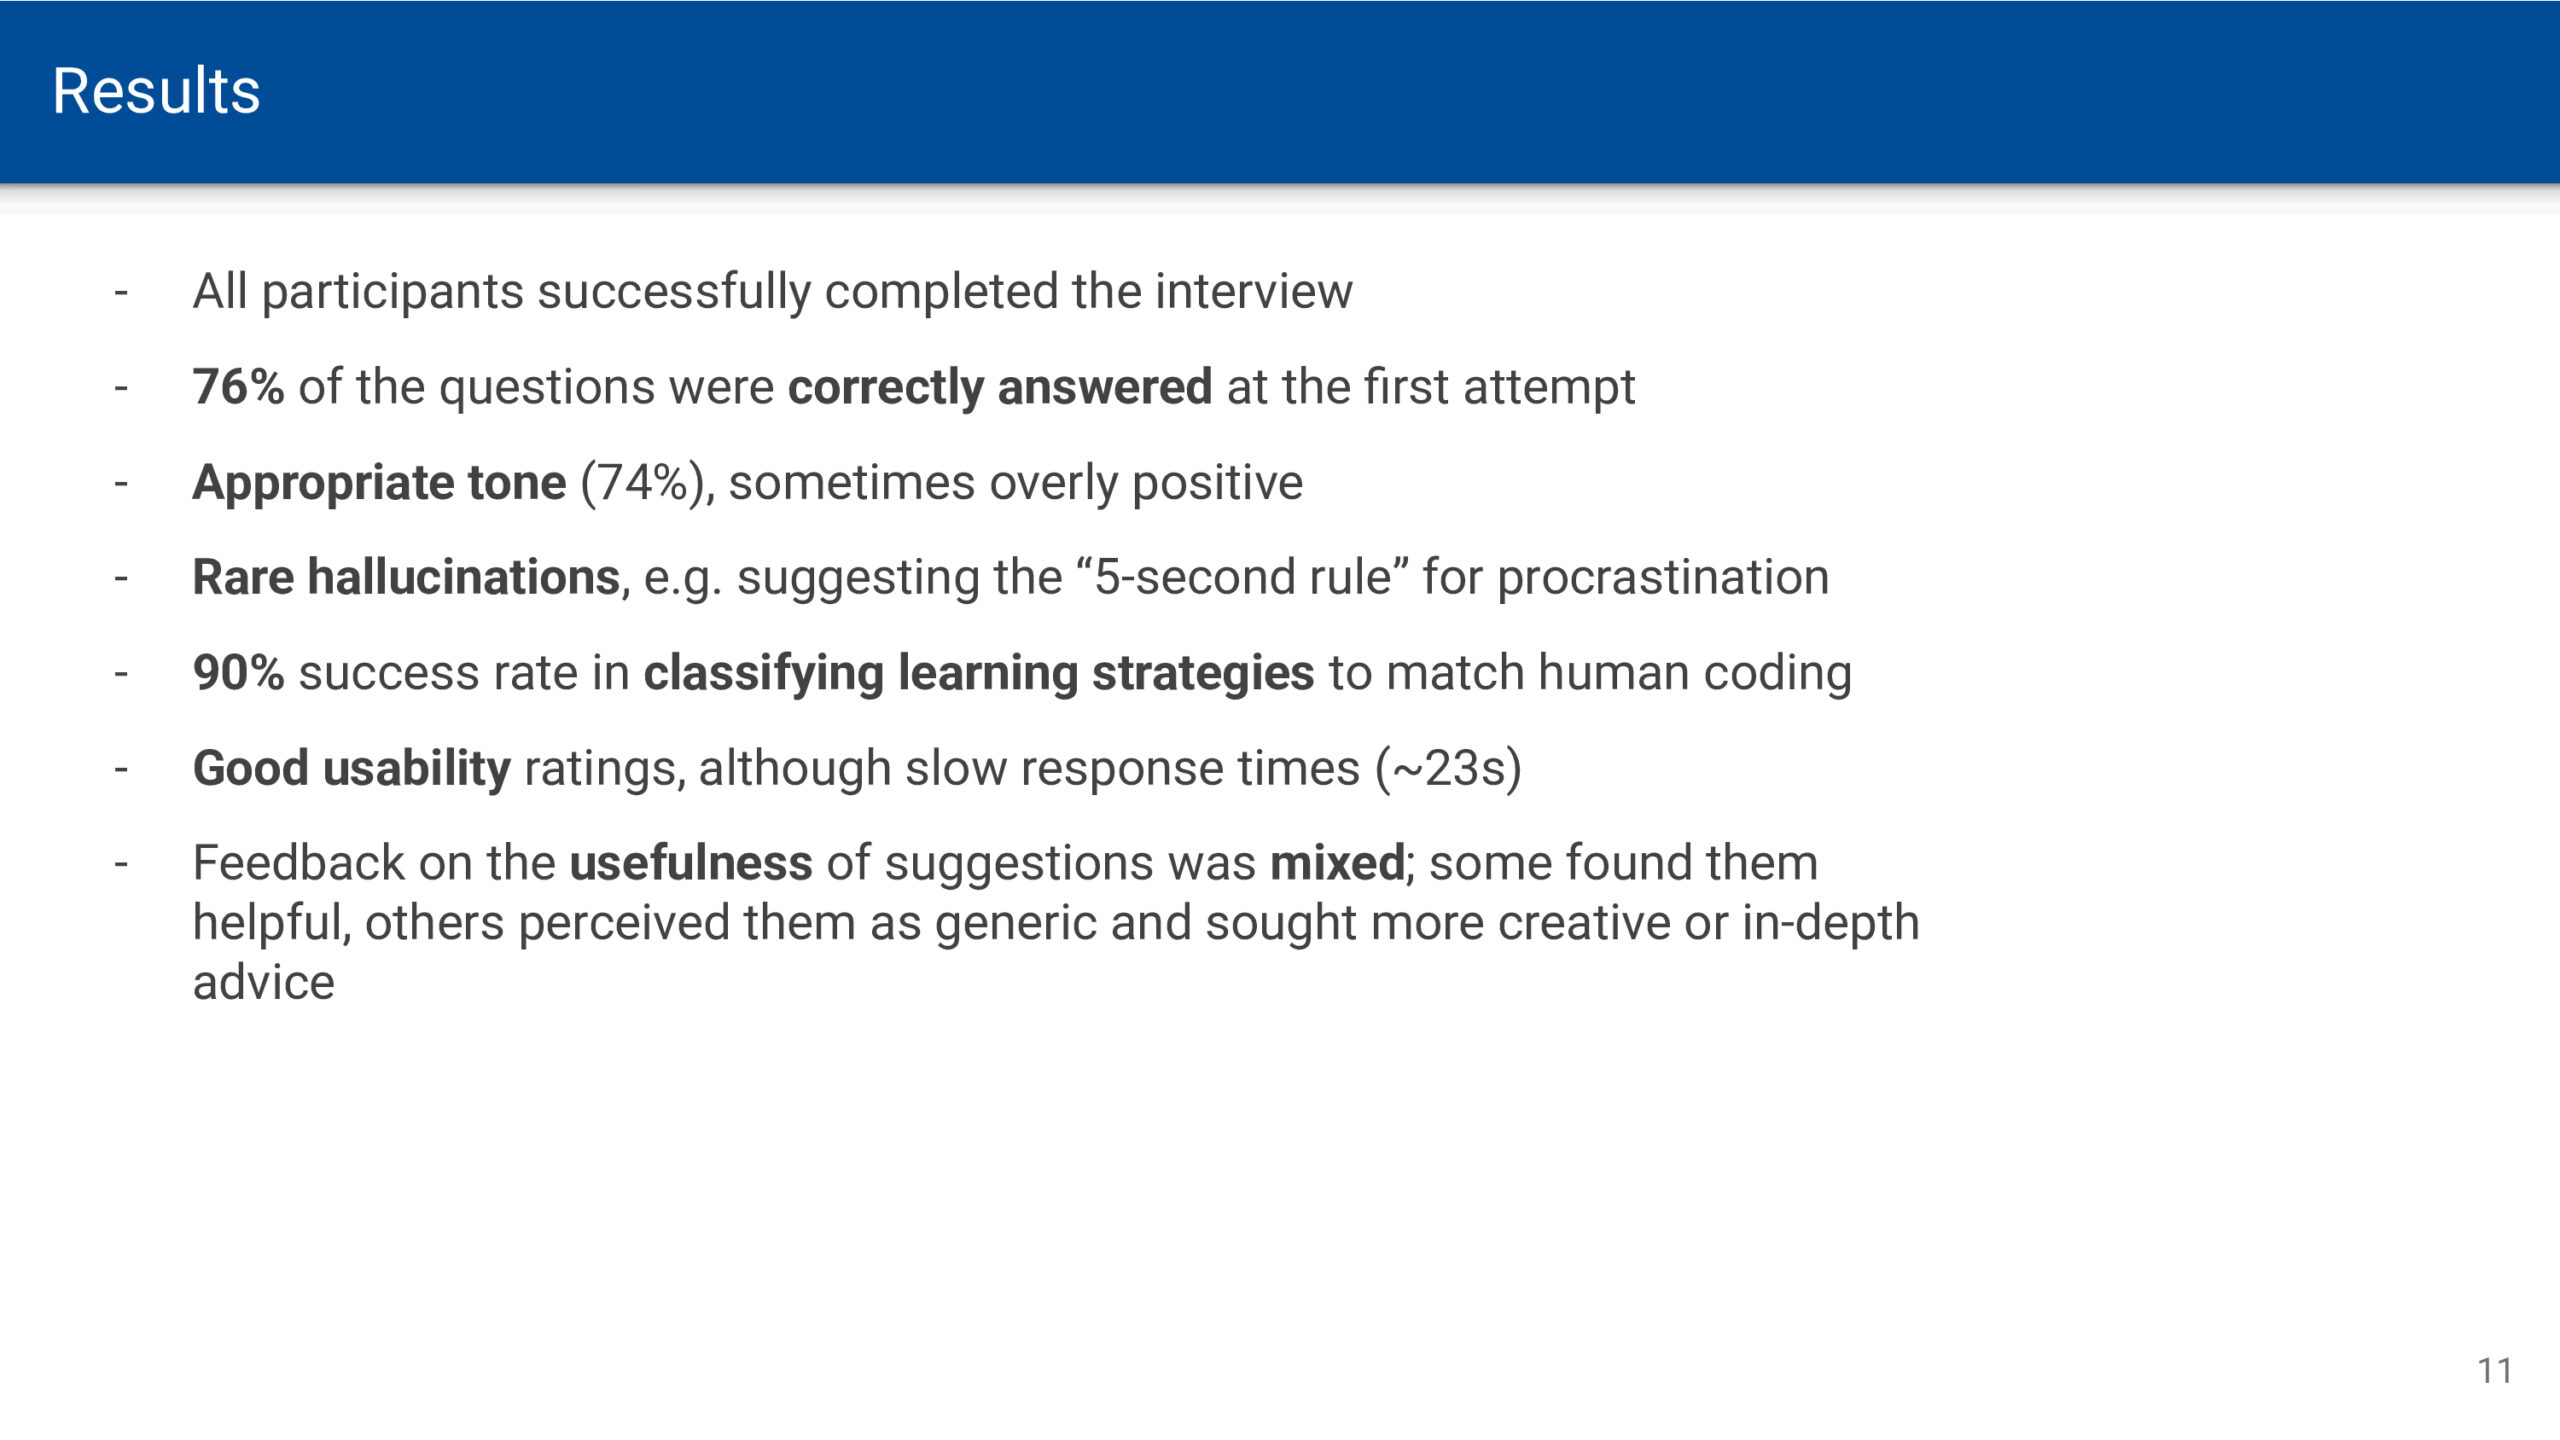
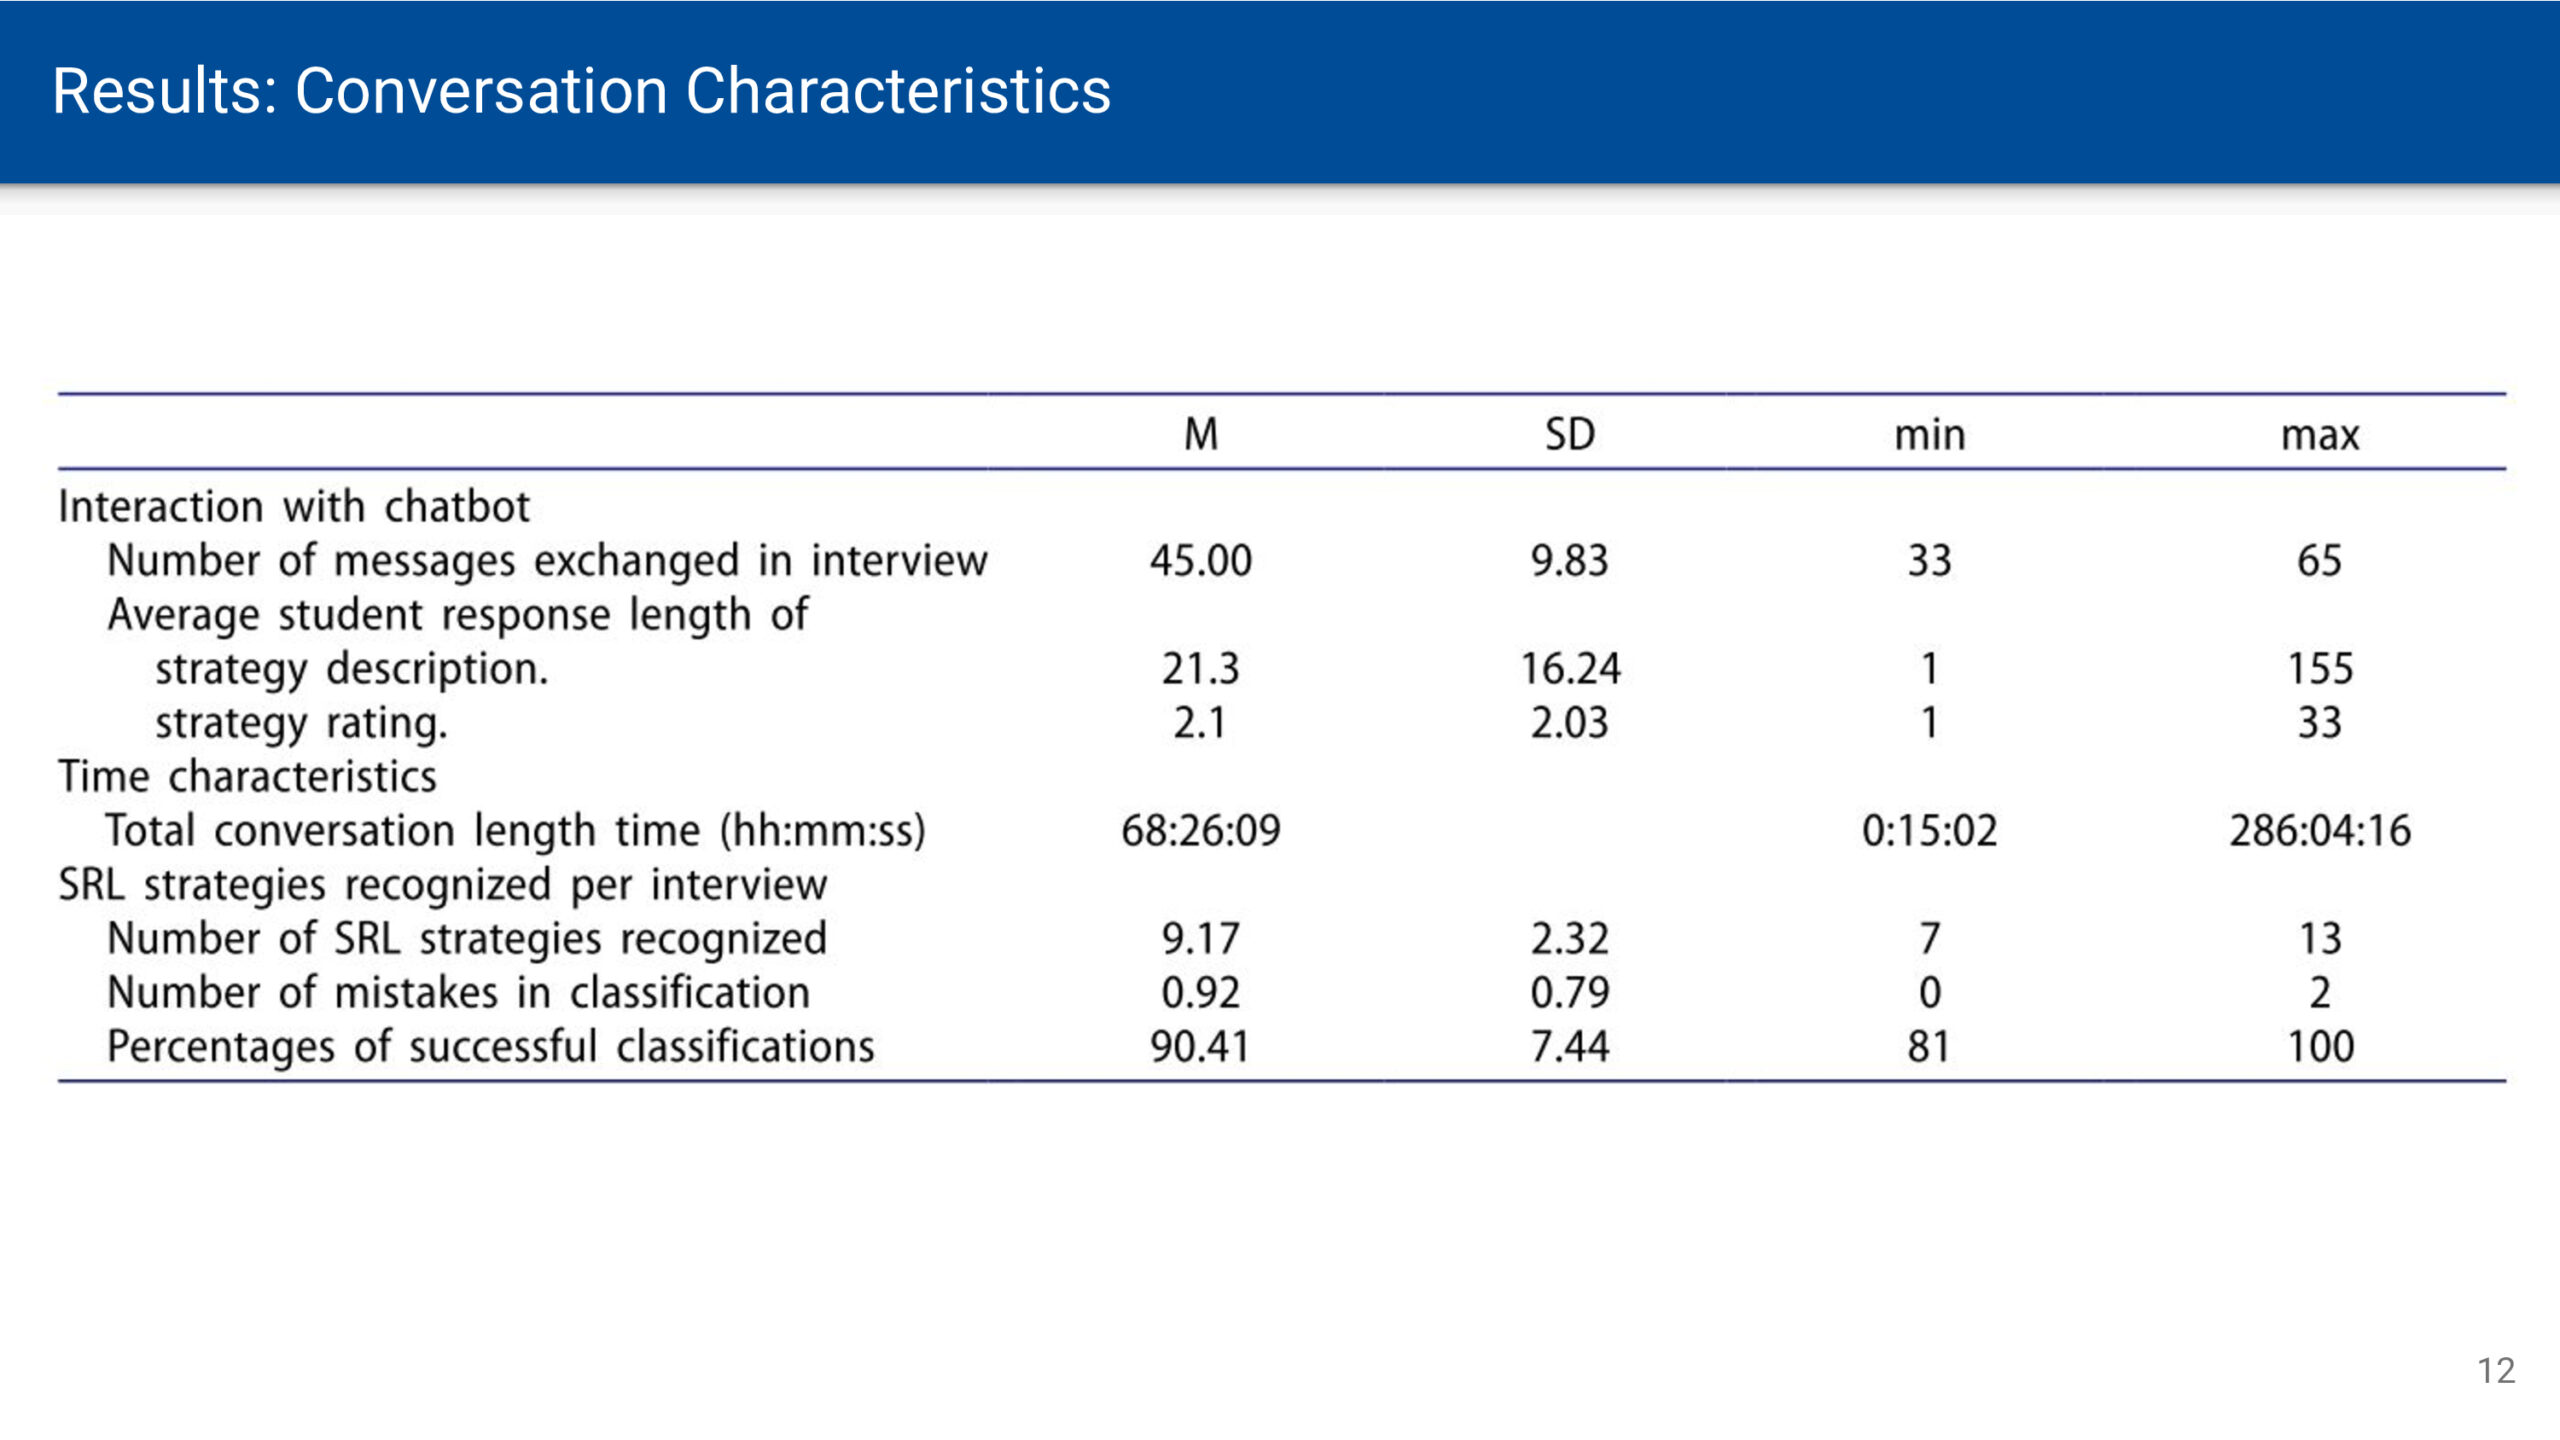
Effizienz, Effektivität und Zufriedenheit zu untersuchen. Die Ergebnisse zeigen, dass der Agent das
SRLSI-Interview erfolgreich durchführen kann und eine effiziente Automatisierung von SRL-
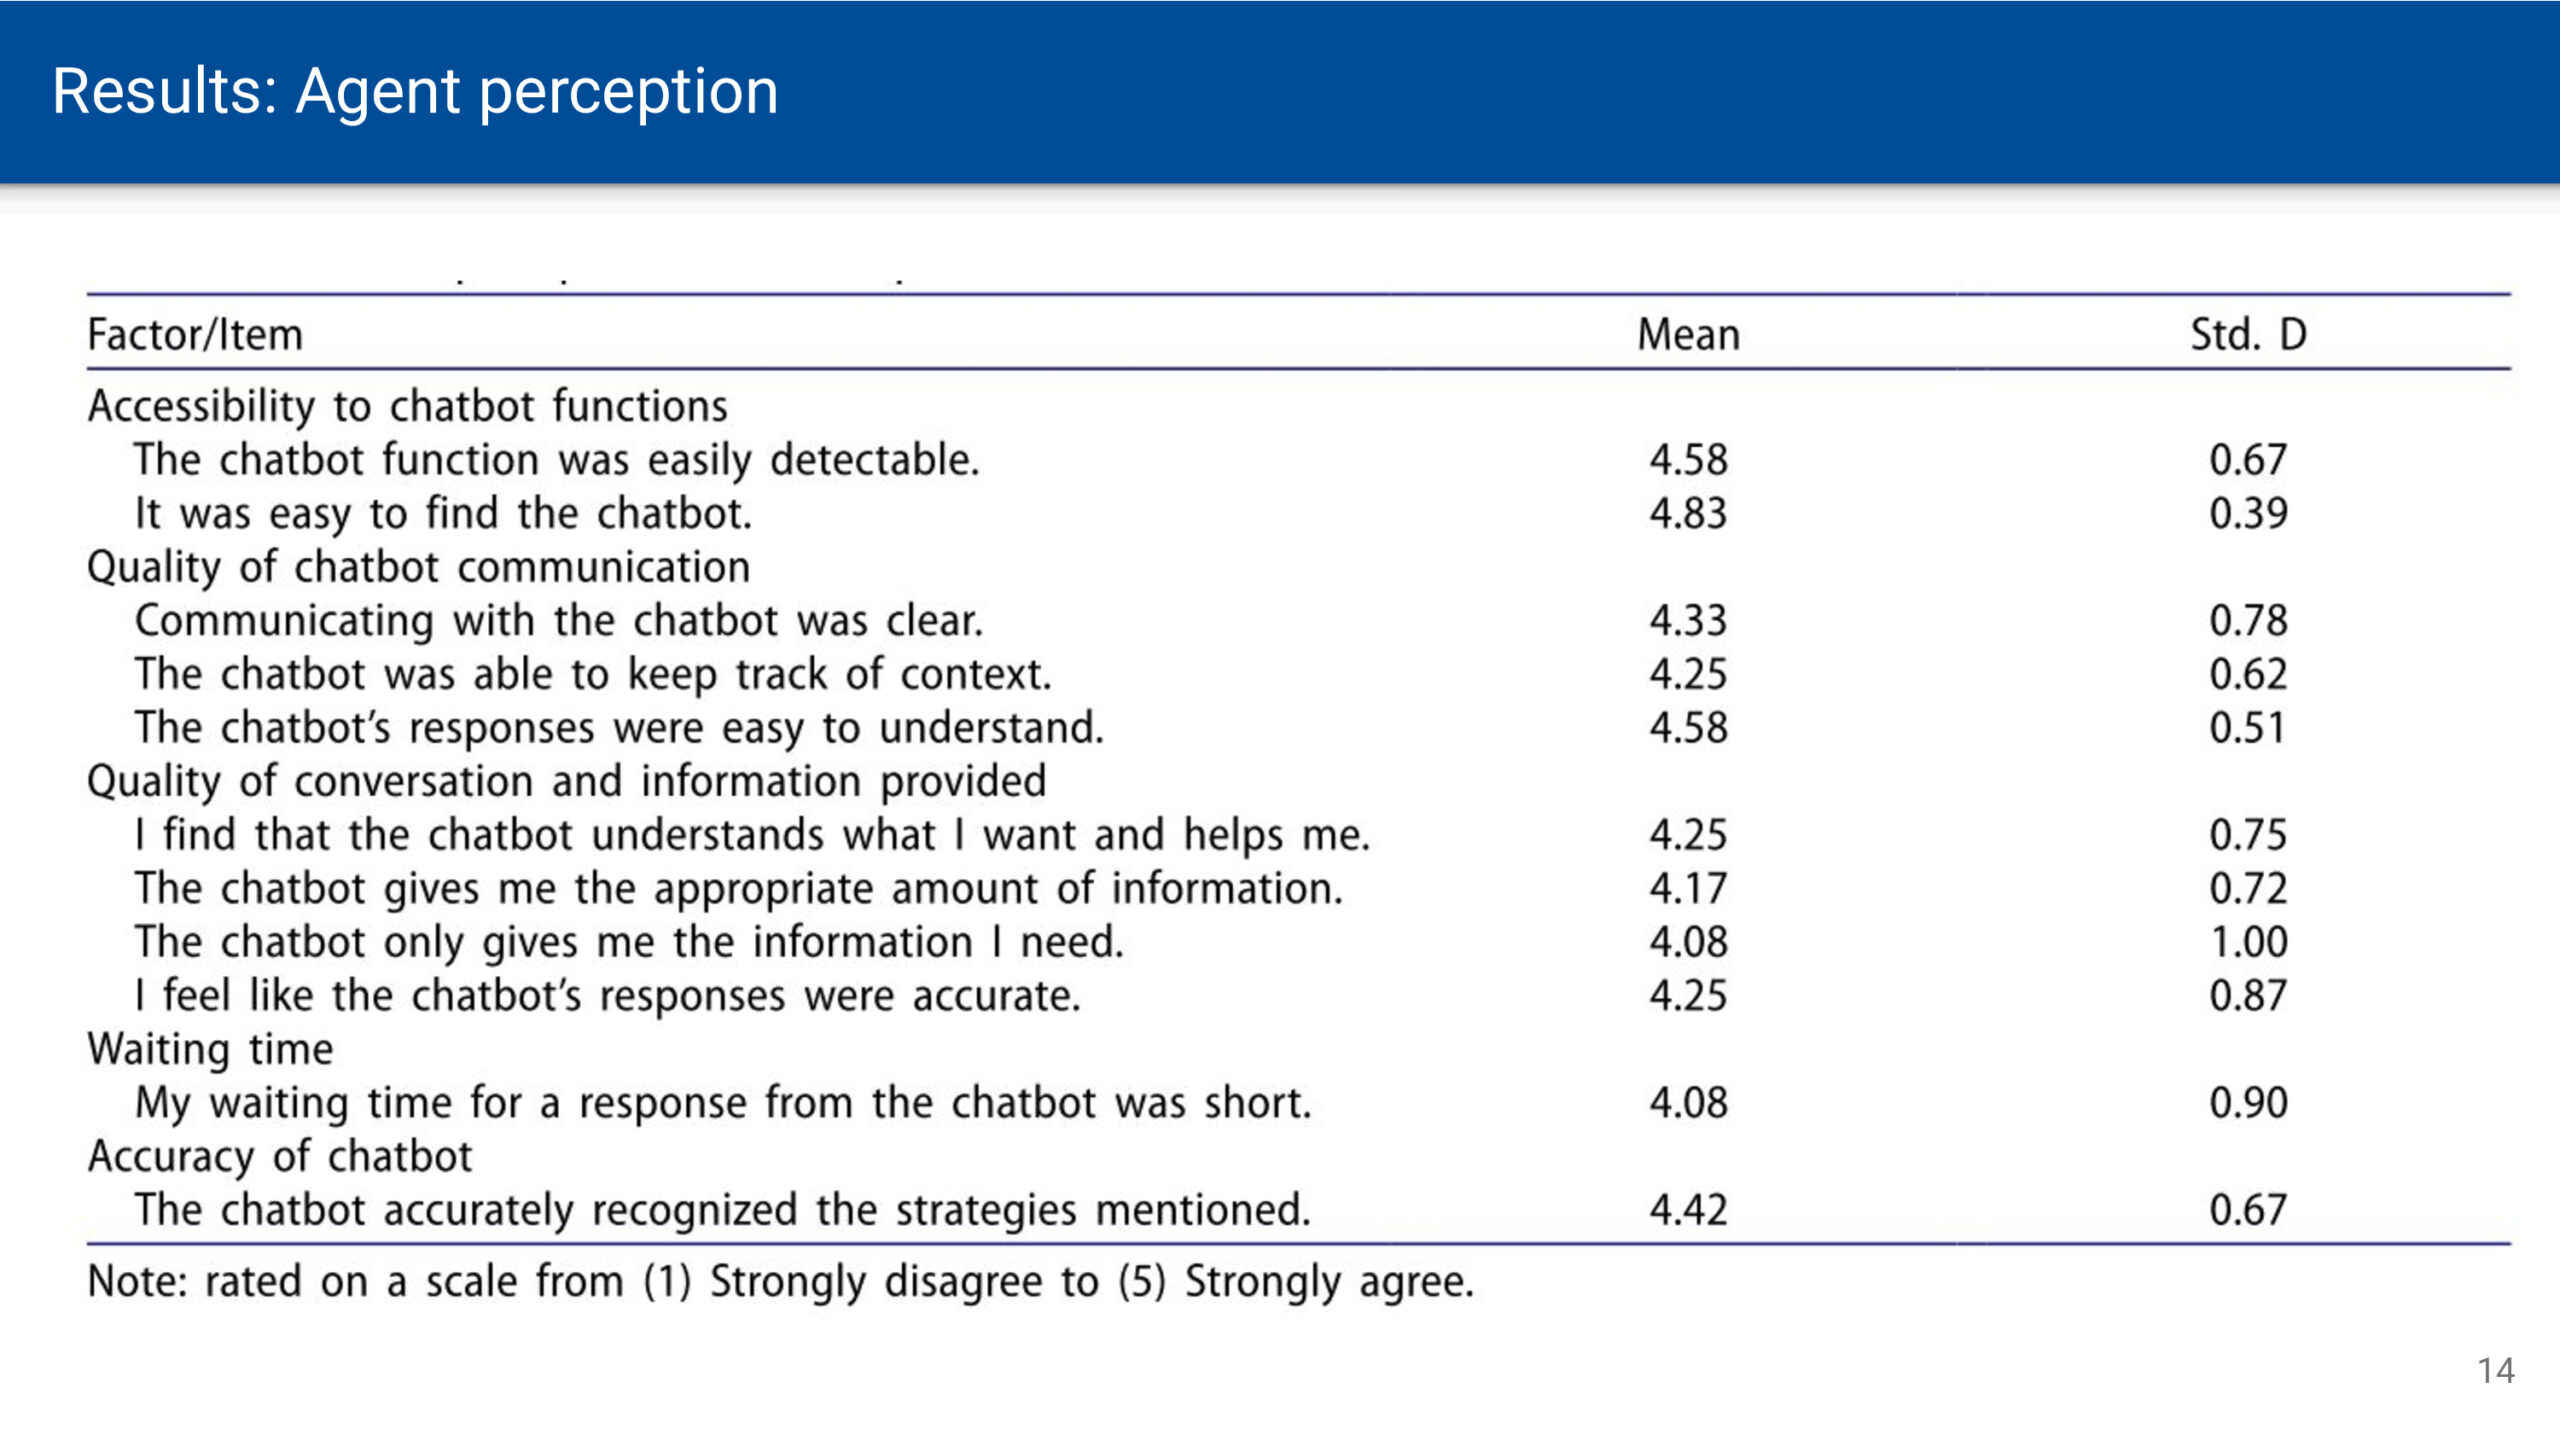
Bewertungen demonstriert. Die Lernenden fanden das in Discord und Moodle integrierte Tool
benutzerfreundlich und schätzten die Genauigkeit und Qualität der Gespräche. Die Rückmeldungen
zum Nutzen und zur Relevanz der Empfehlungen waren jedoch uneinheitlich, was
Verbesserungsmöglichkeiten und das Potenzial zur Verbesserung der personalisierten
Lernunterstützung unterstreicht. Diese Ergebnisse bieten direkte Einblicke für zukünftige
Fortschritte bei der SRL-Messung und SRL-Interventionen.

Folien:

Voices from the CSEDU’25

It was the first time that I had participated in the CSEDU conference. The conference is B-ranked in the Australian core ranking, so I felt it was worth going there. Among the few inspiring talks I’ve seen at the conference, I would highlight the following three because they are relevant to my work at CATALPA:

  • Katharina Simbeck: Audits for Trust: An Auditability Framework for AI-Based Learning Analytics Systems. Katharina made strong arguments for making an educational model and even systems audible. A model or system is considered as audible if is accessible for auditors, documented, and available. She presented a framework for audibility that consists of three pilars: claim (e.g. validity, utility, ethics), evidence (e.g. documentation, model details, data incl. edge cases), and means of validation (e.g, API, monitoring tools, dashboards, explainability tools). This framework was demonstrated in a case study about the Moodle Learning Analytics API. For me, the frameworks provide meaningful guidelines for defining minimum requirements for publishing open source models and systems.
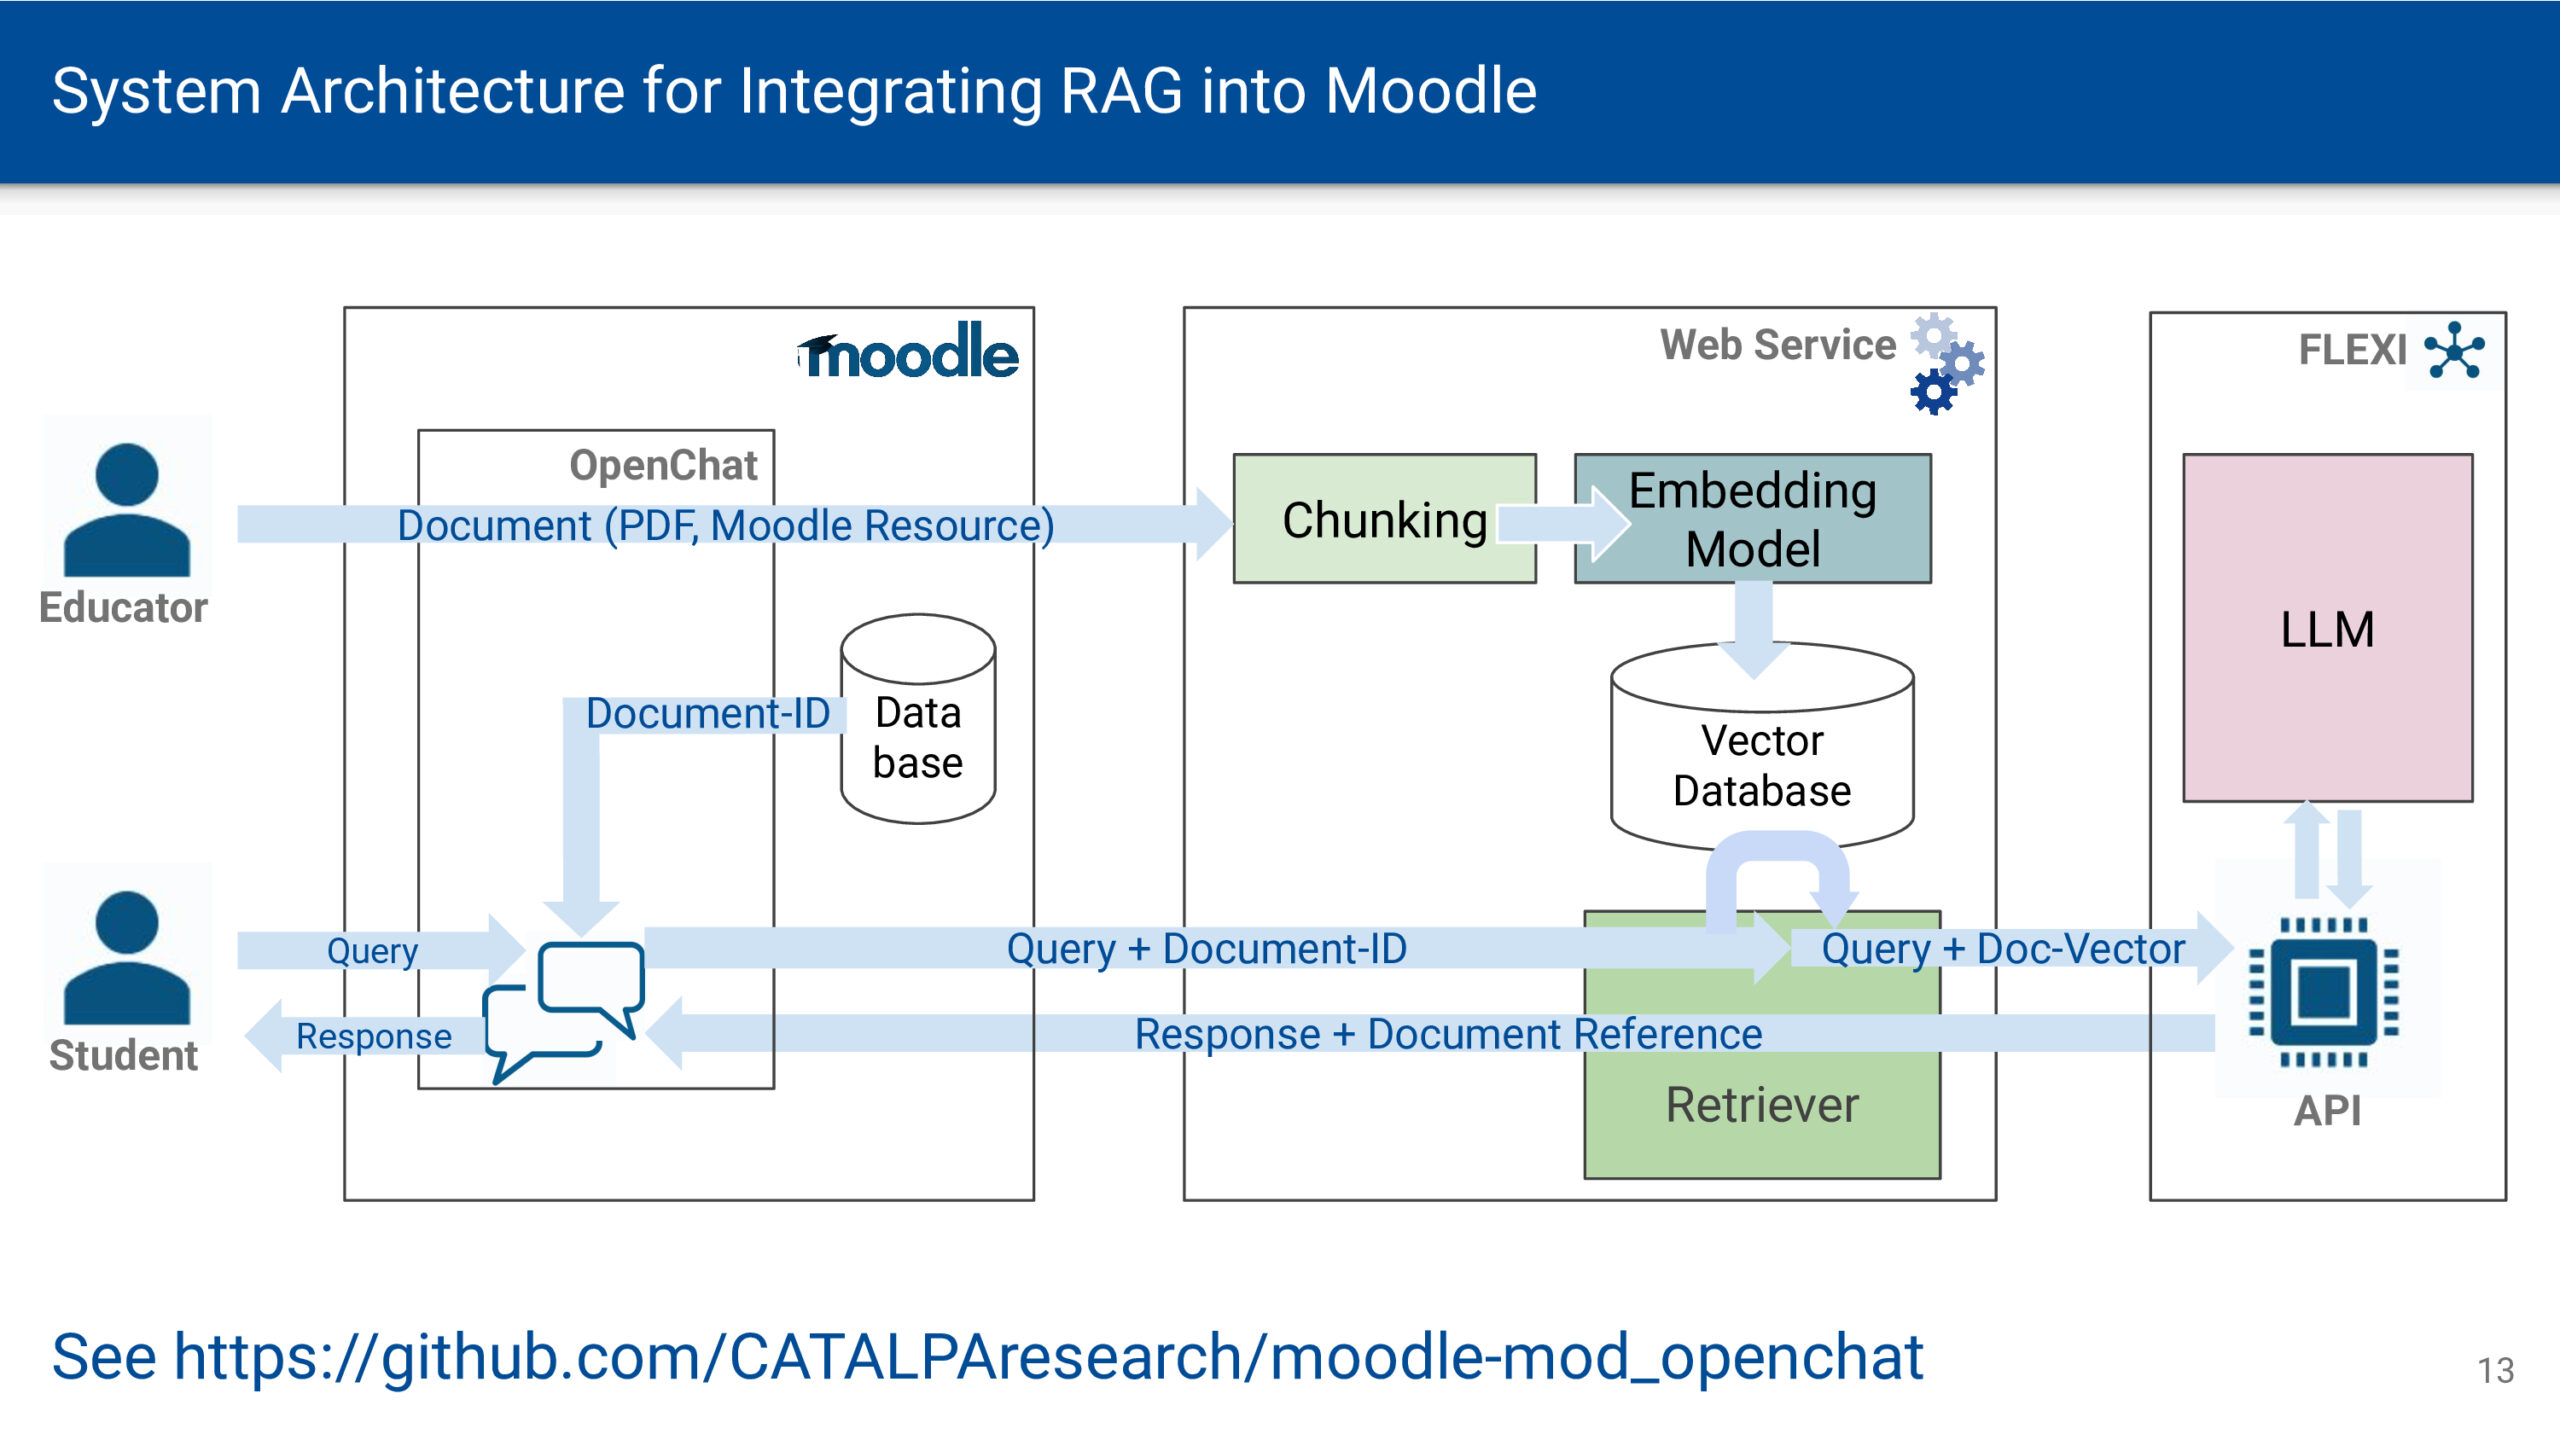
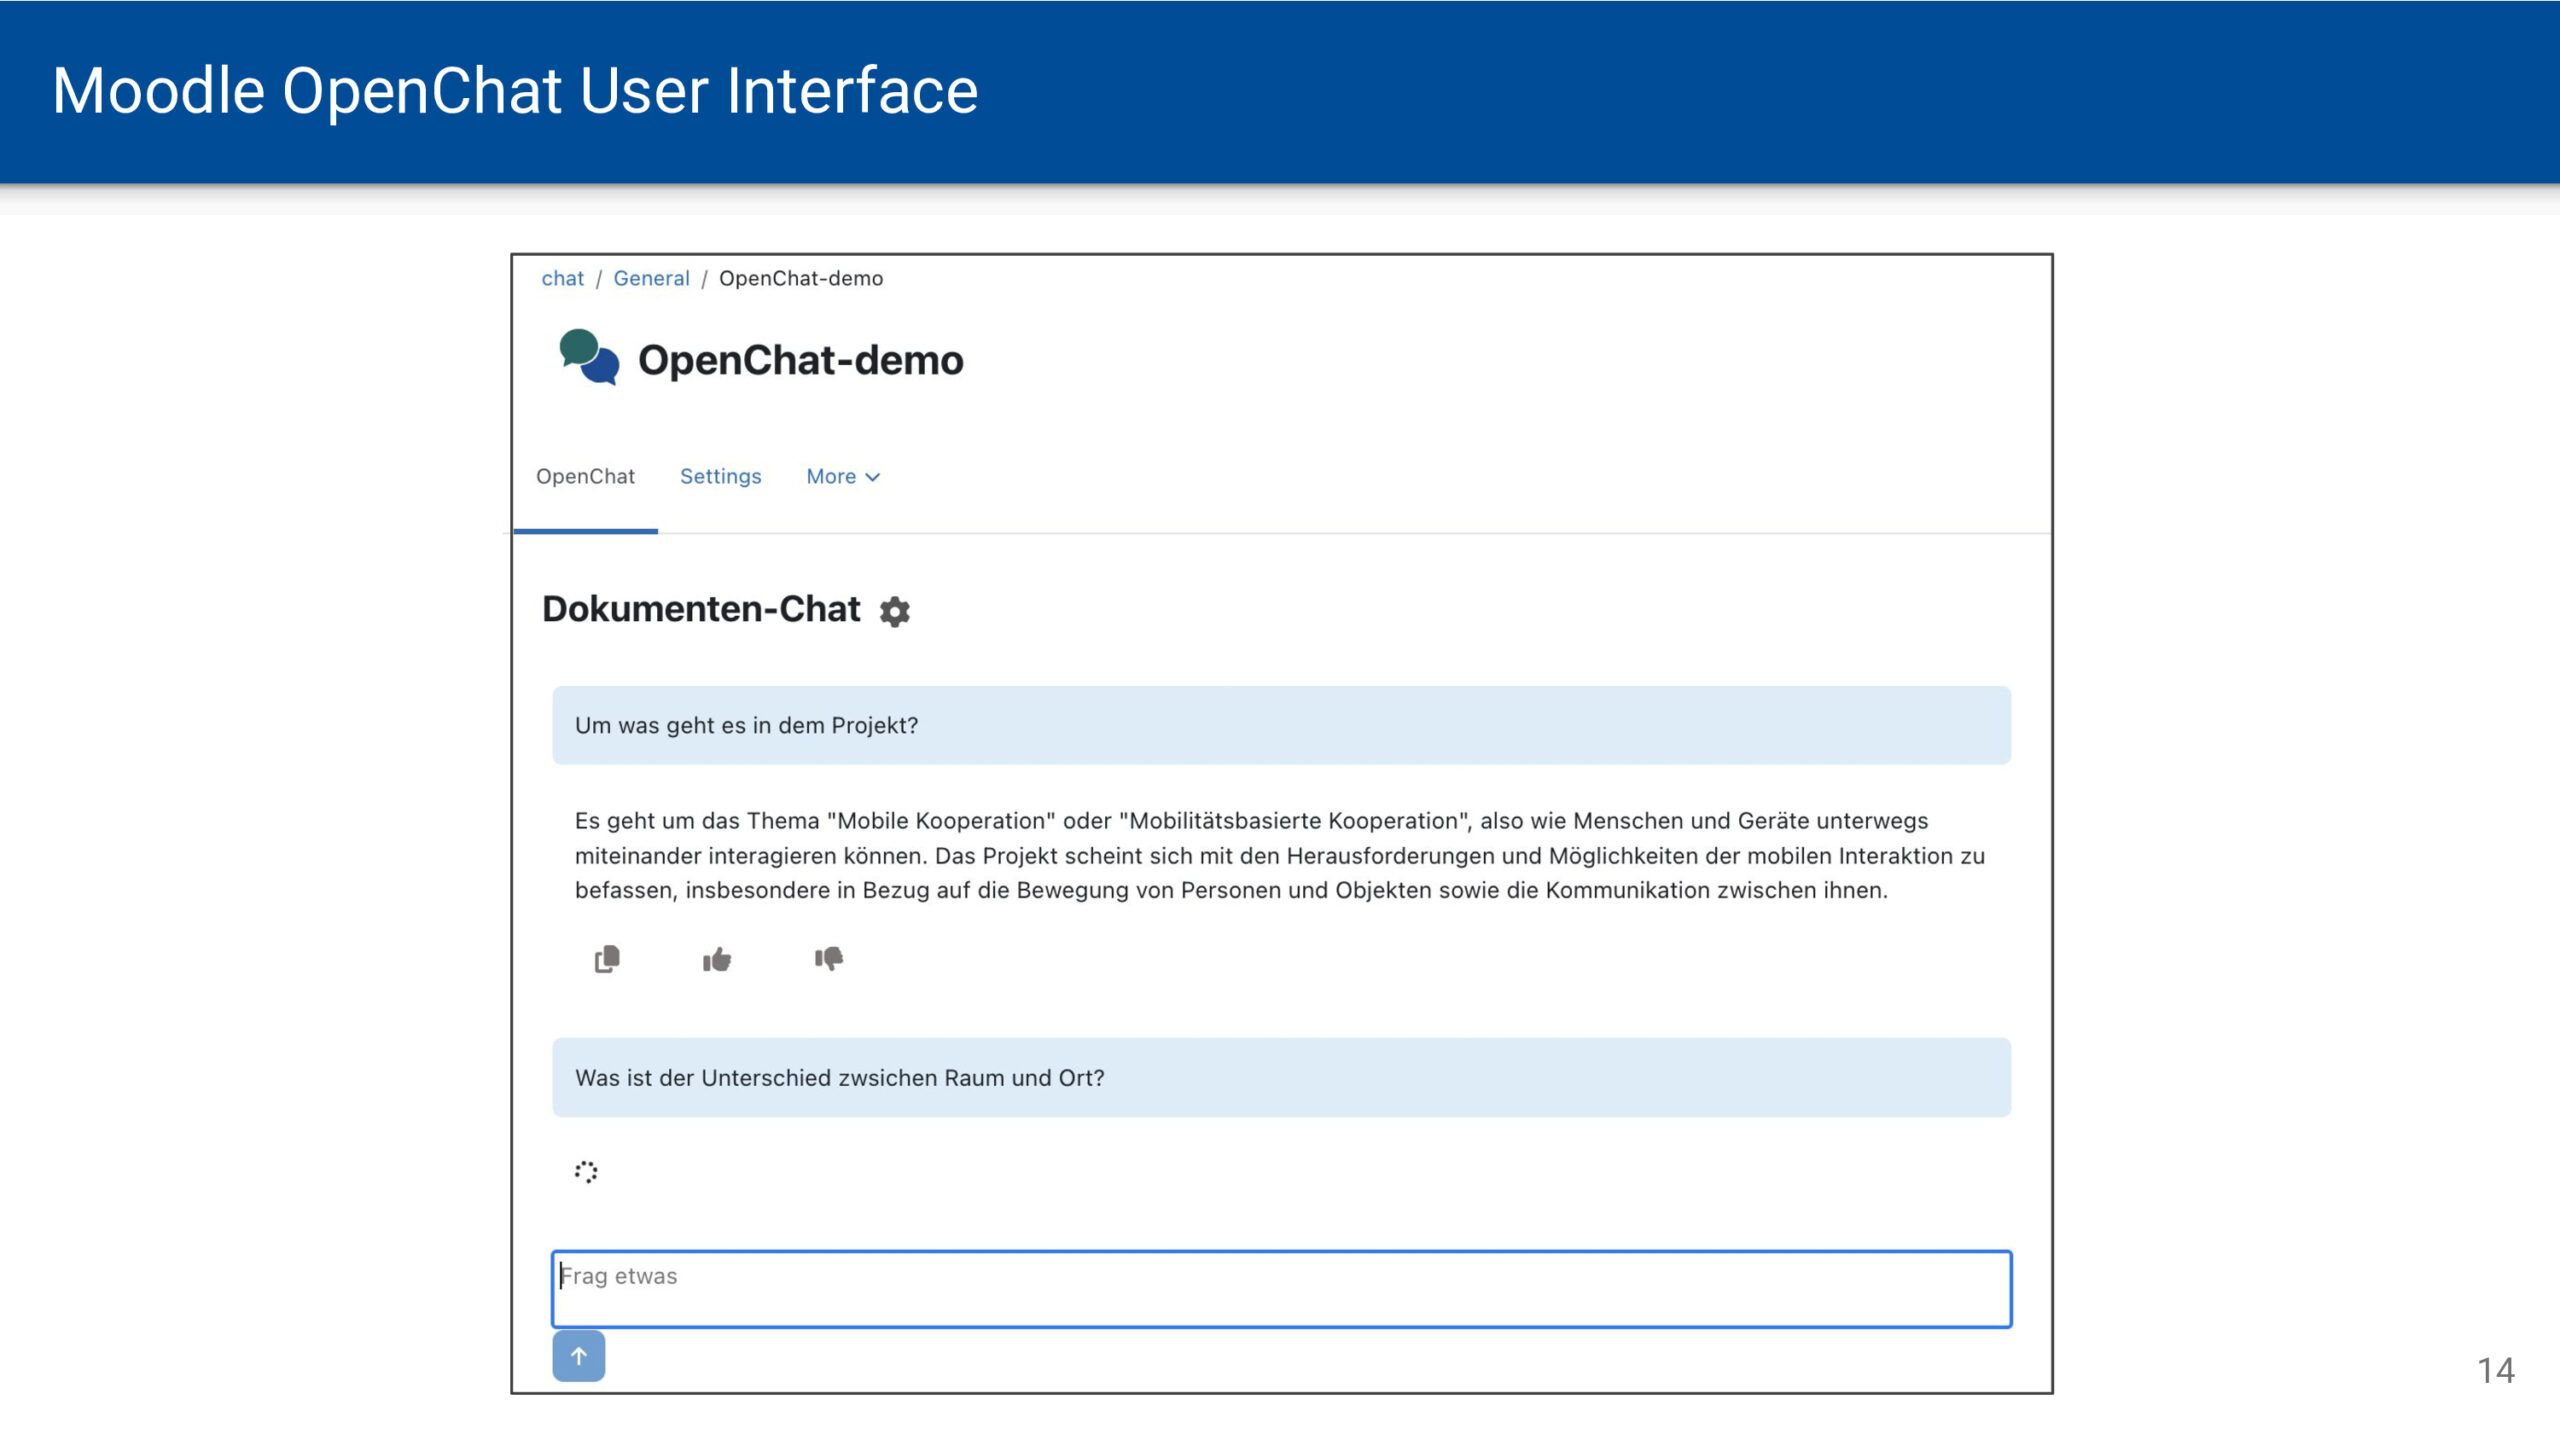
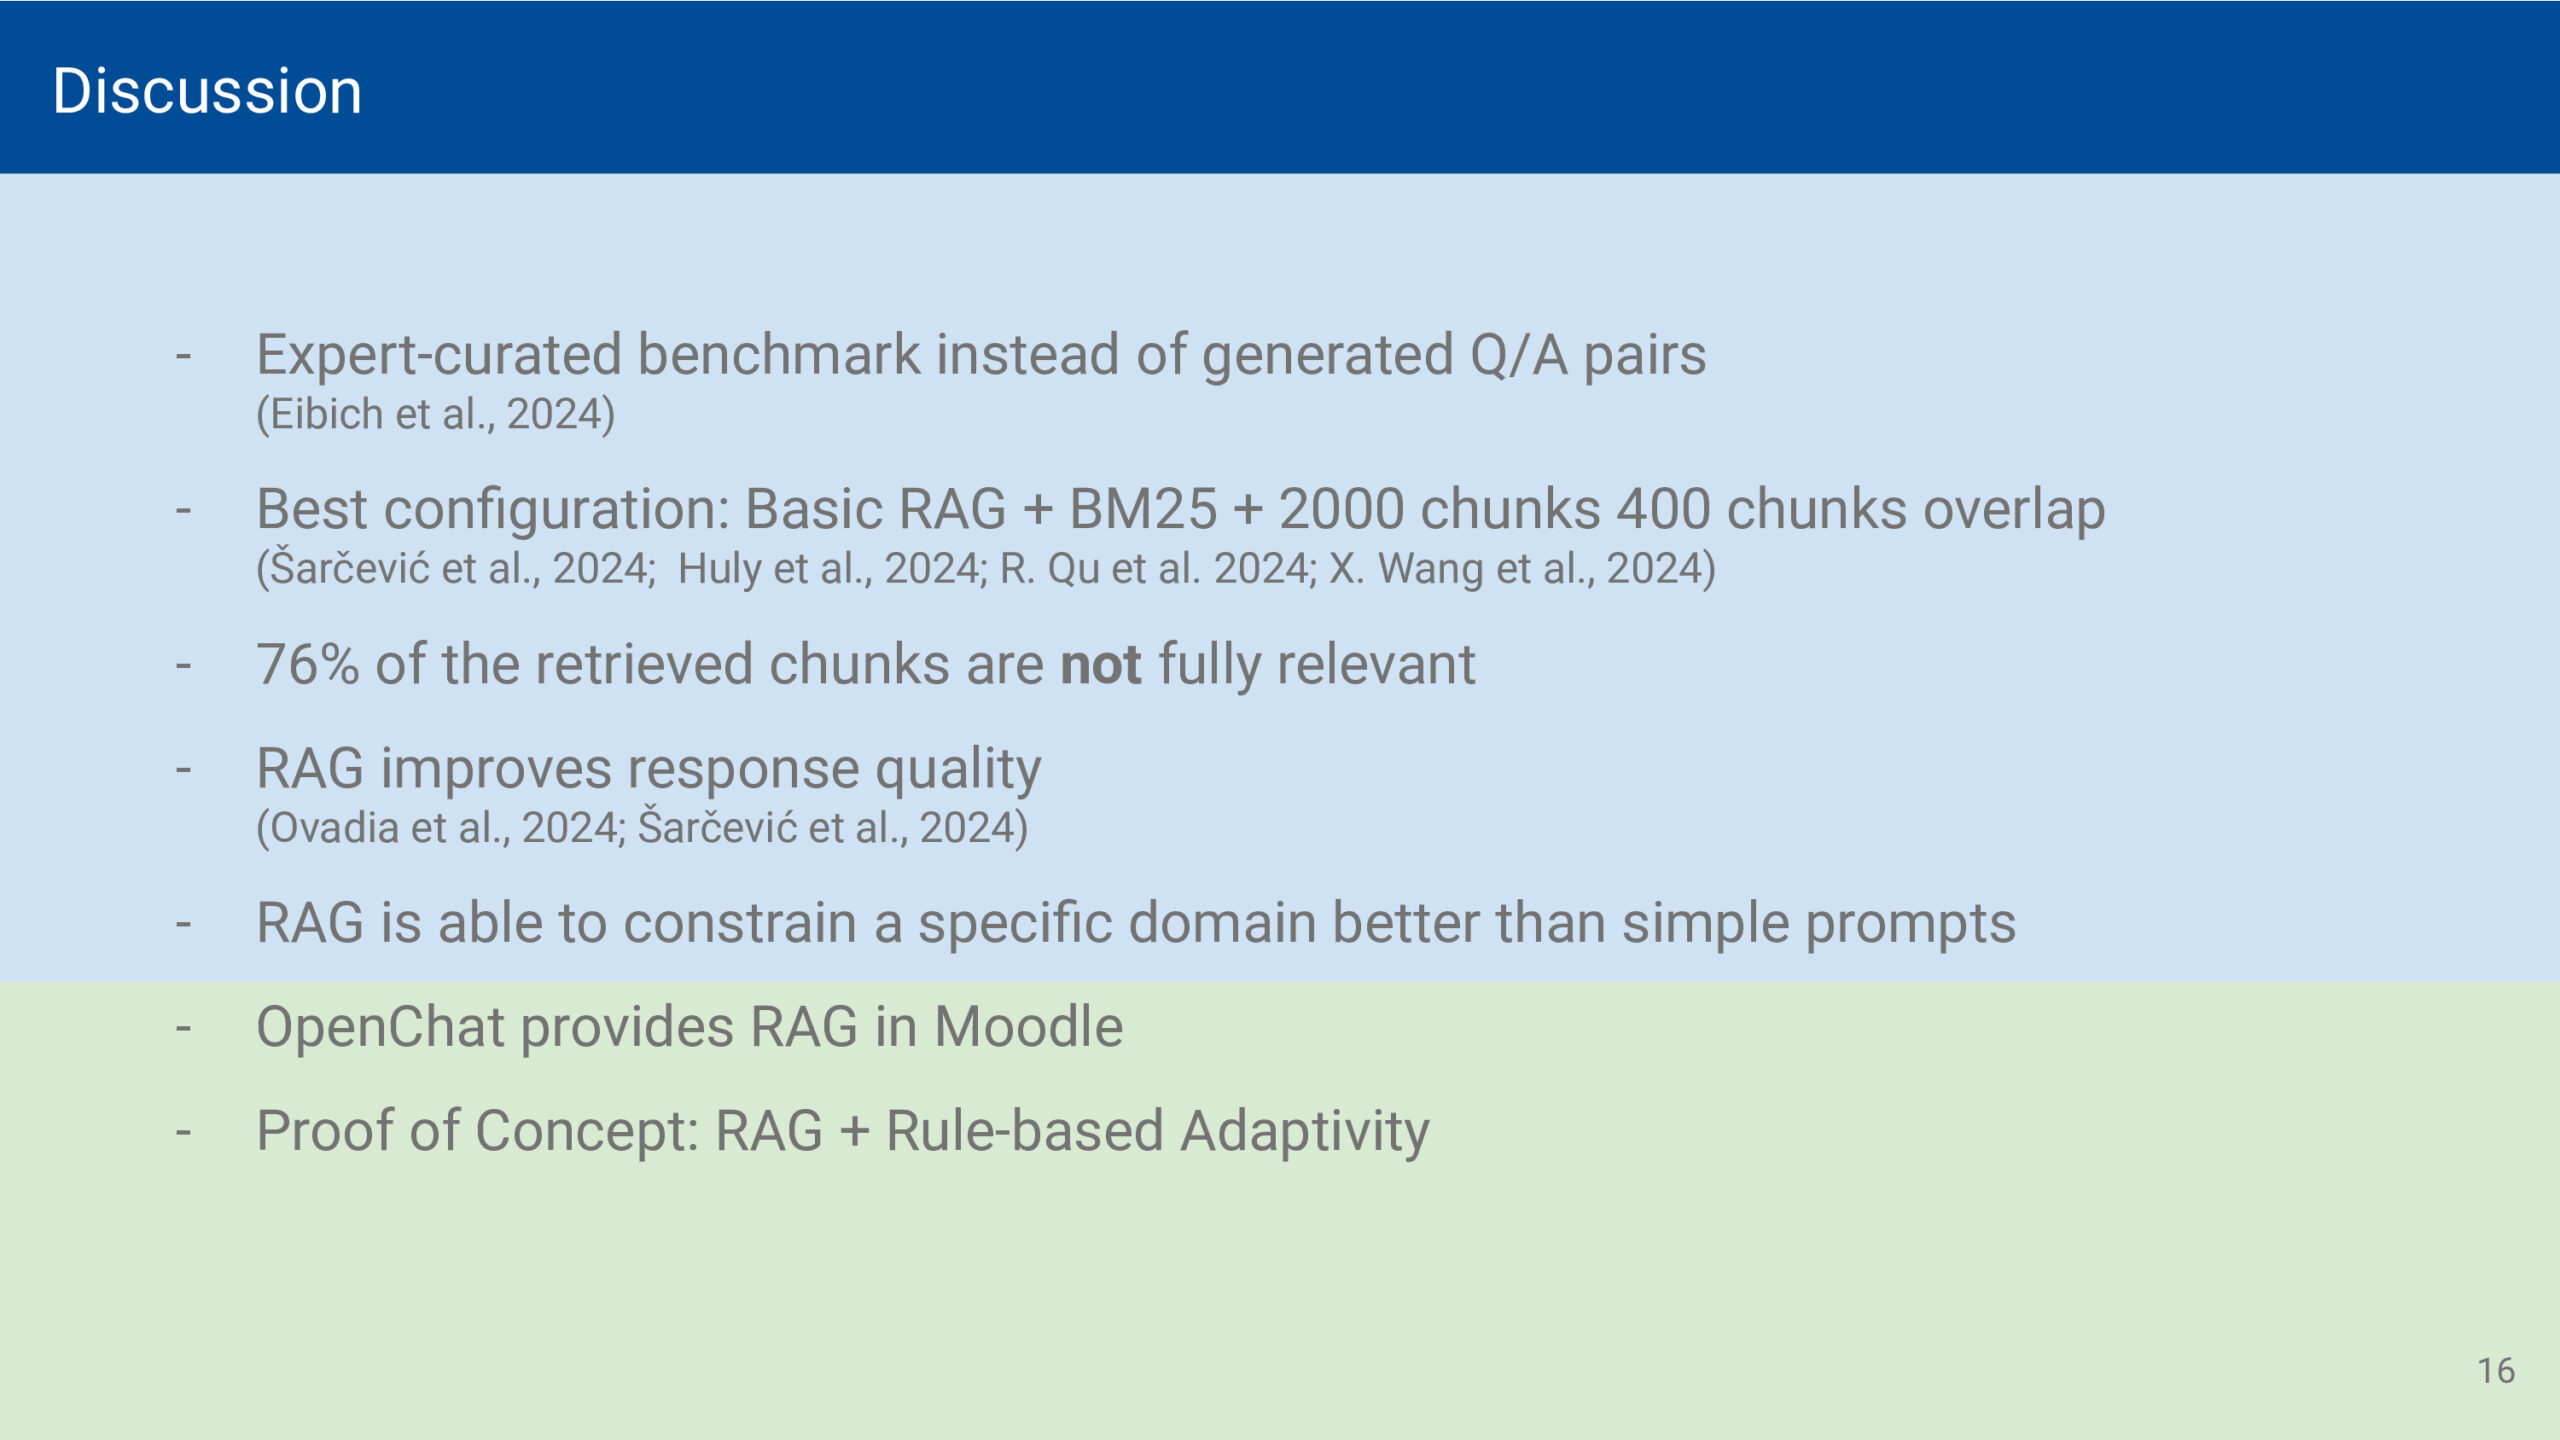
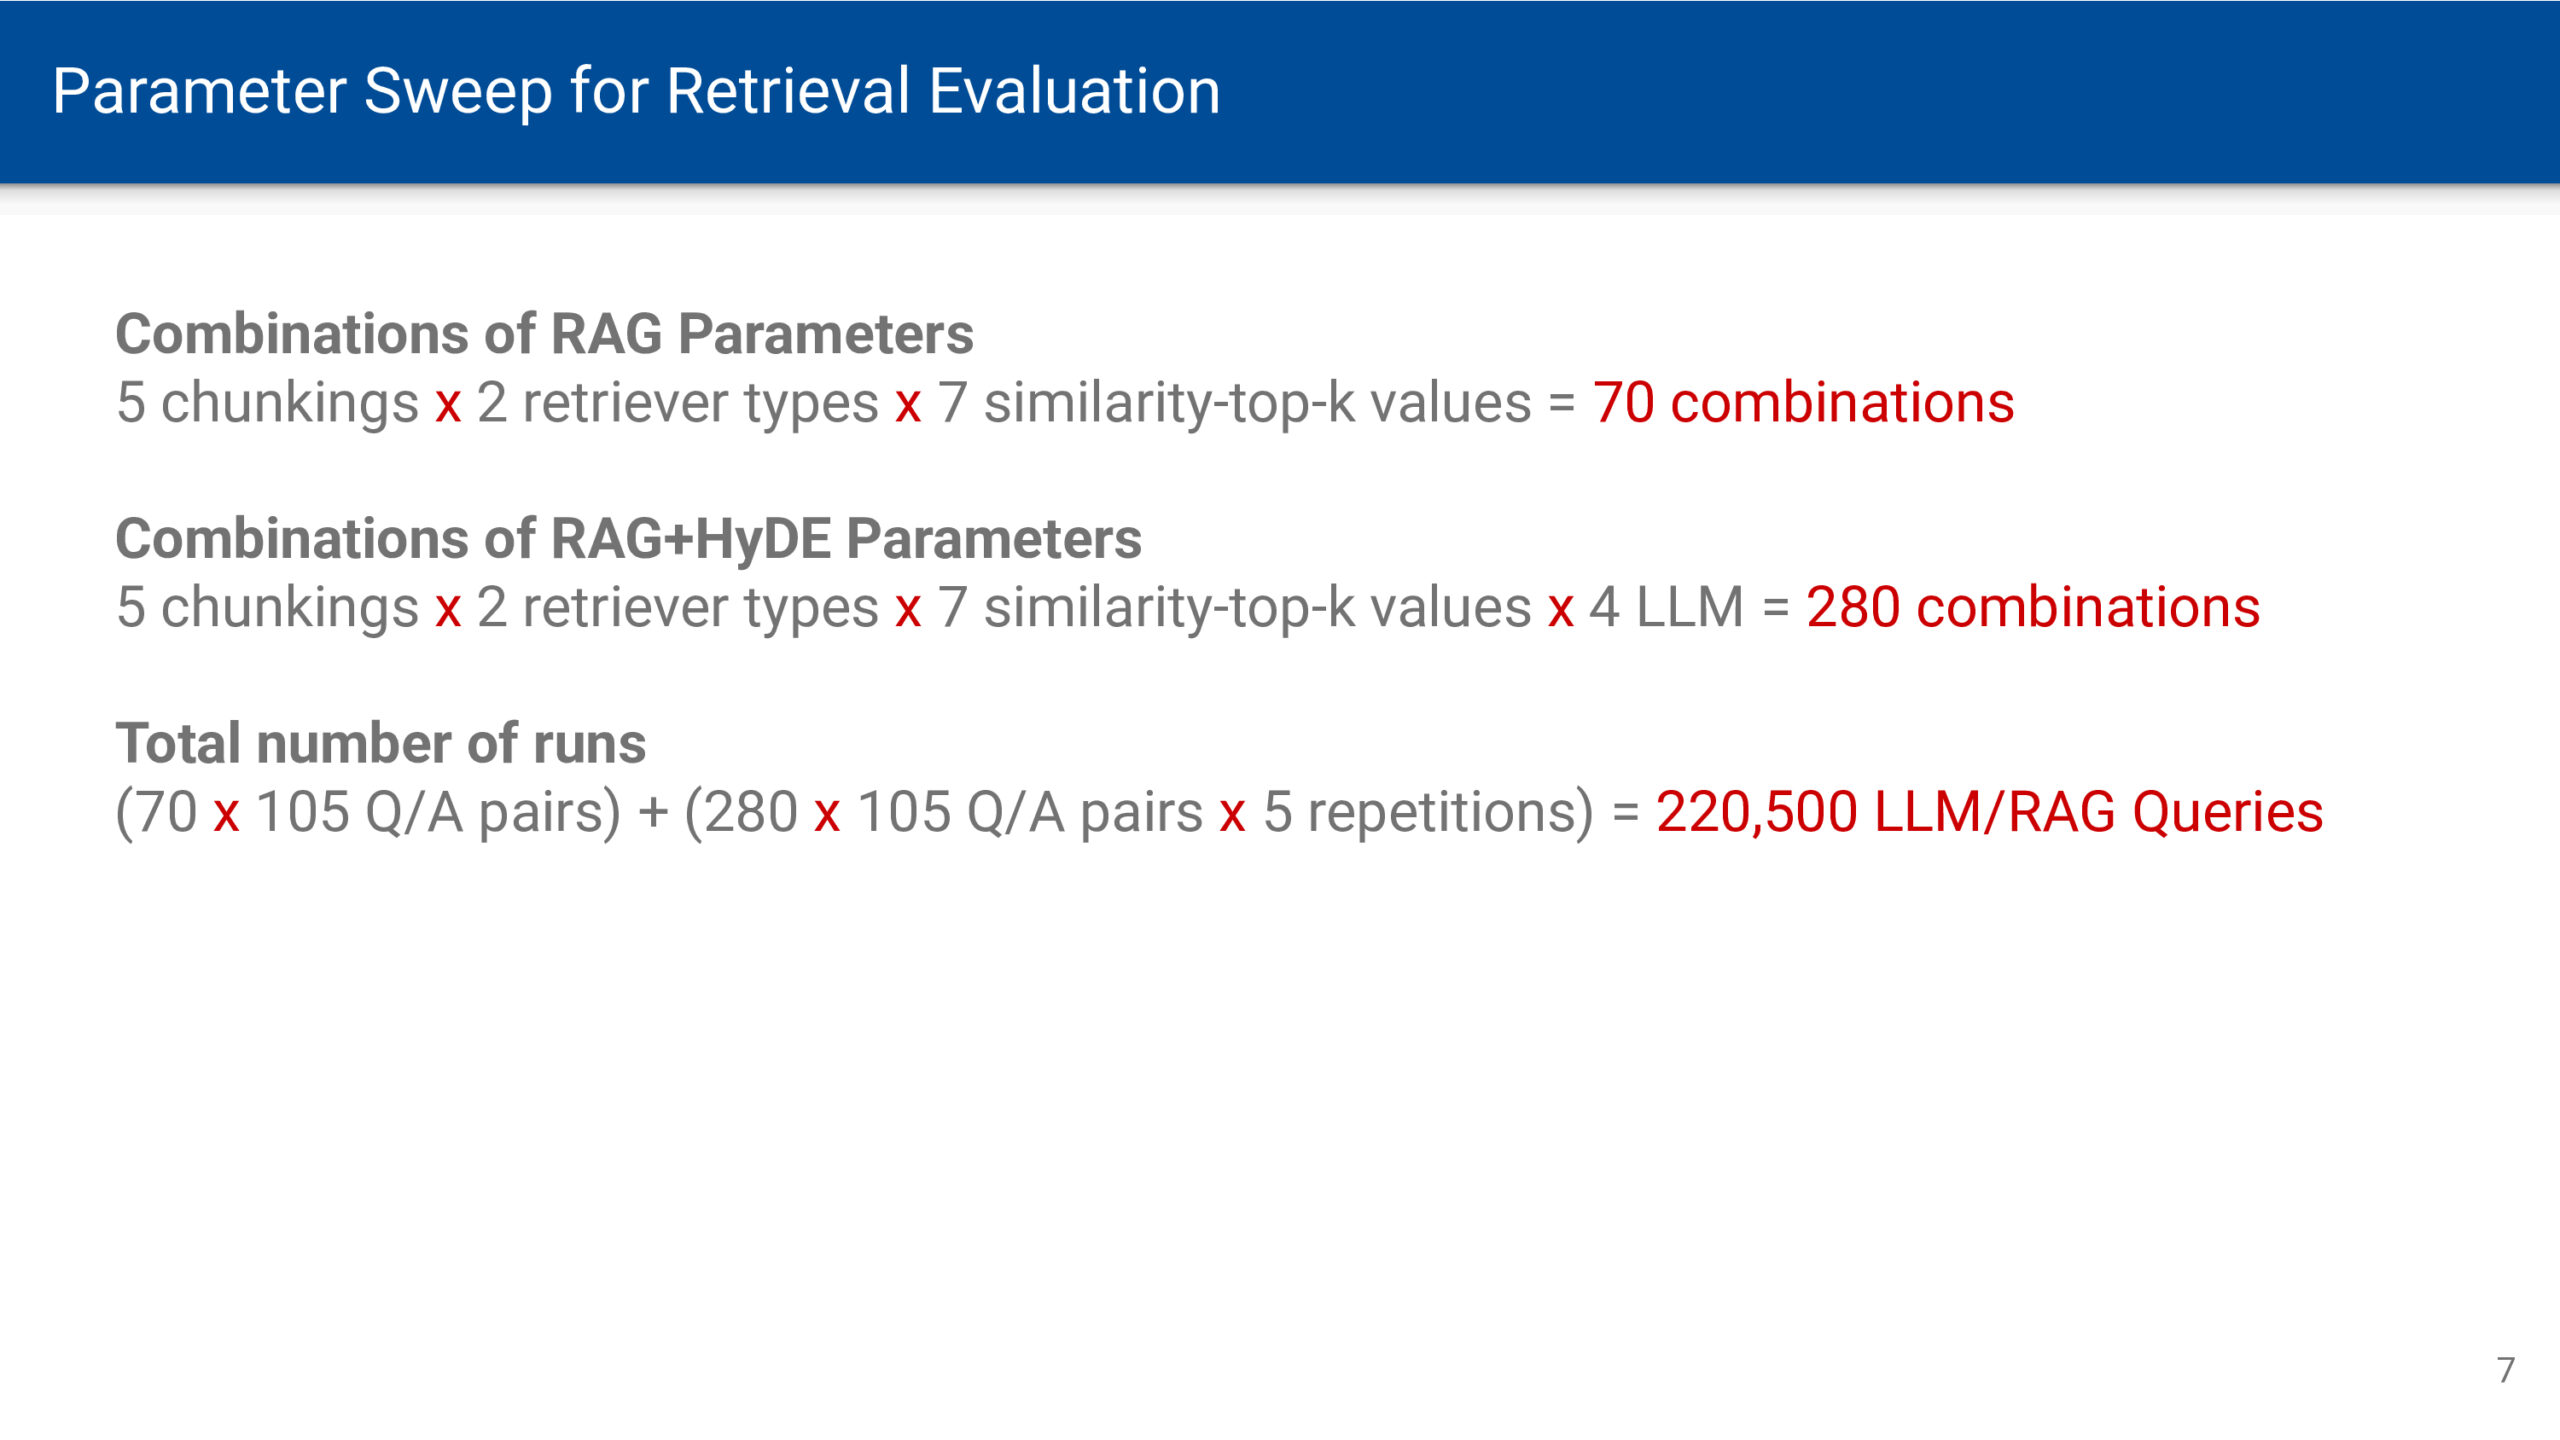
  • Barbara Pampel: Regaining Control: Enabling Educators to Build Specialized AI Chat Bots with Retrieval Augmented Generation. Barbara presented an interesting setup for implementing RAG in higher education. While RAG is a potential killer-app for using LLM in higher education, it is not very common yet. The main reason for low utilisation is technical hurdles in the implementation. RAG requires a good command of Python, including the main libraries that provide RAG functionality (e.g., langchain) and some web engineering knowledge for suitable integrations into existing tools. Barbara, however, came up with Flowise to implement RAG in a workflow-like manner. Furthermore, she and her colleagues taught teachers how to set up processing pipelines and tweak parameters to get satisfying results. To my surprise, teachers accepted the technical complexity. As a side effect, they learnt much more about the technology behind than anyone else playing with prompts in the chats.
  • Tina John: Implementing European Digital Credentials in Non-Formal Education: A Prototype for the Digital Learning Campus. Tina presented a straightforward solution for the technical implementation of Micro-Credentials. Everyone using Moodle at their institution can jump on the train, buy a seal for EU authorities, and become an issuer of Micro-Credentials.

In the following, I provide the slides of the three talks we had at CSEDU’25.

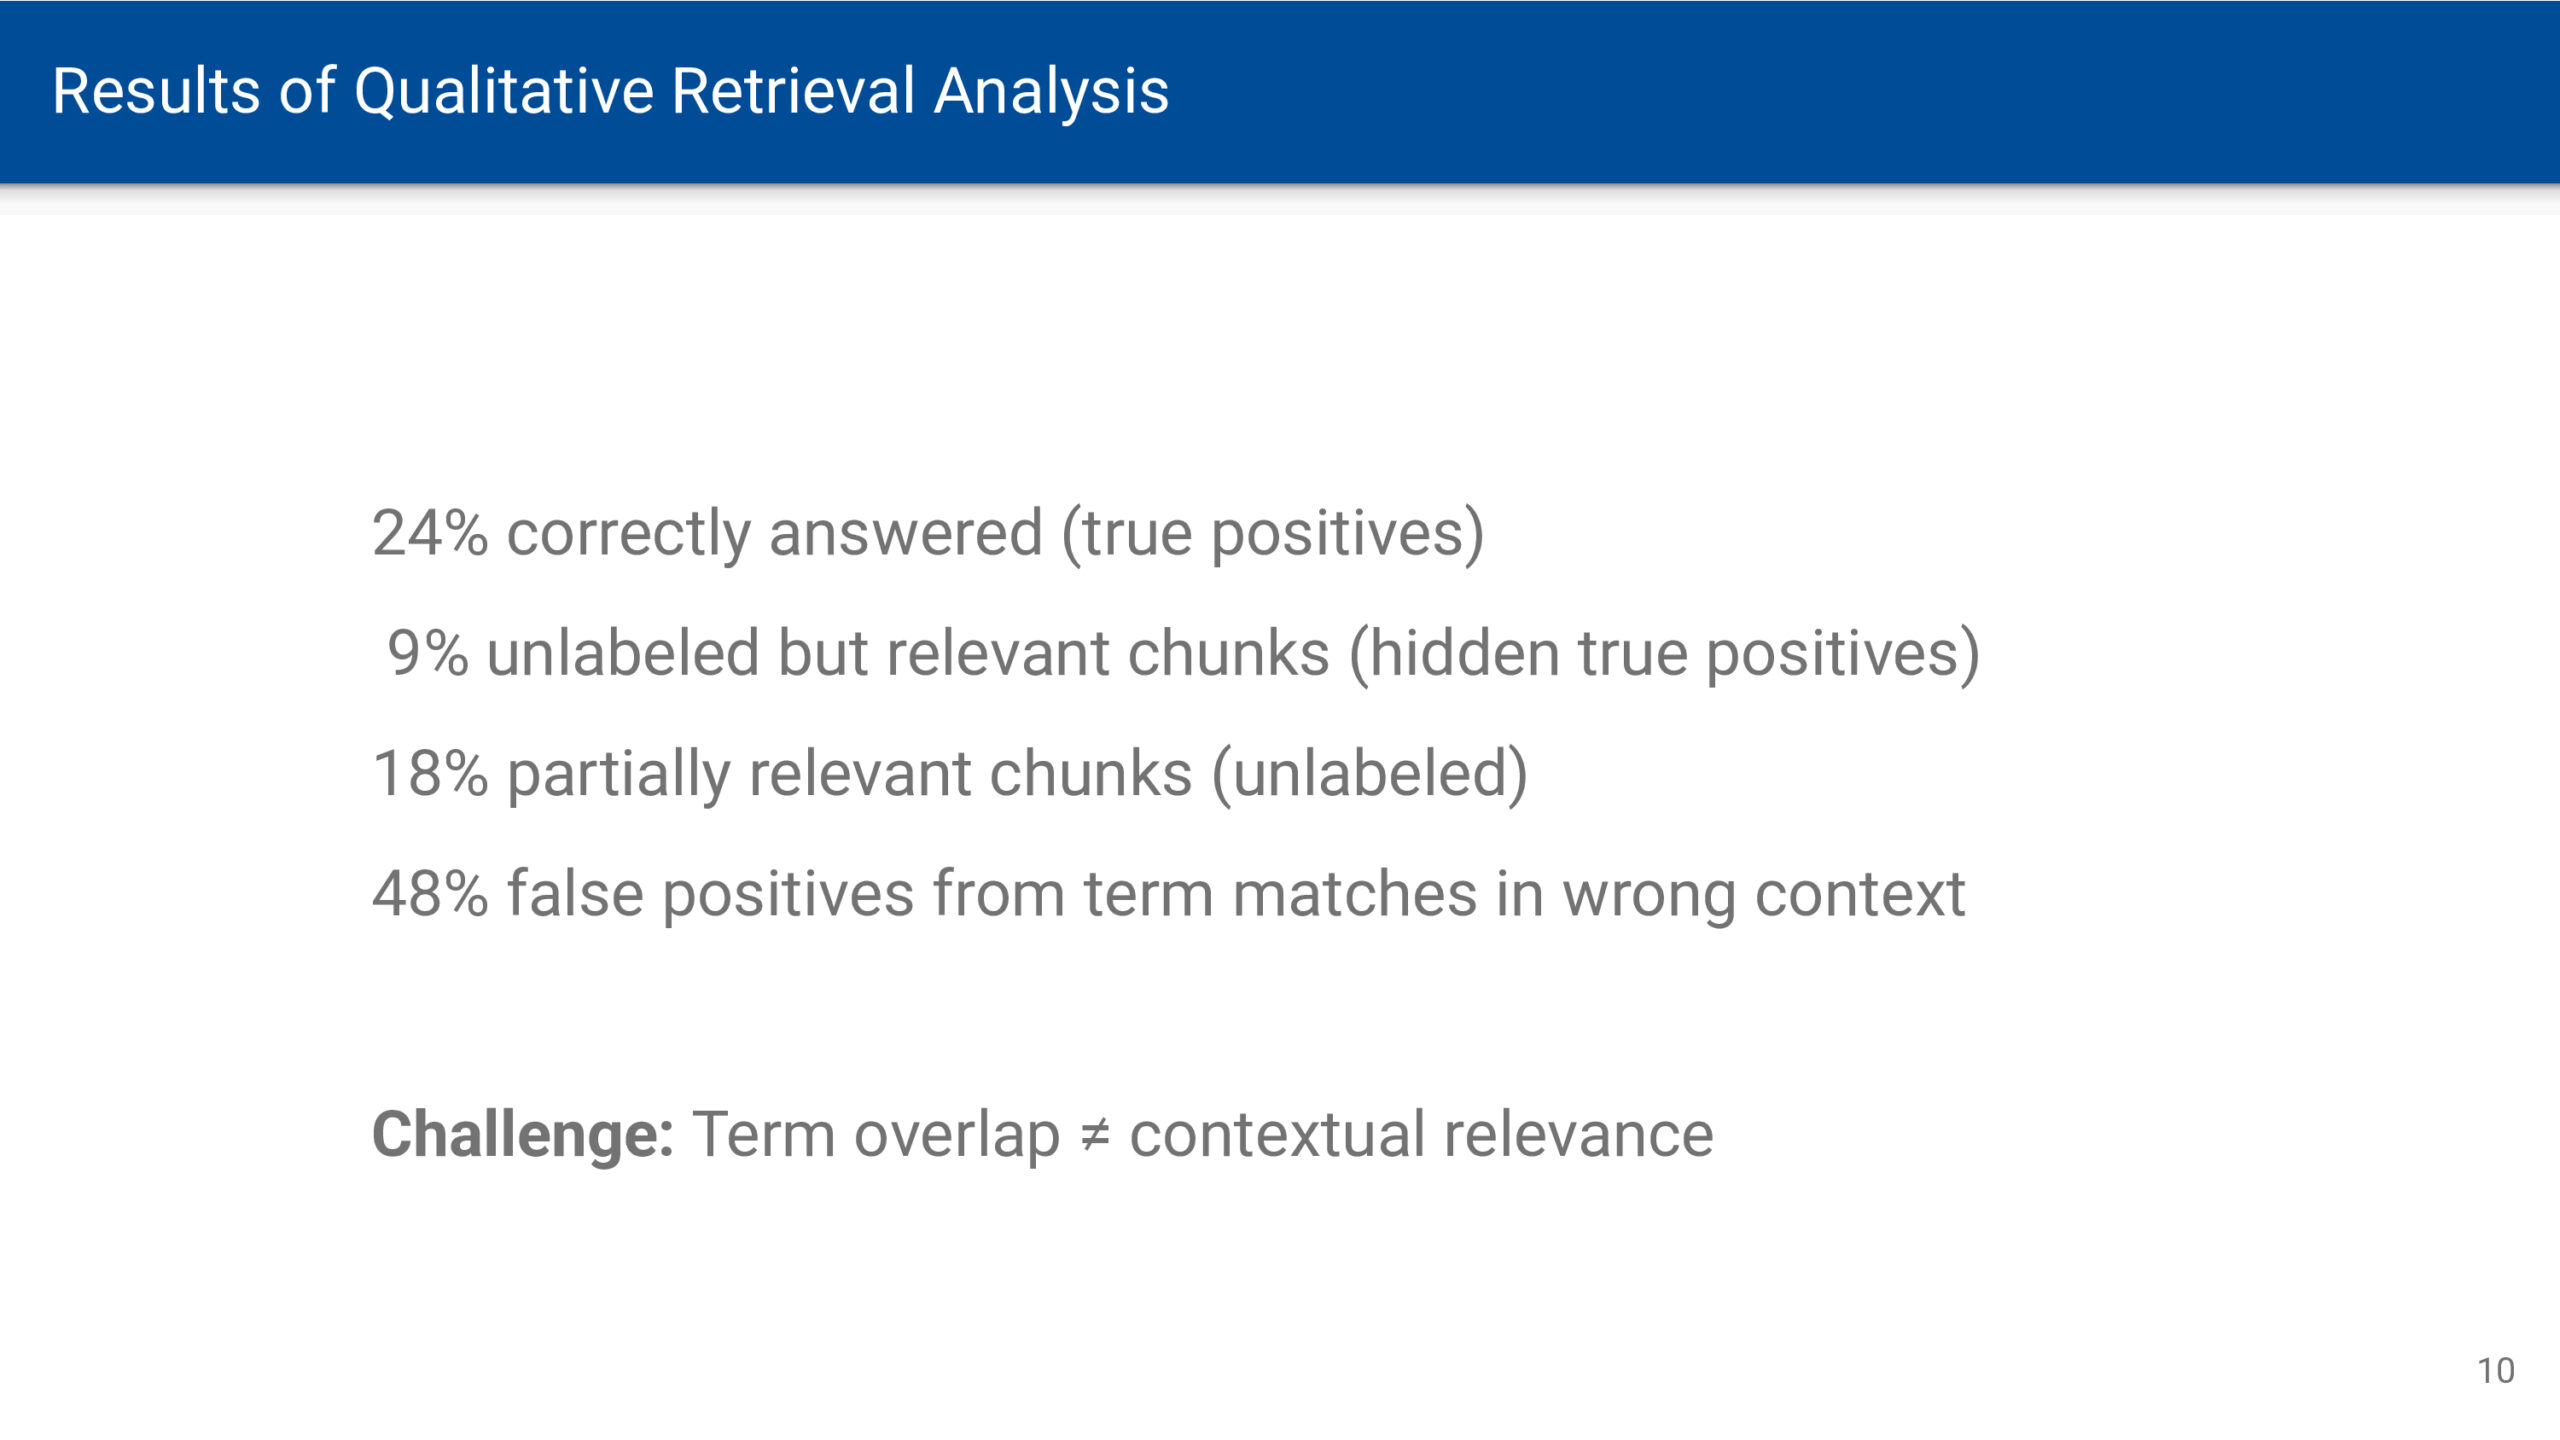
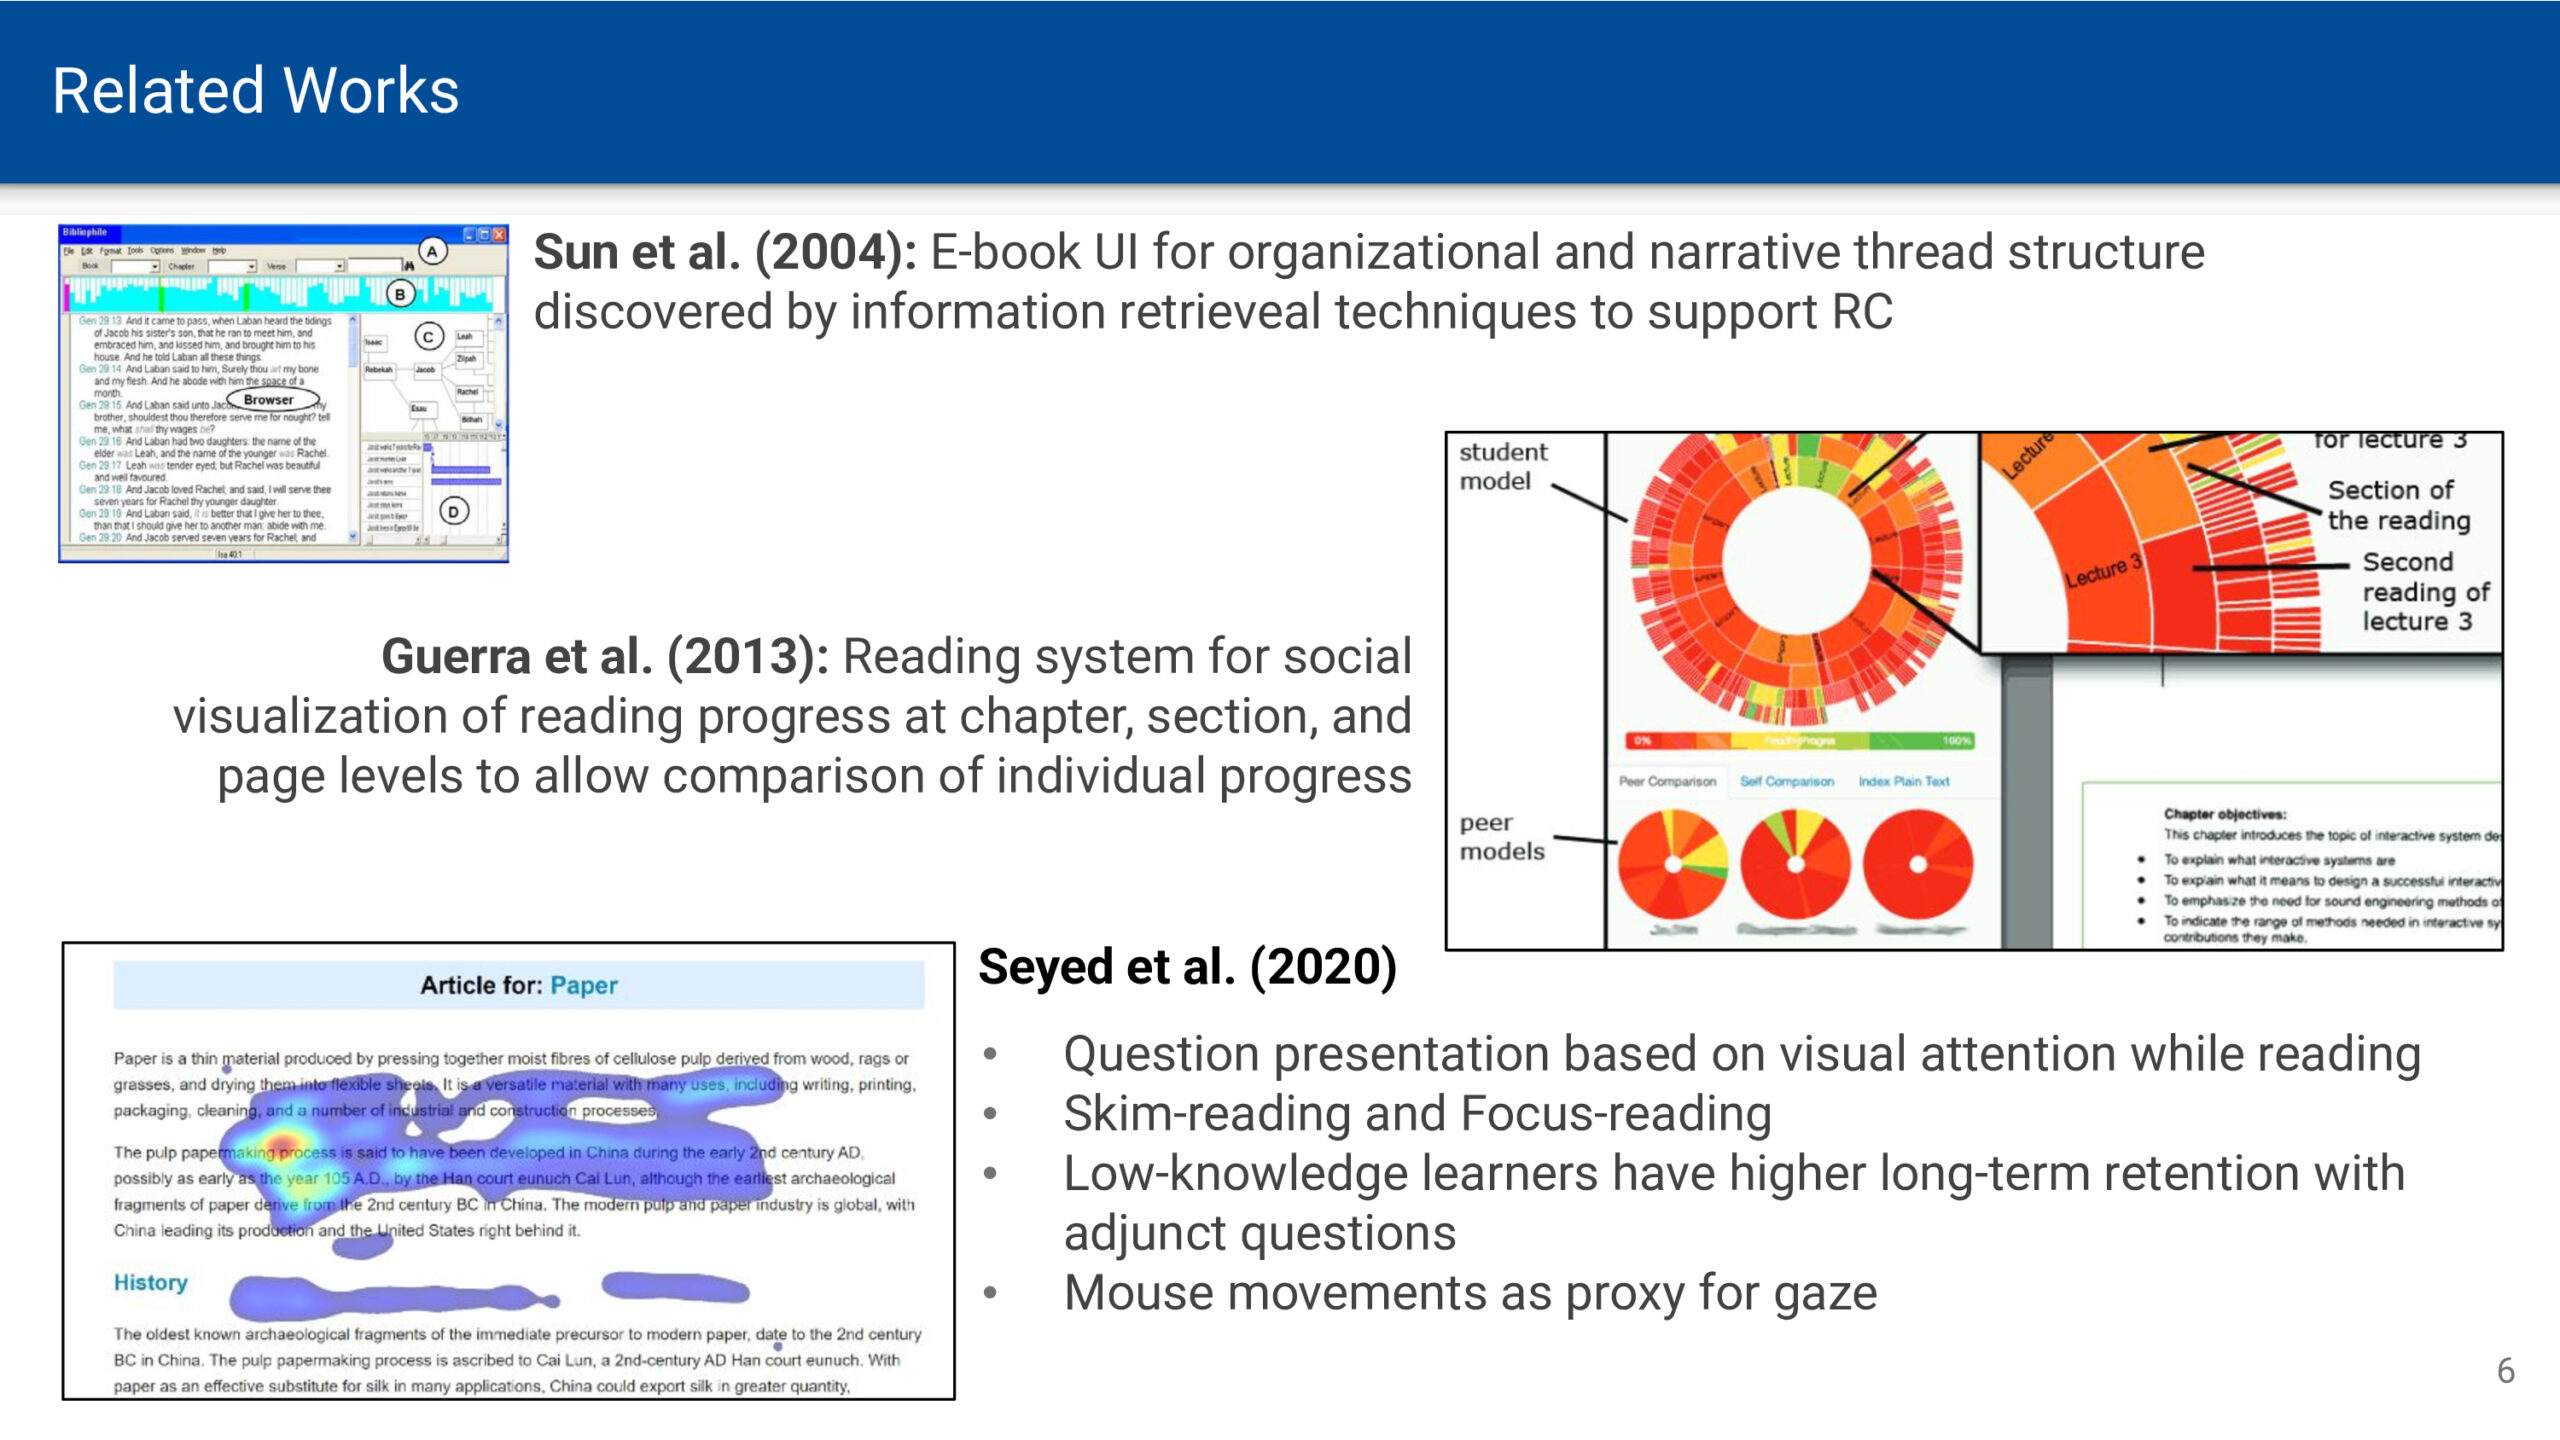
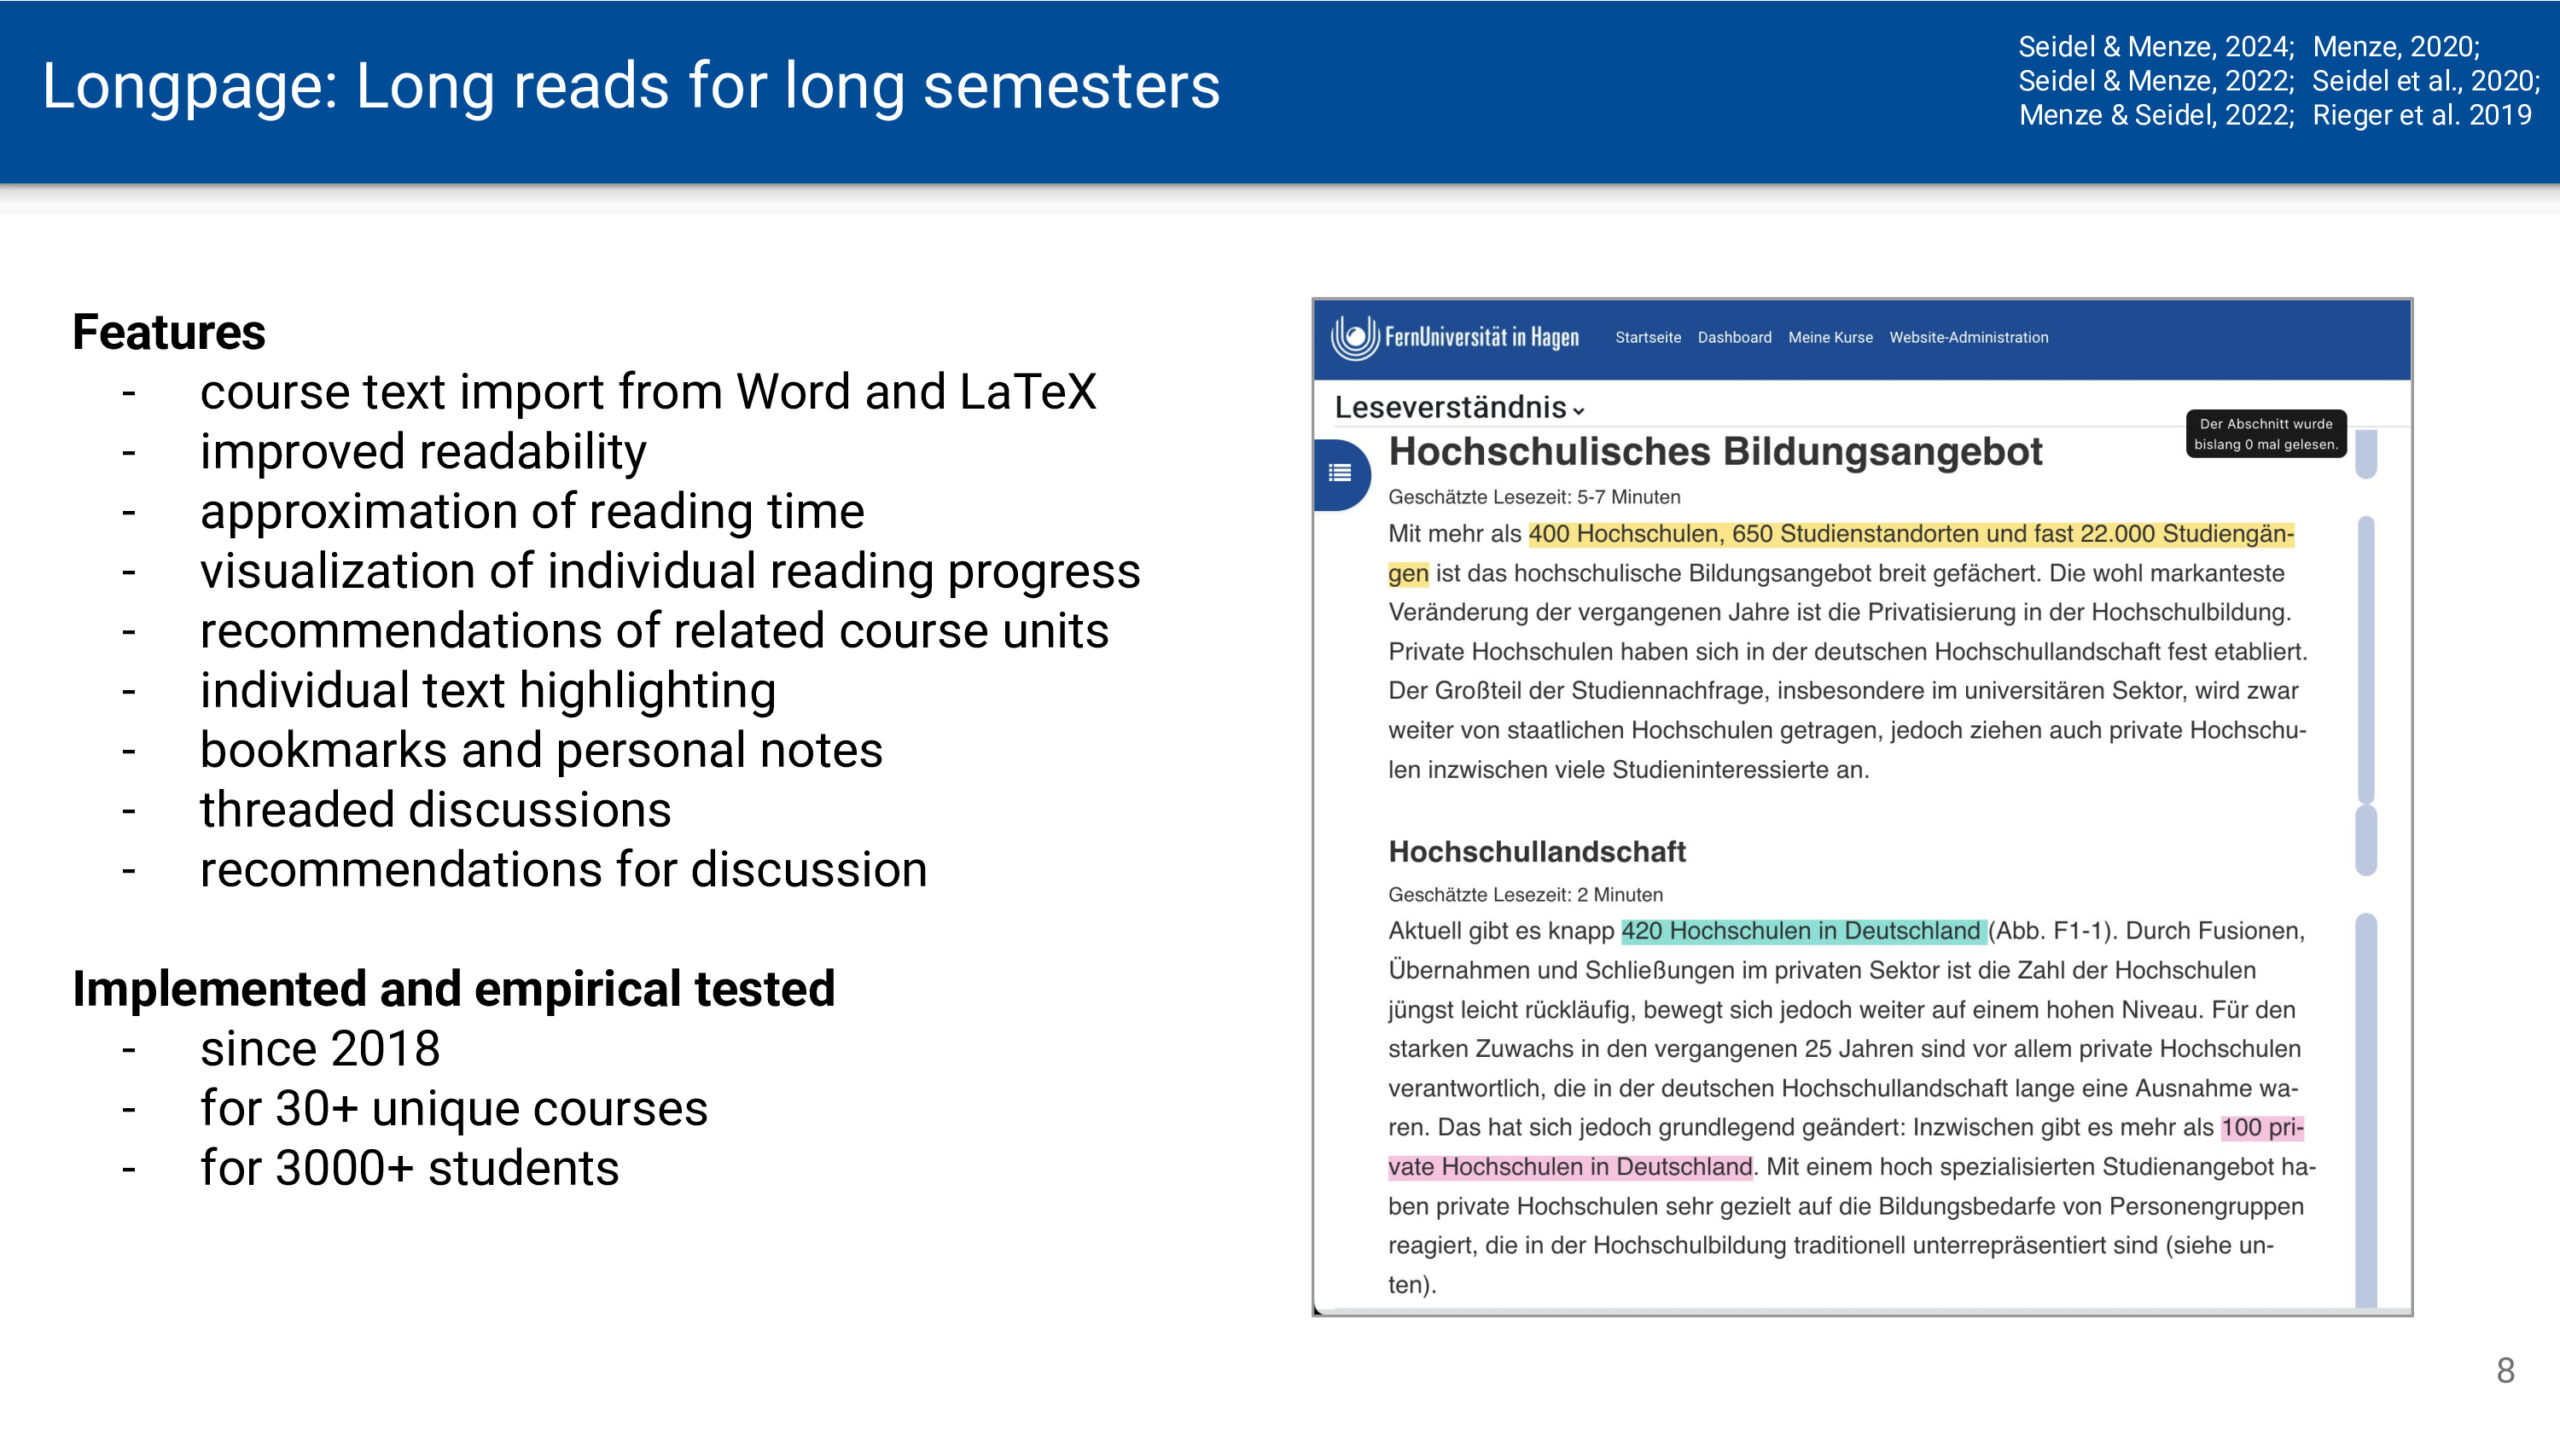
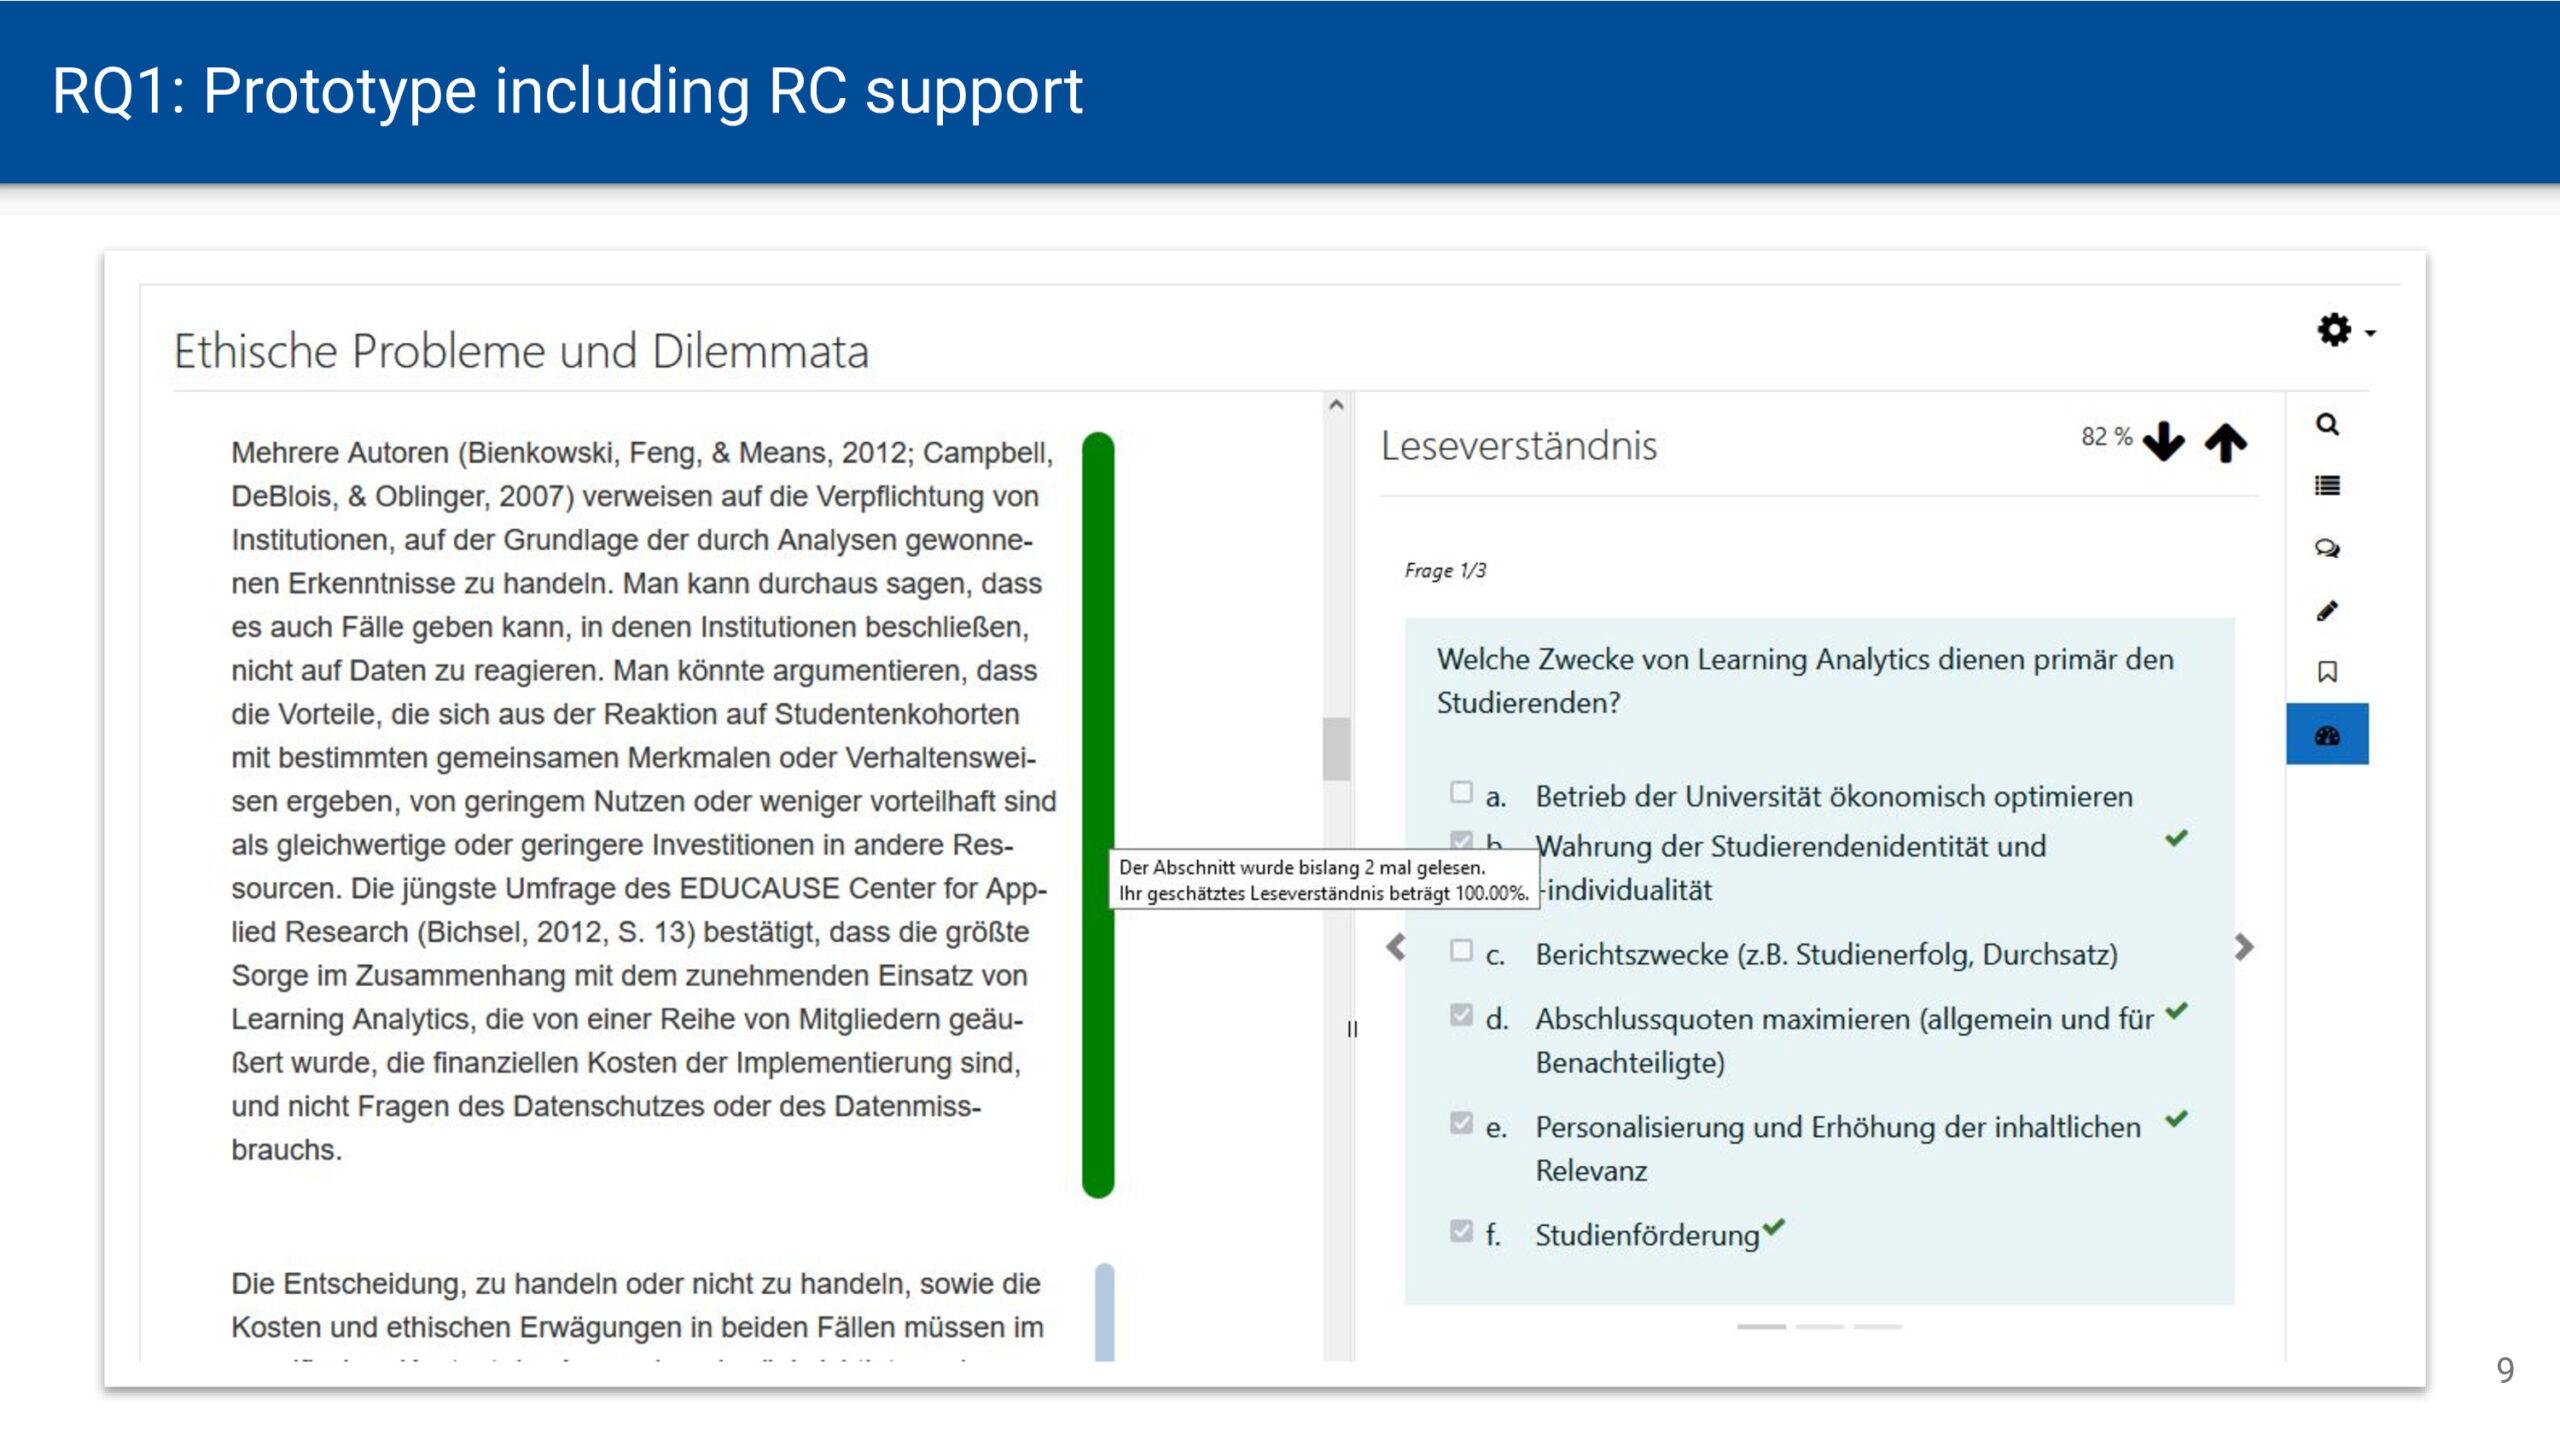
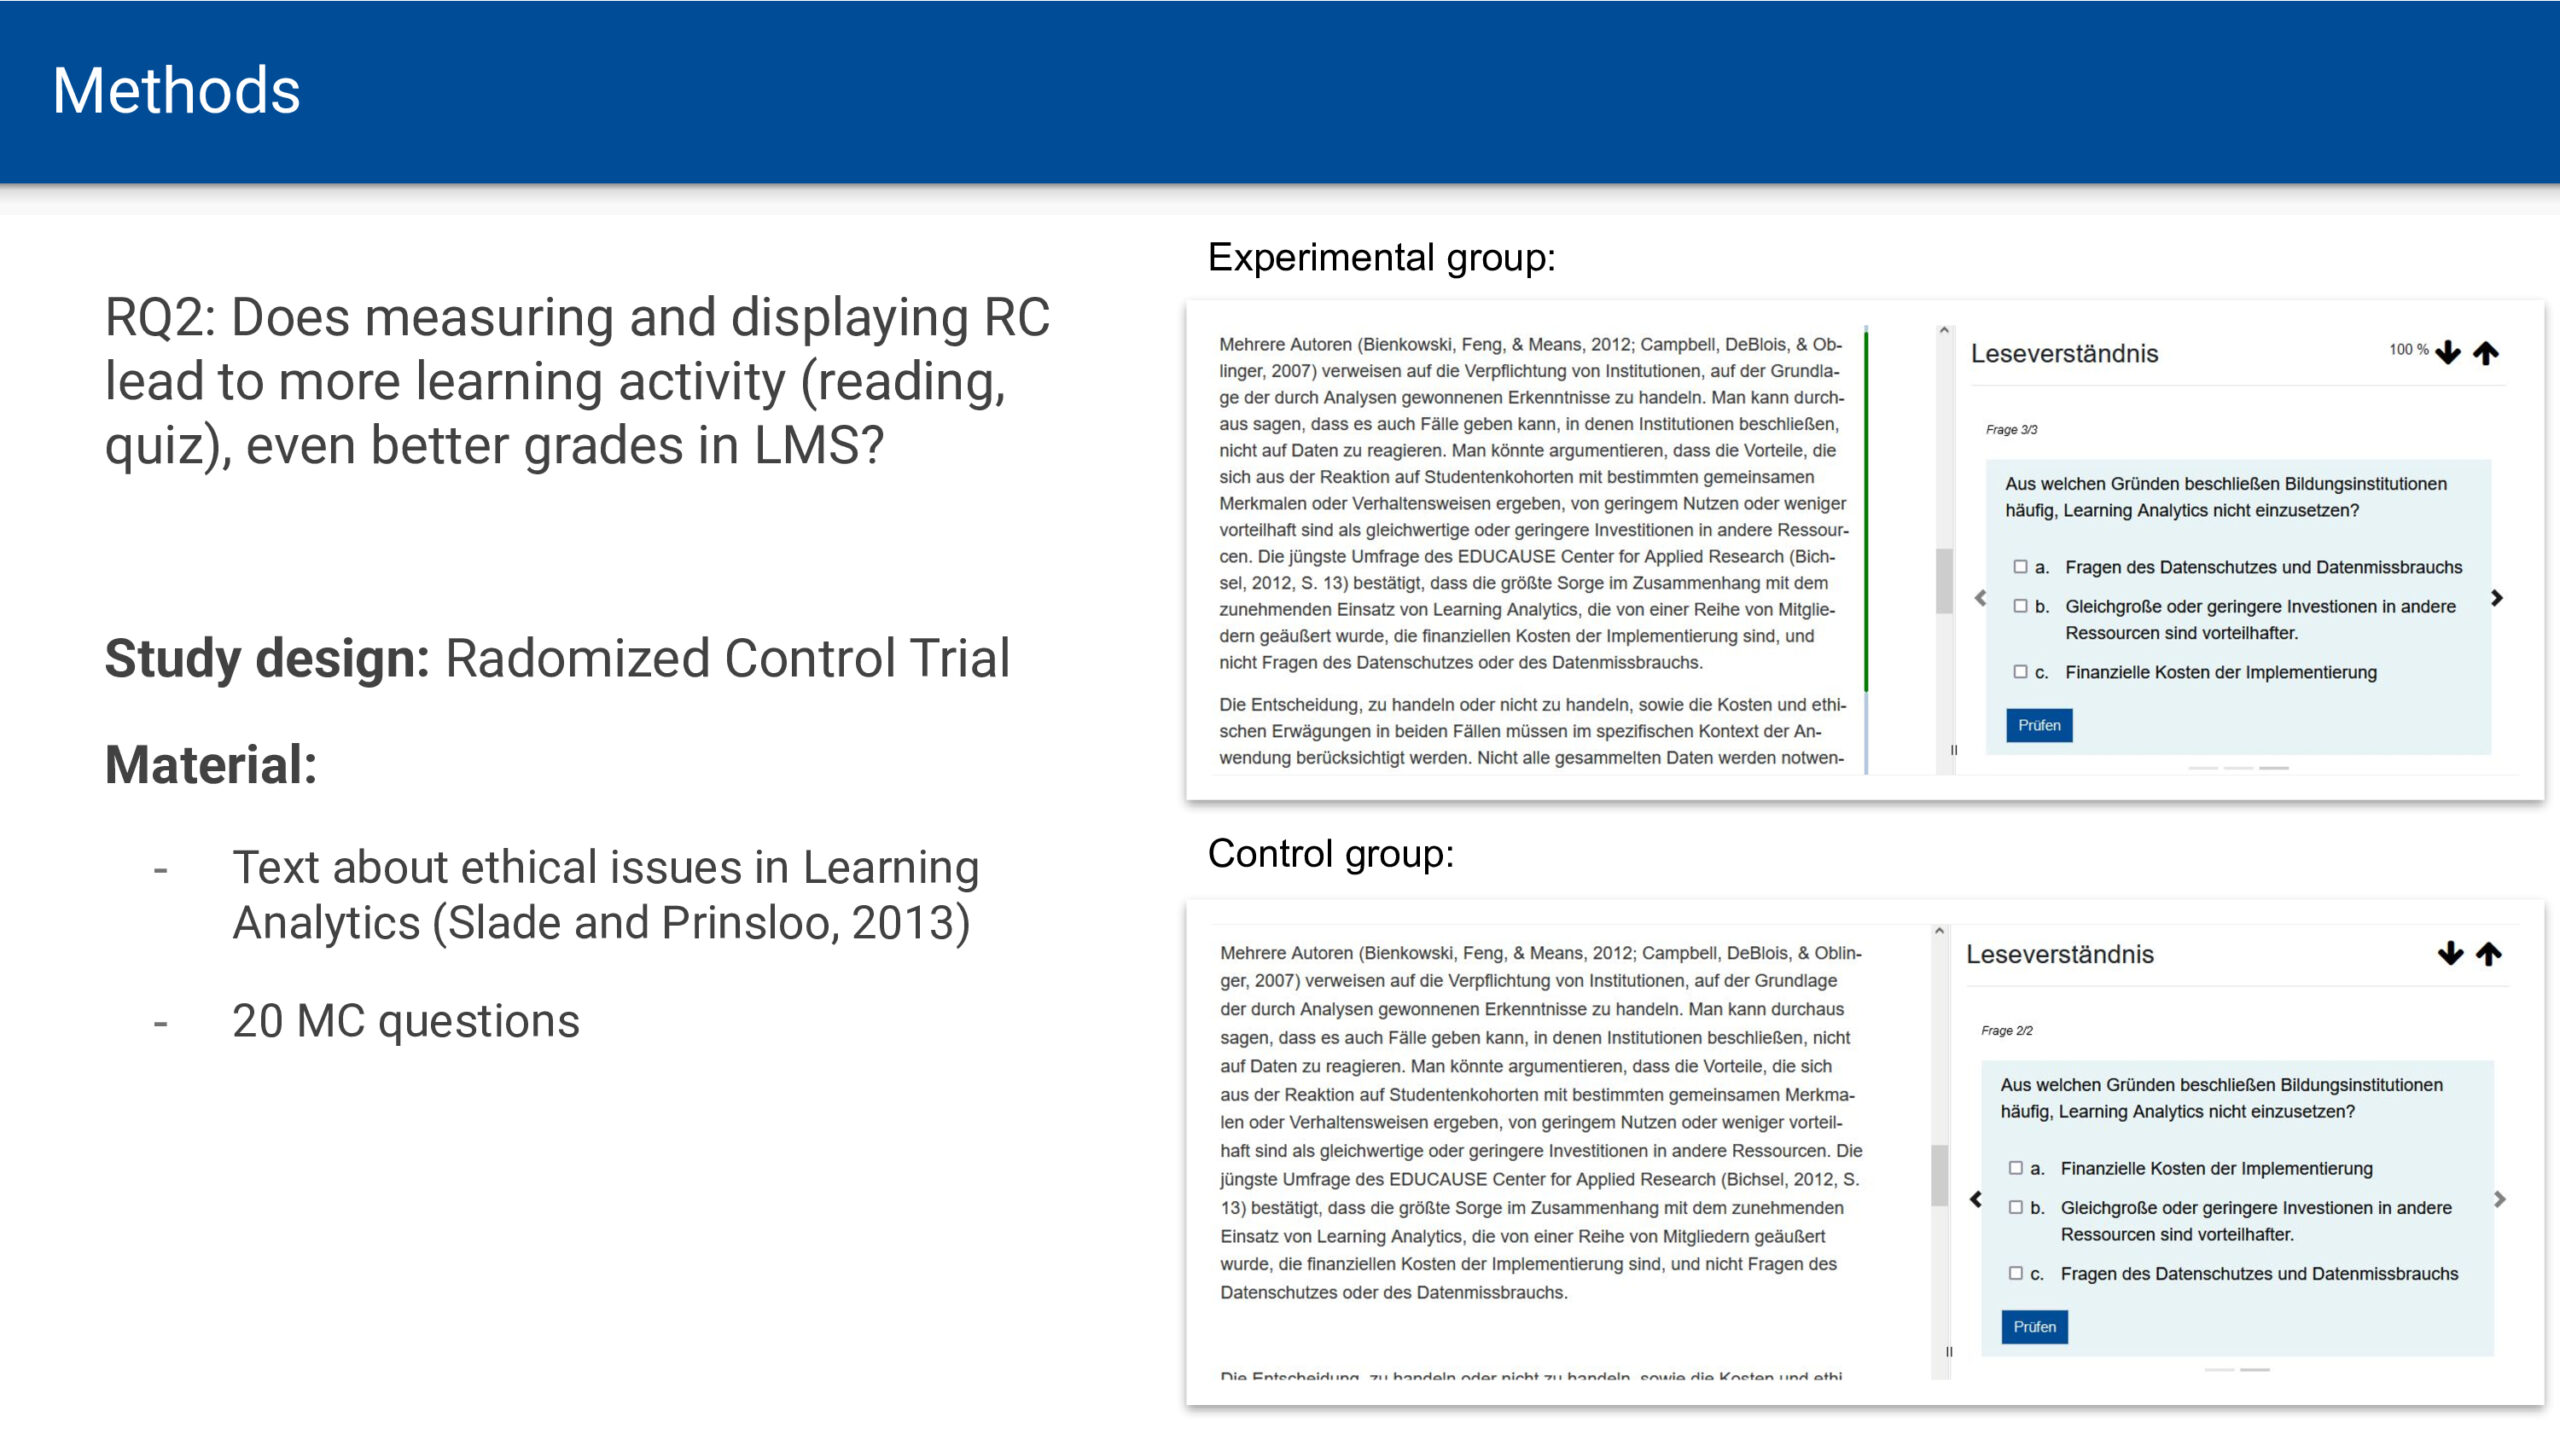
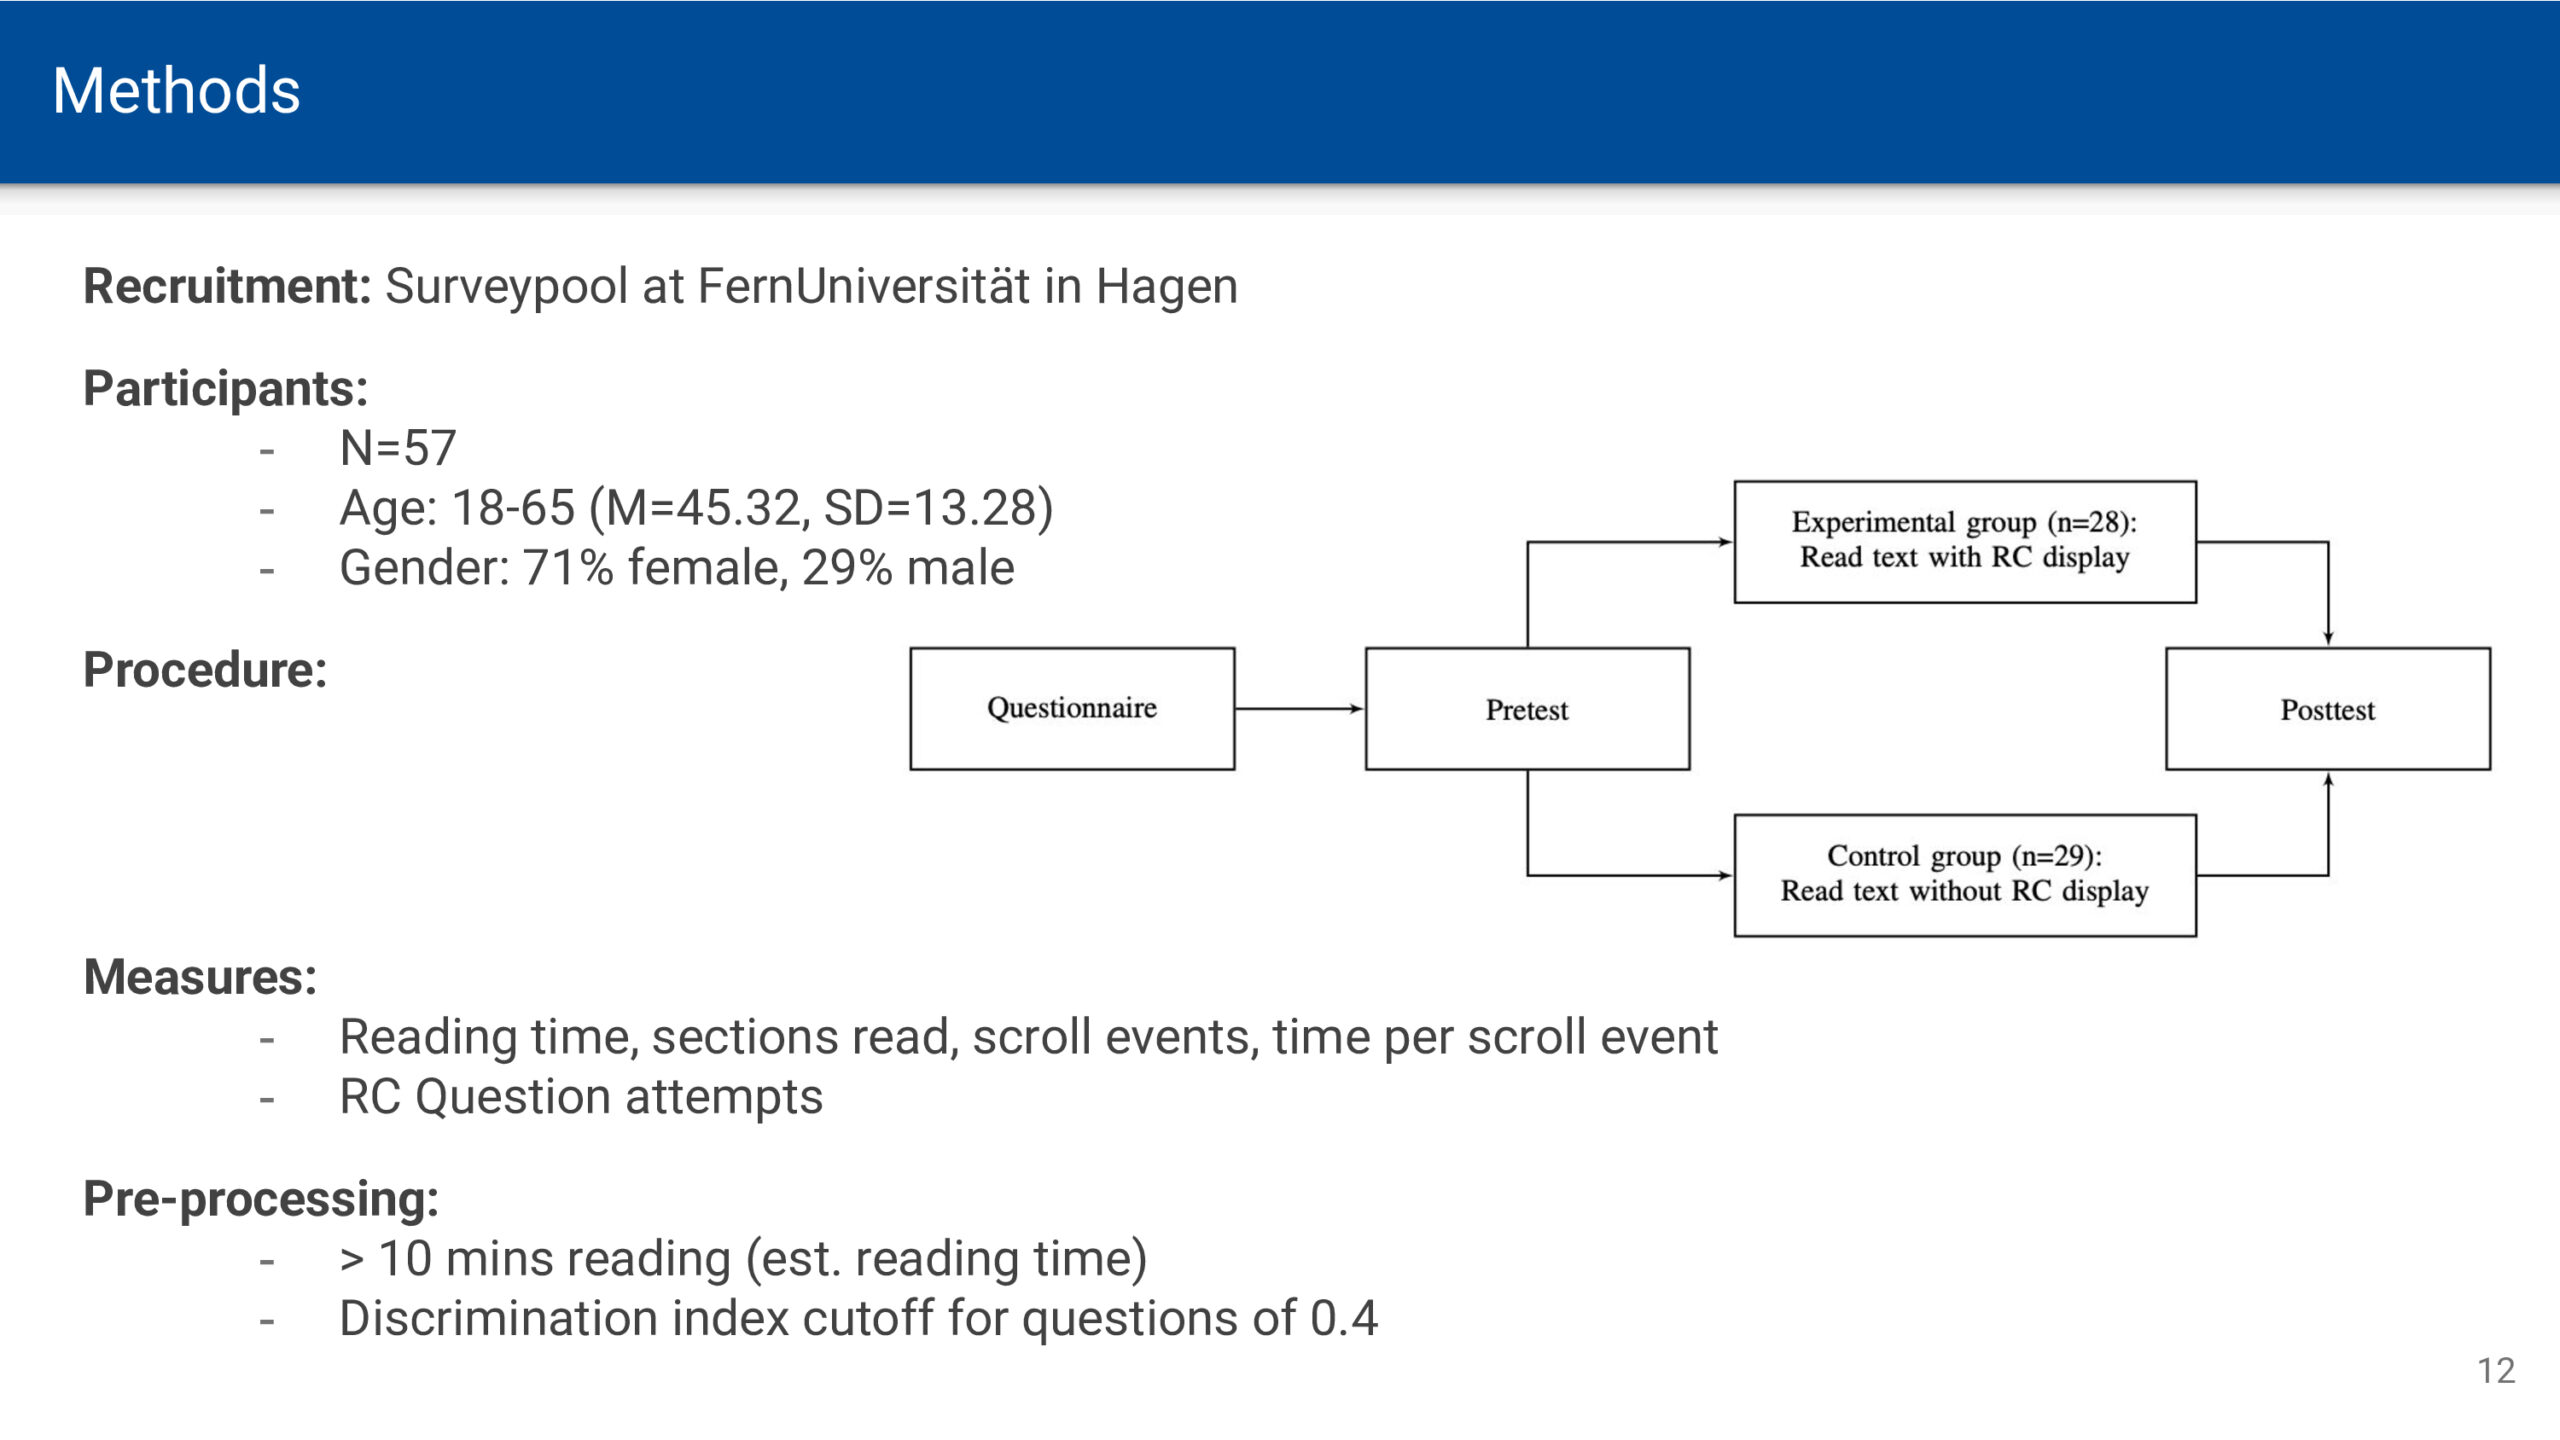
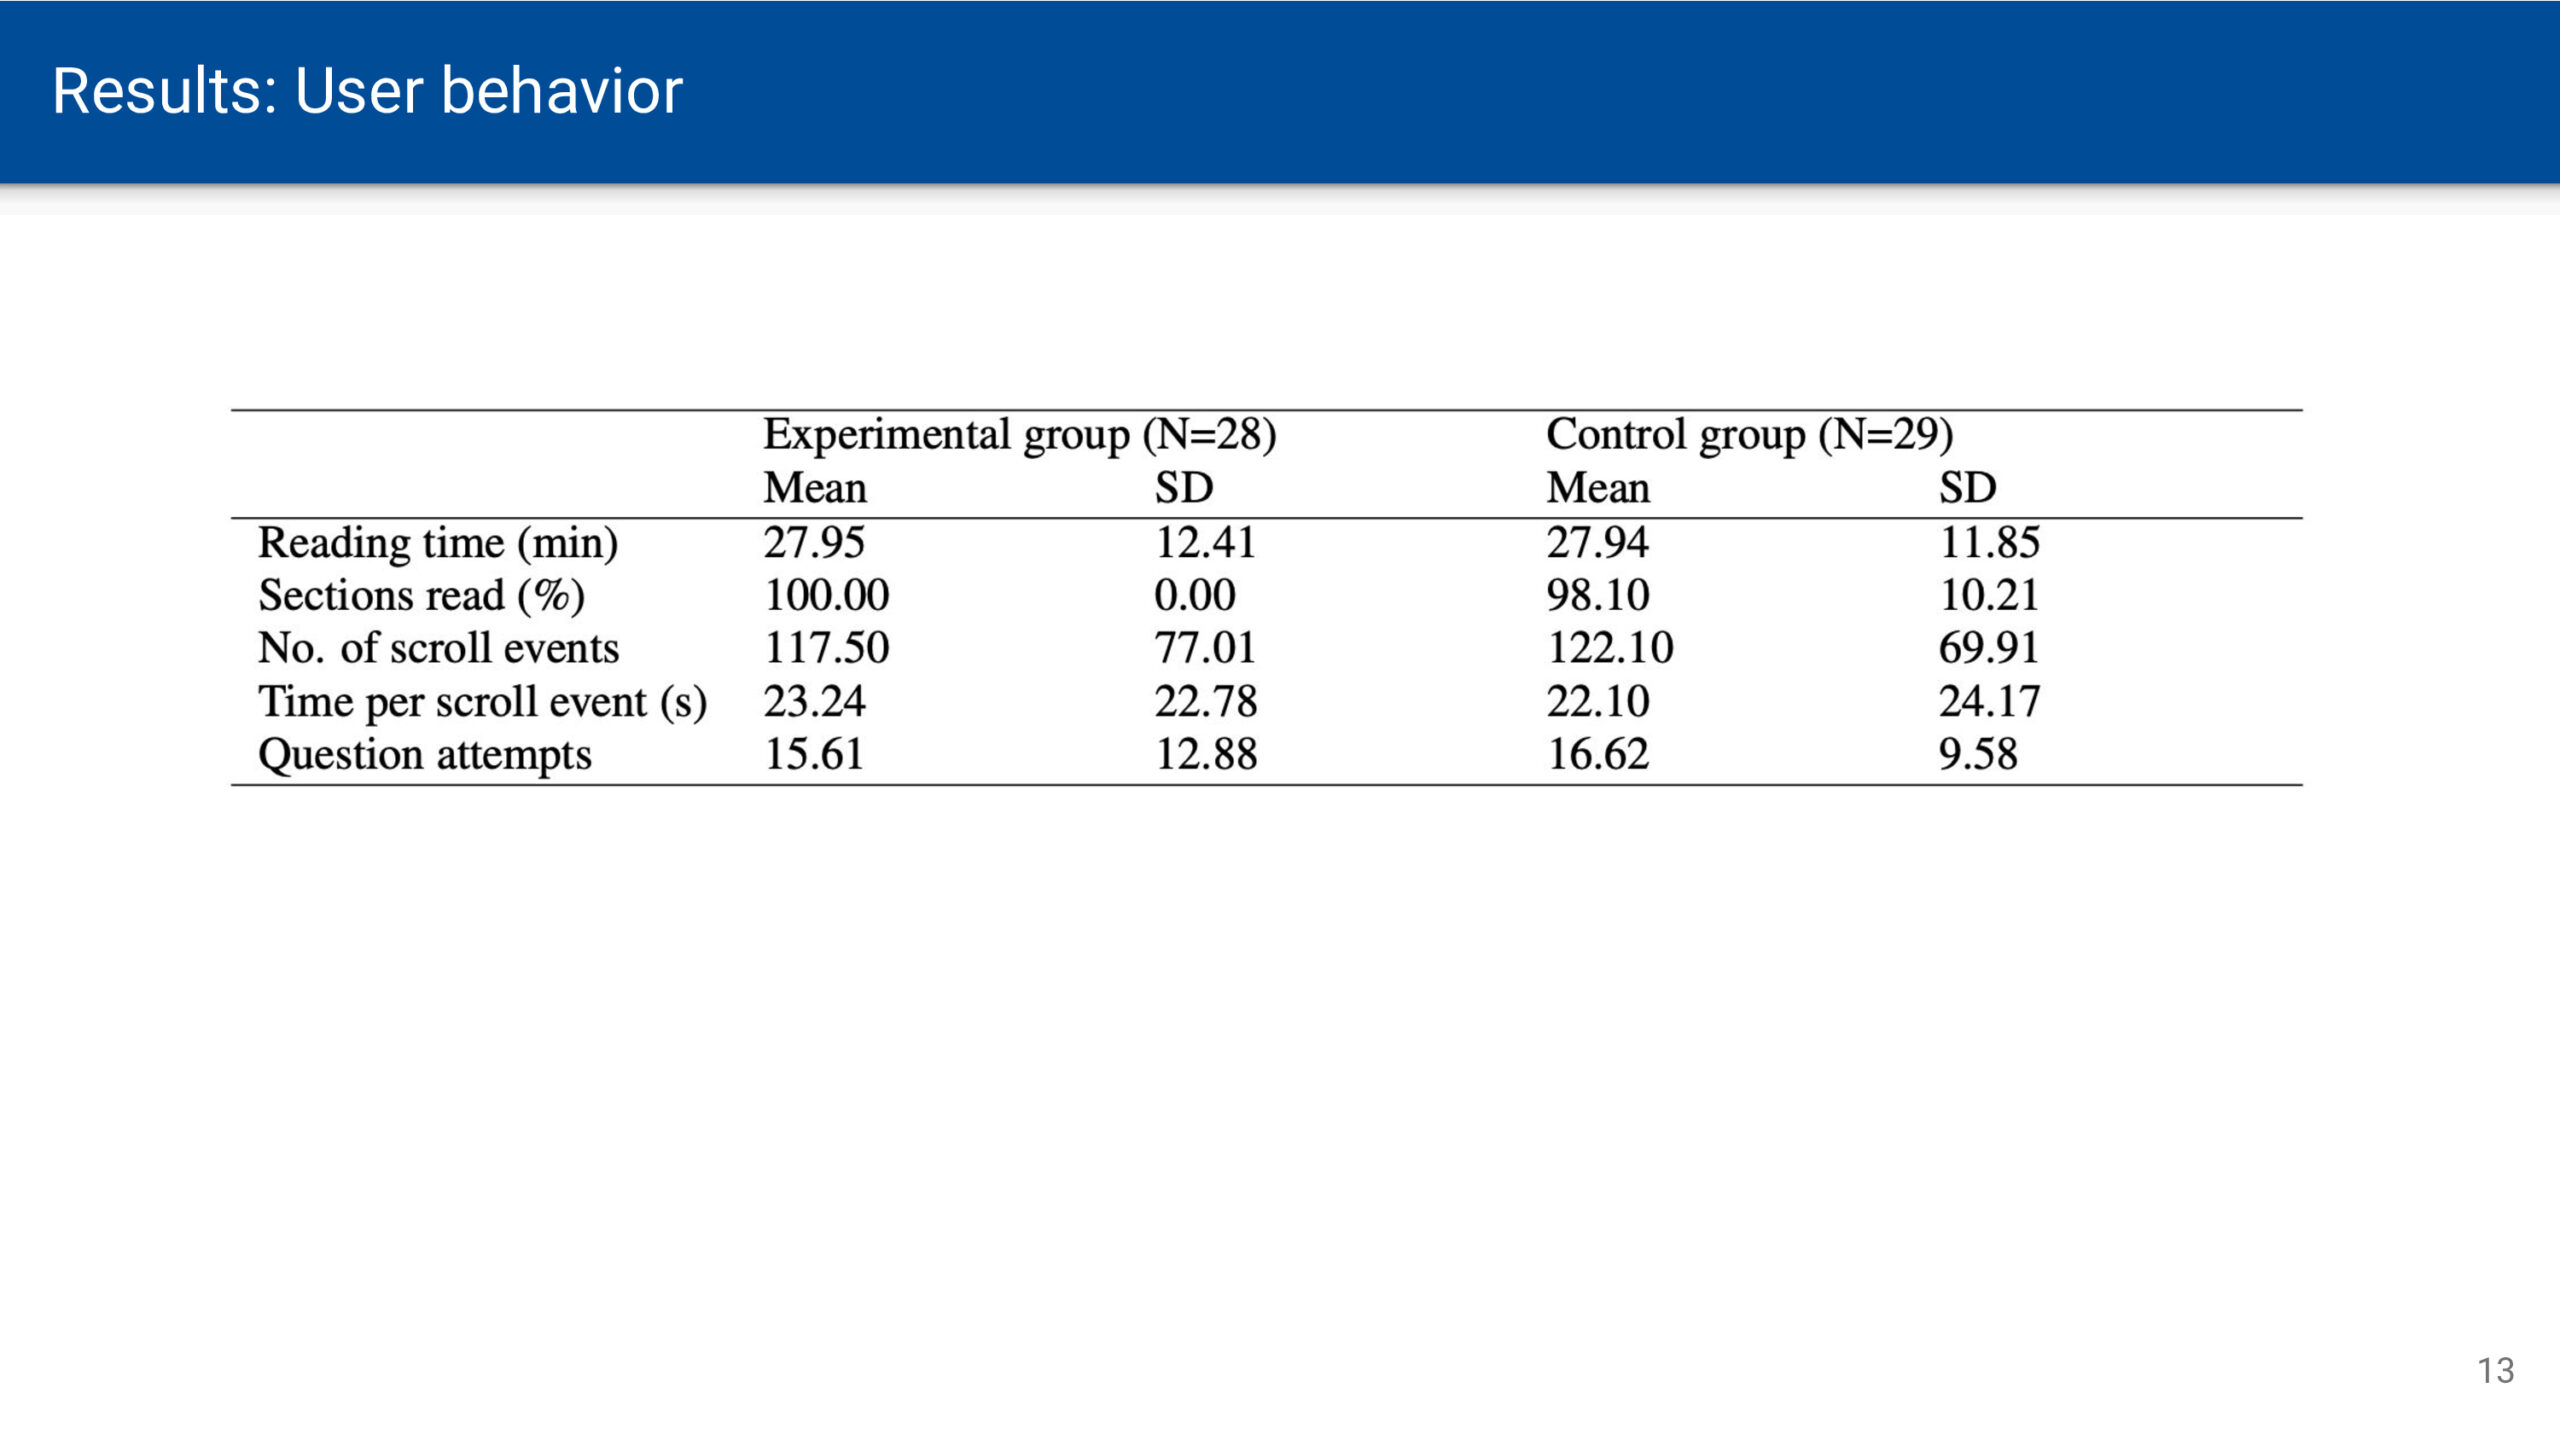
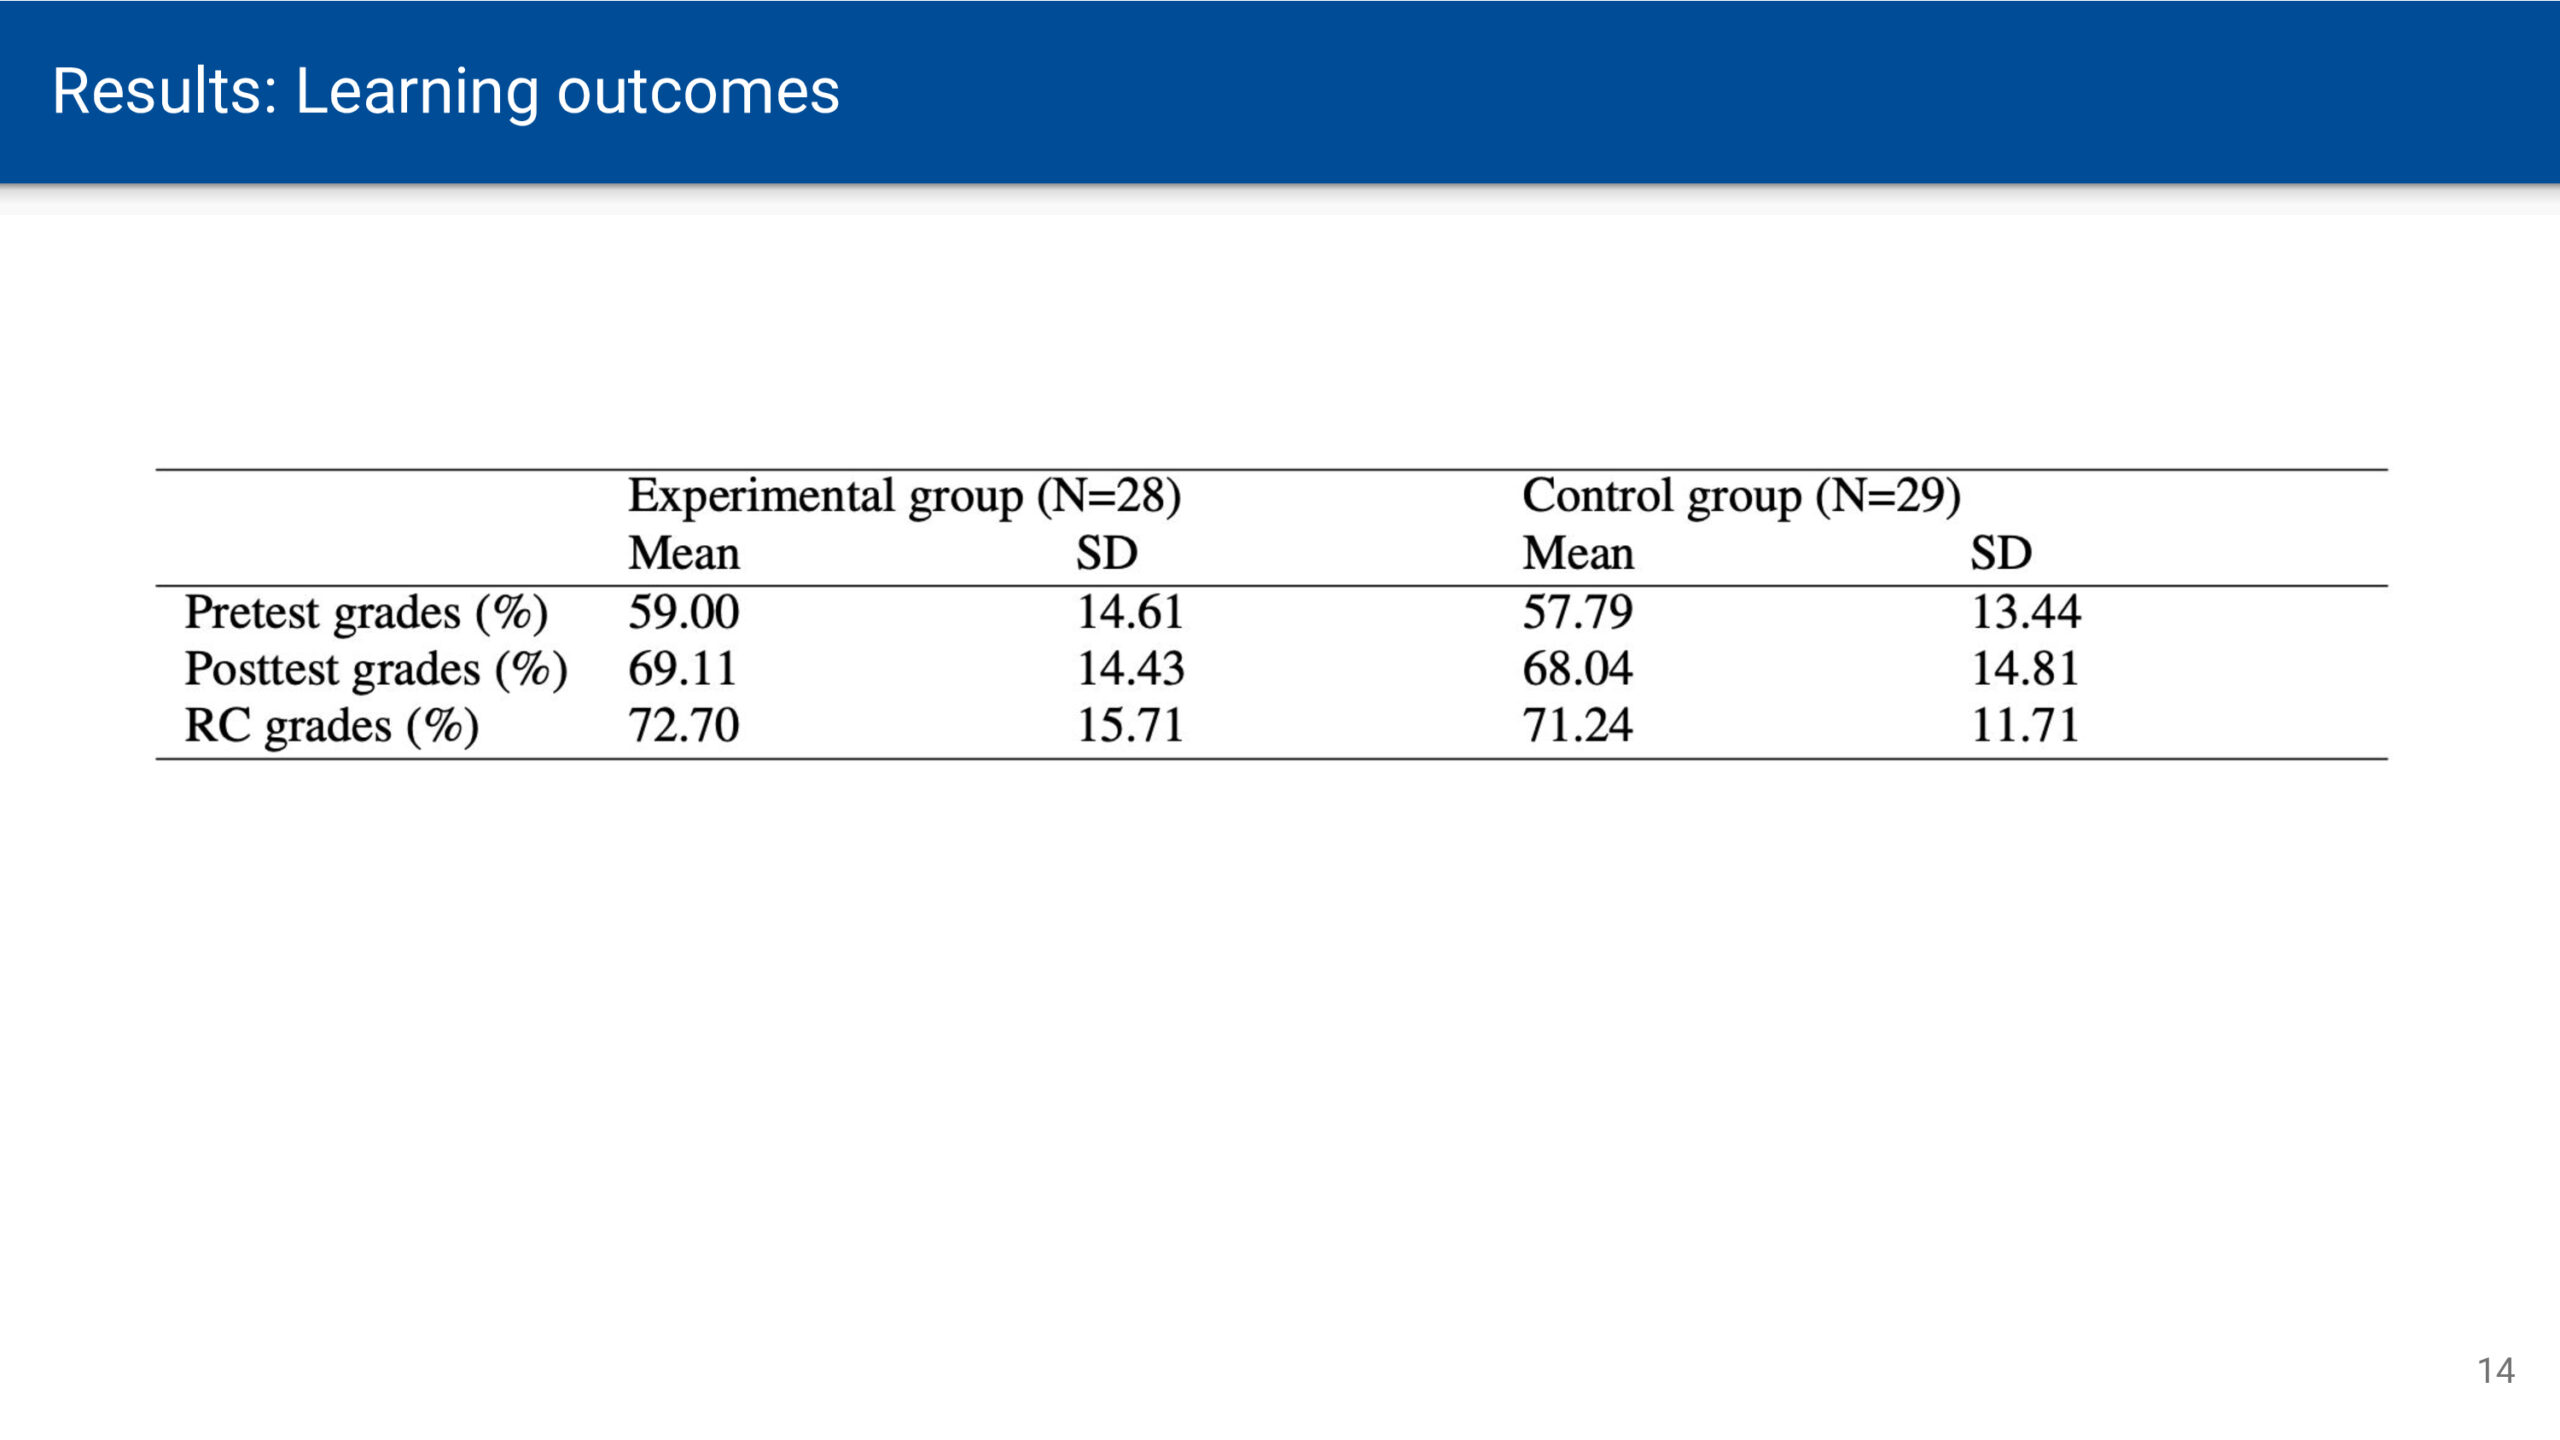
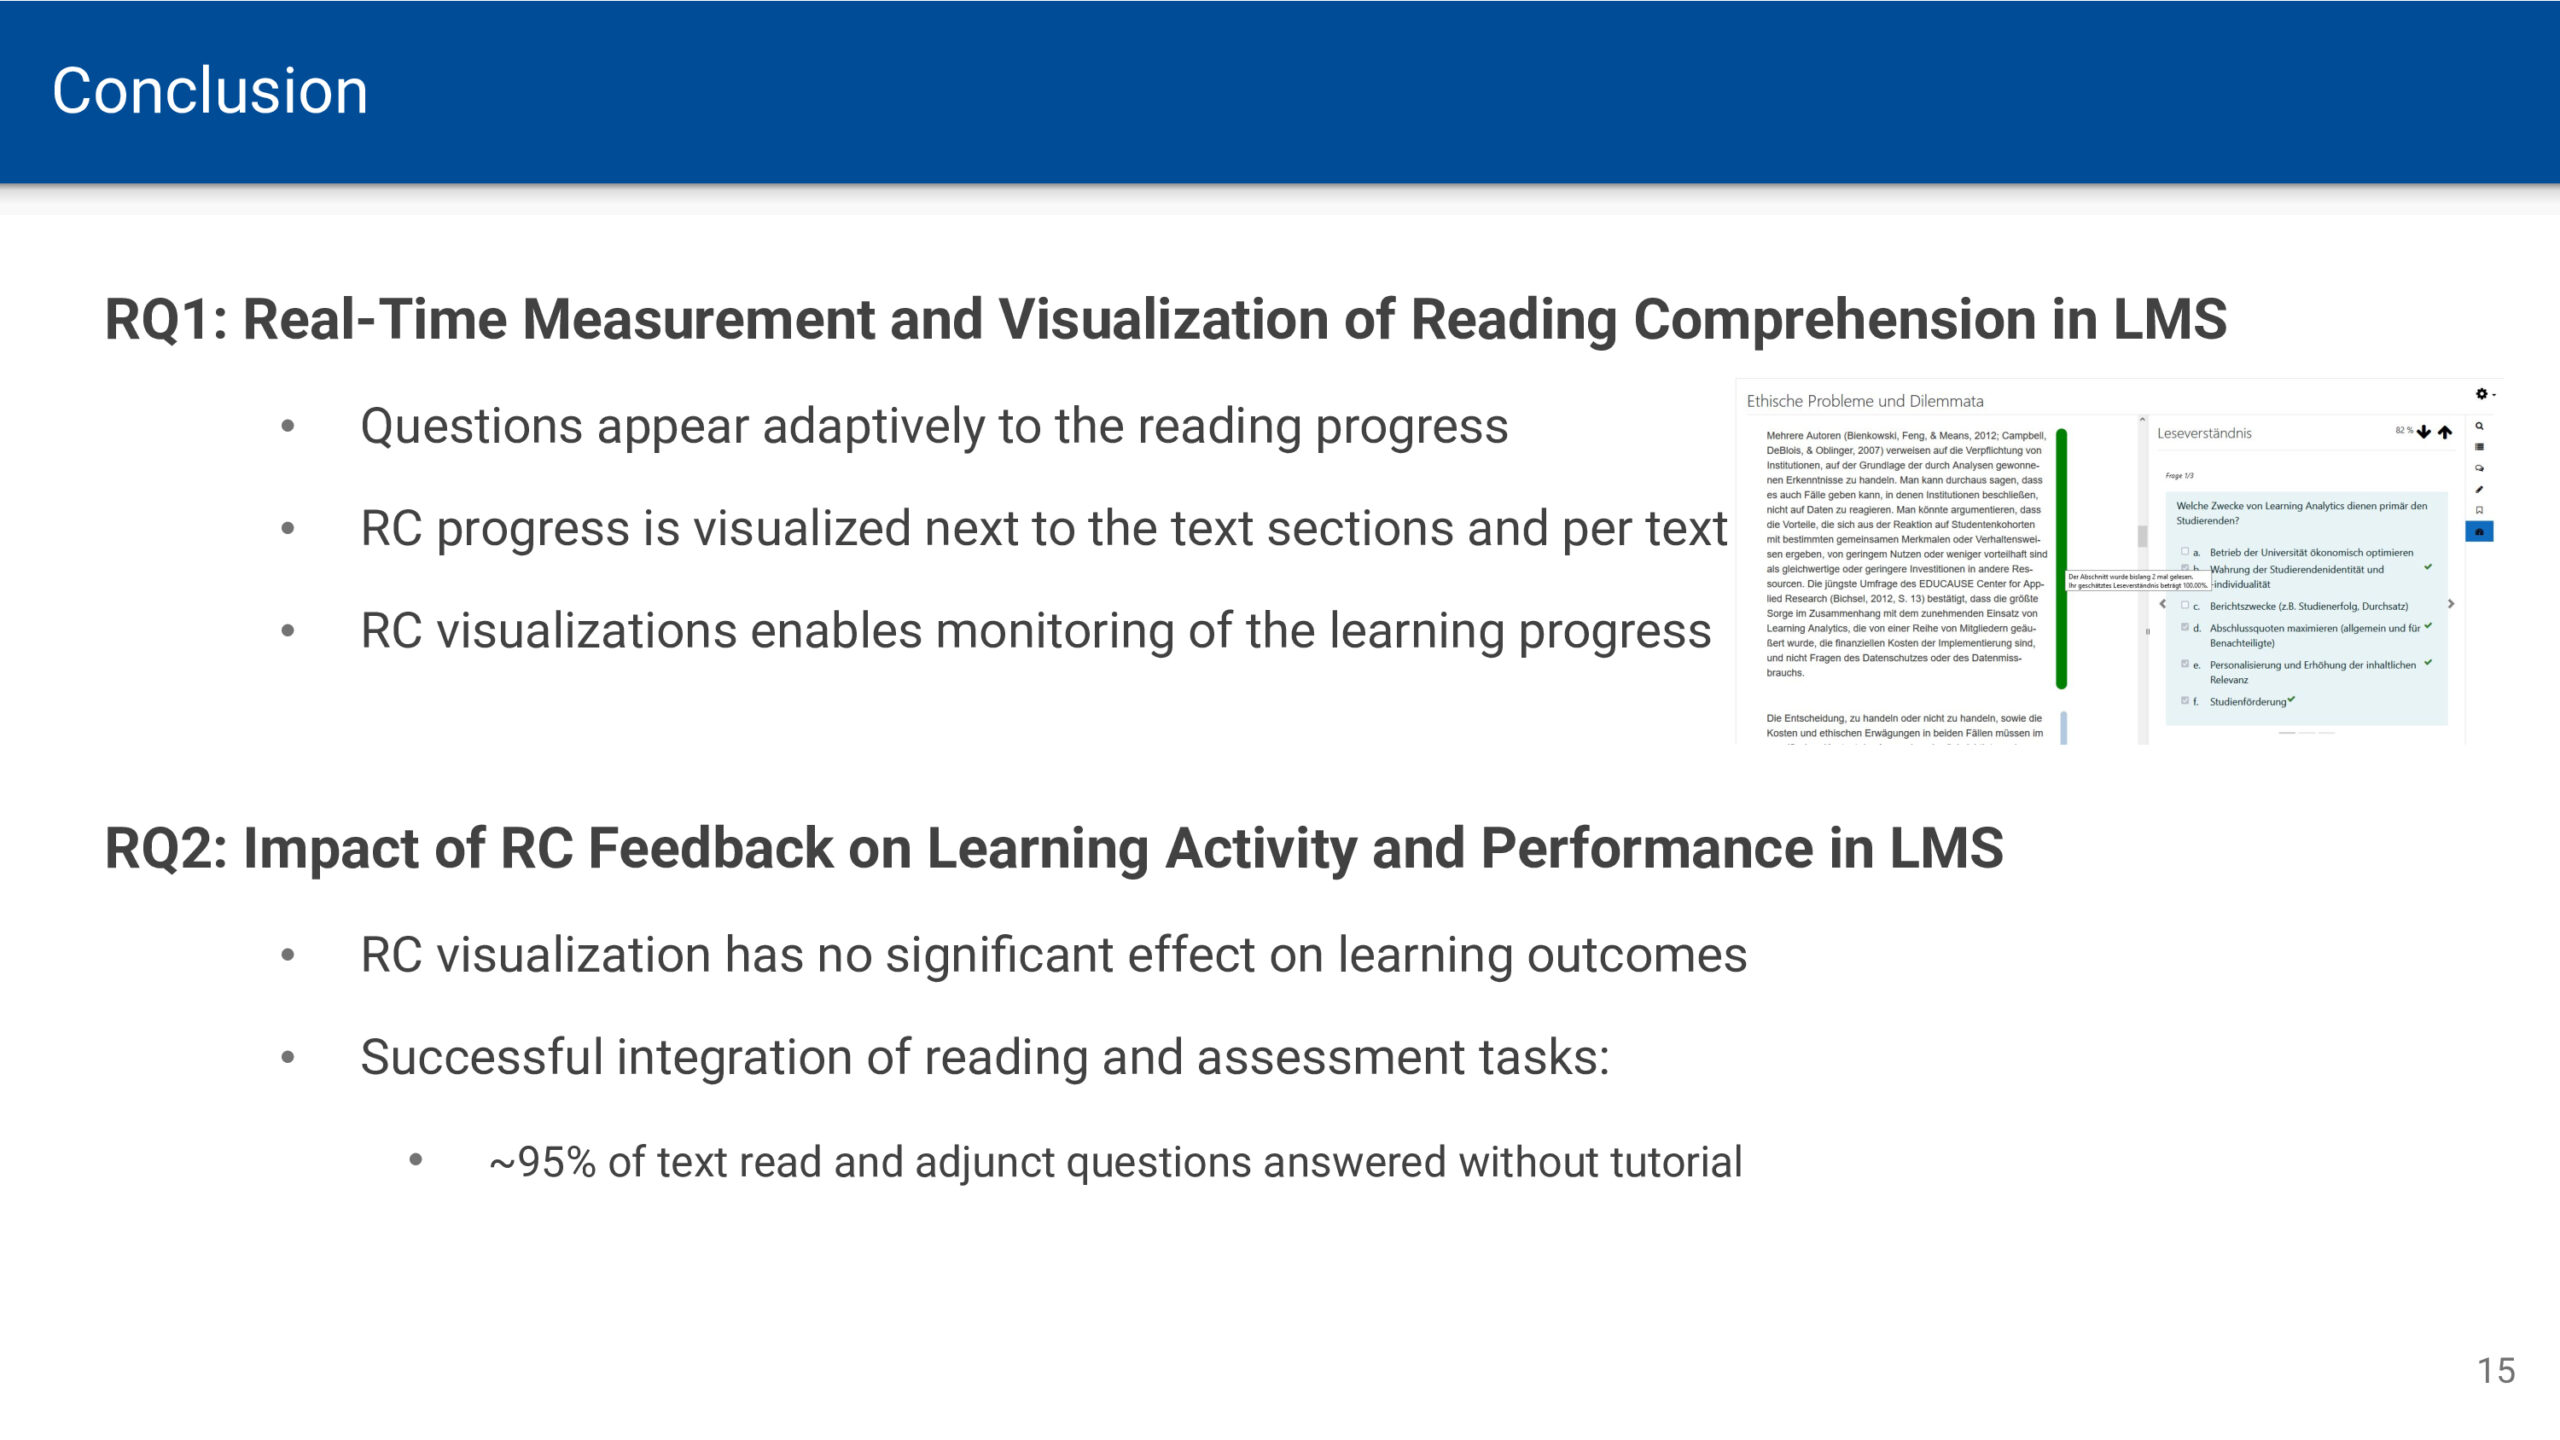
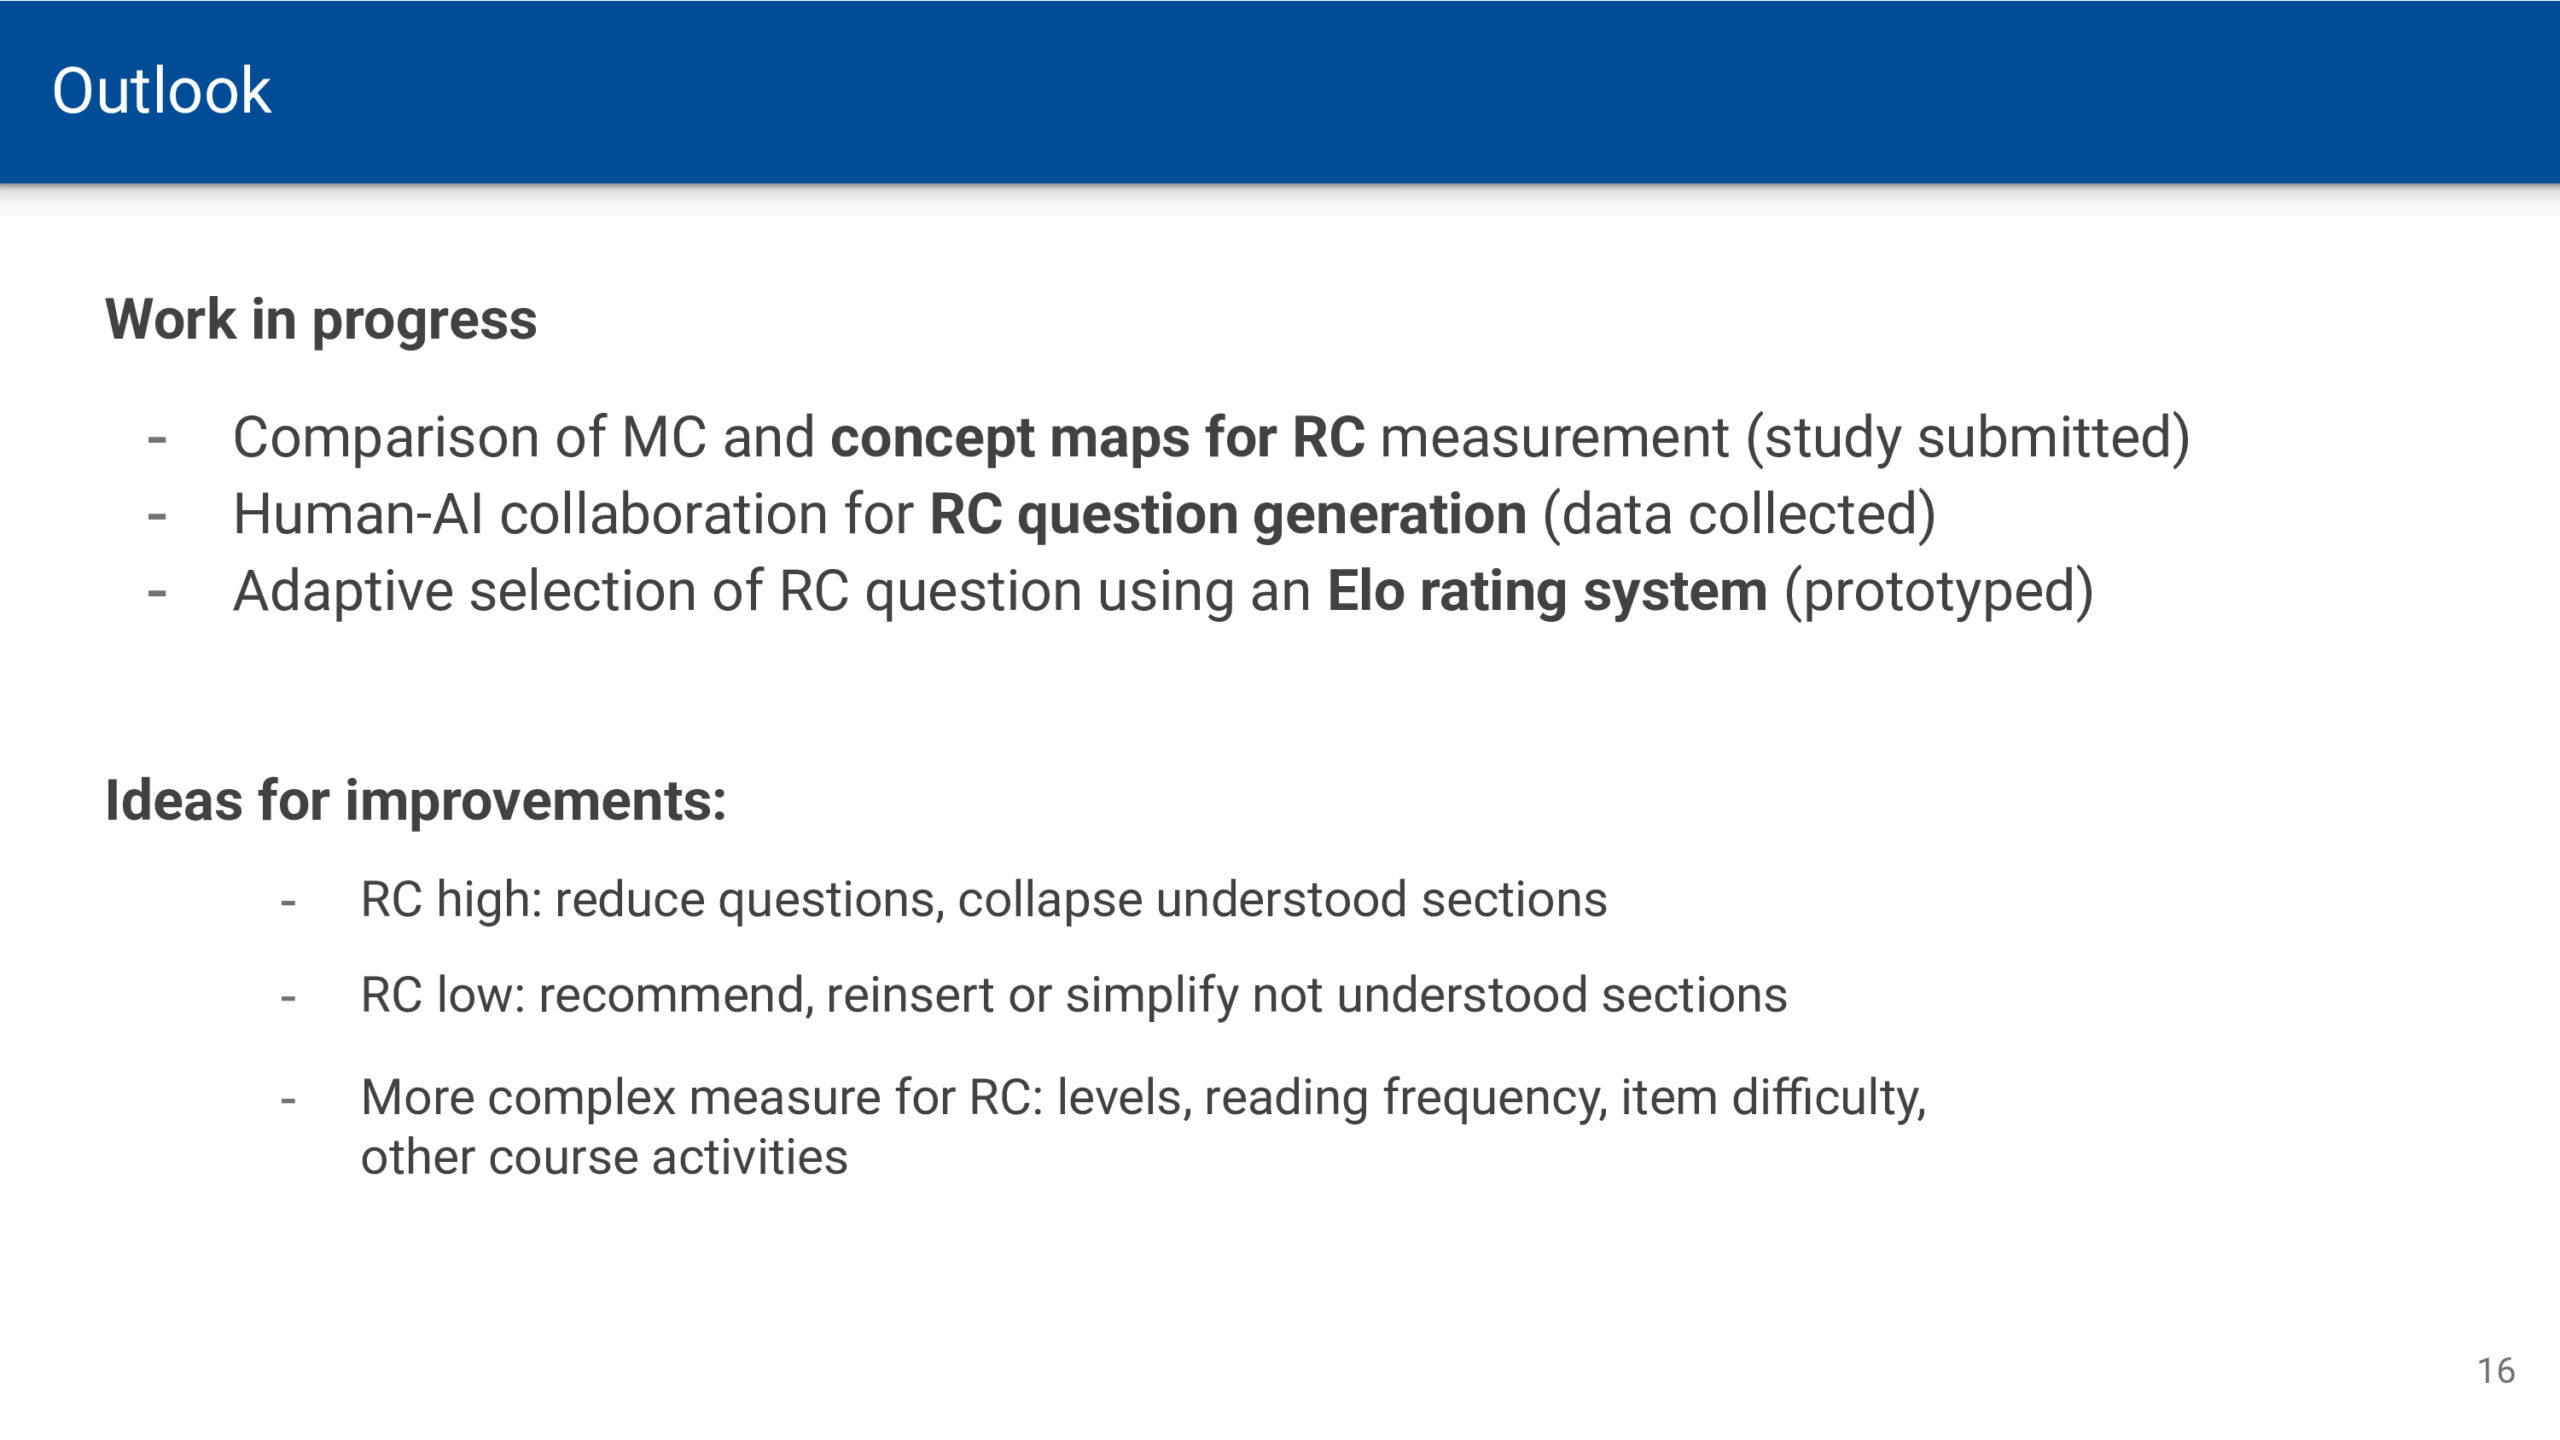
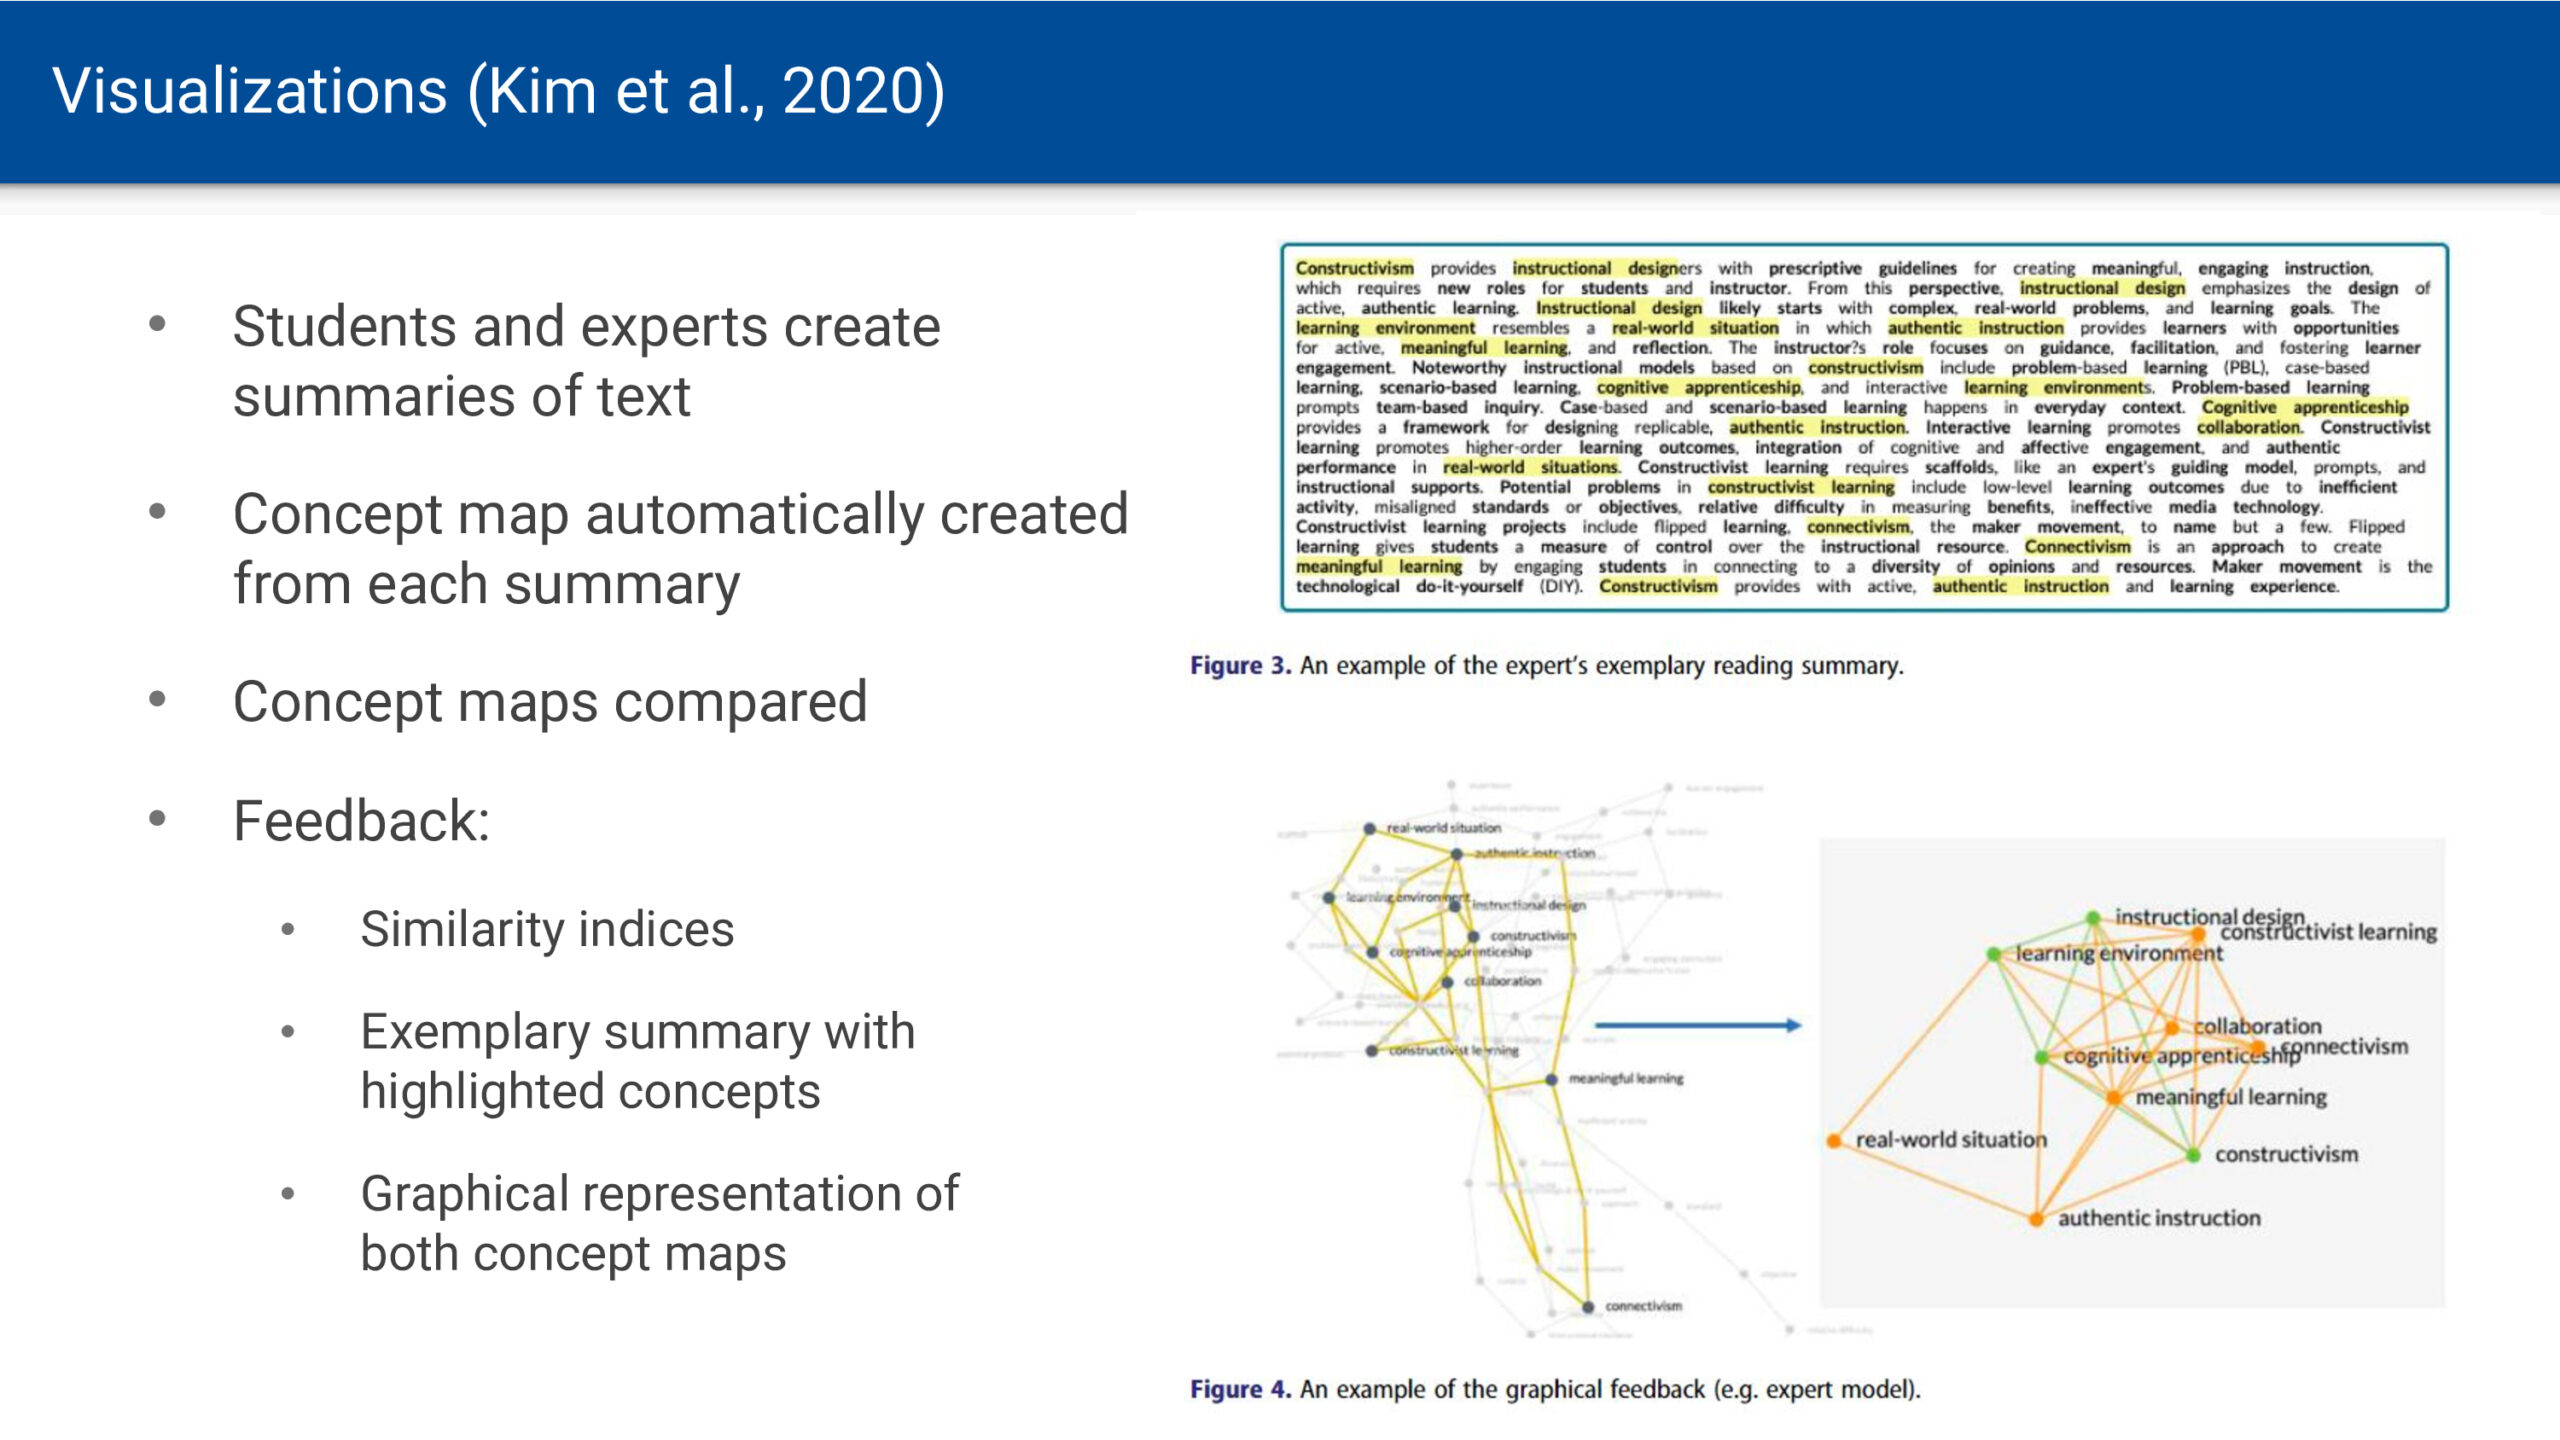
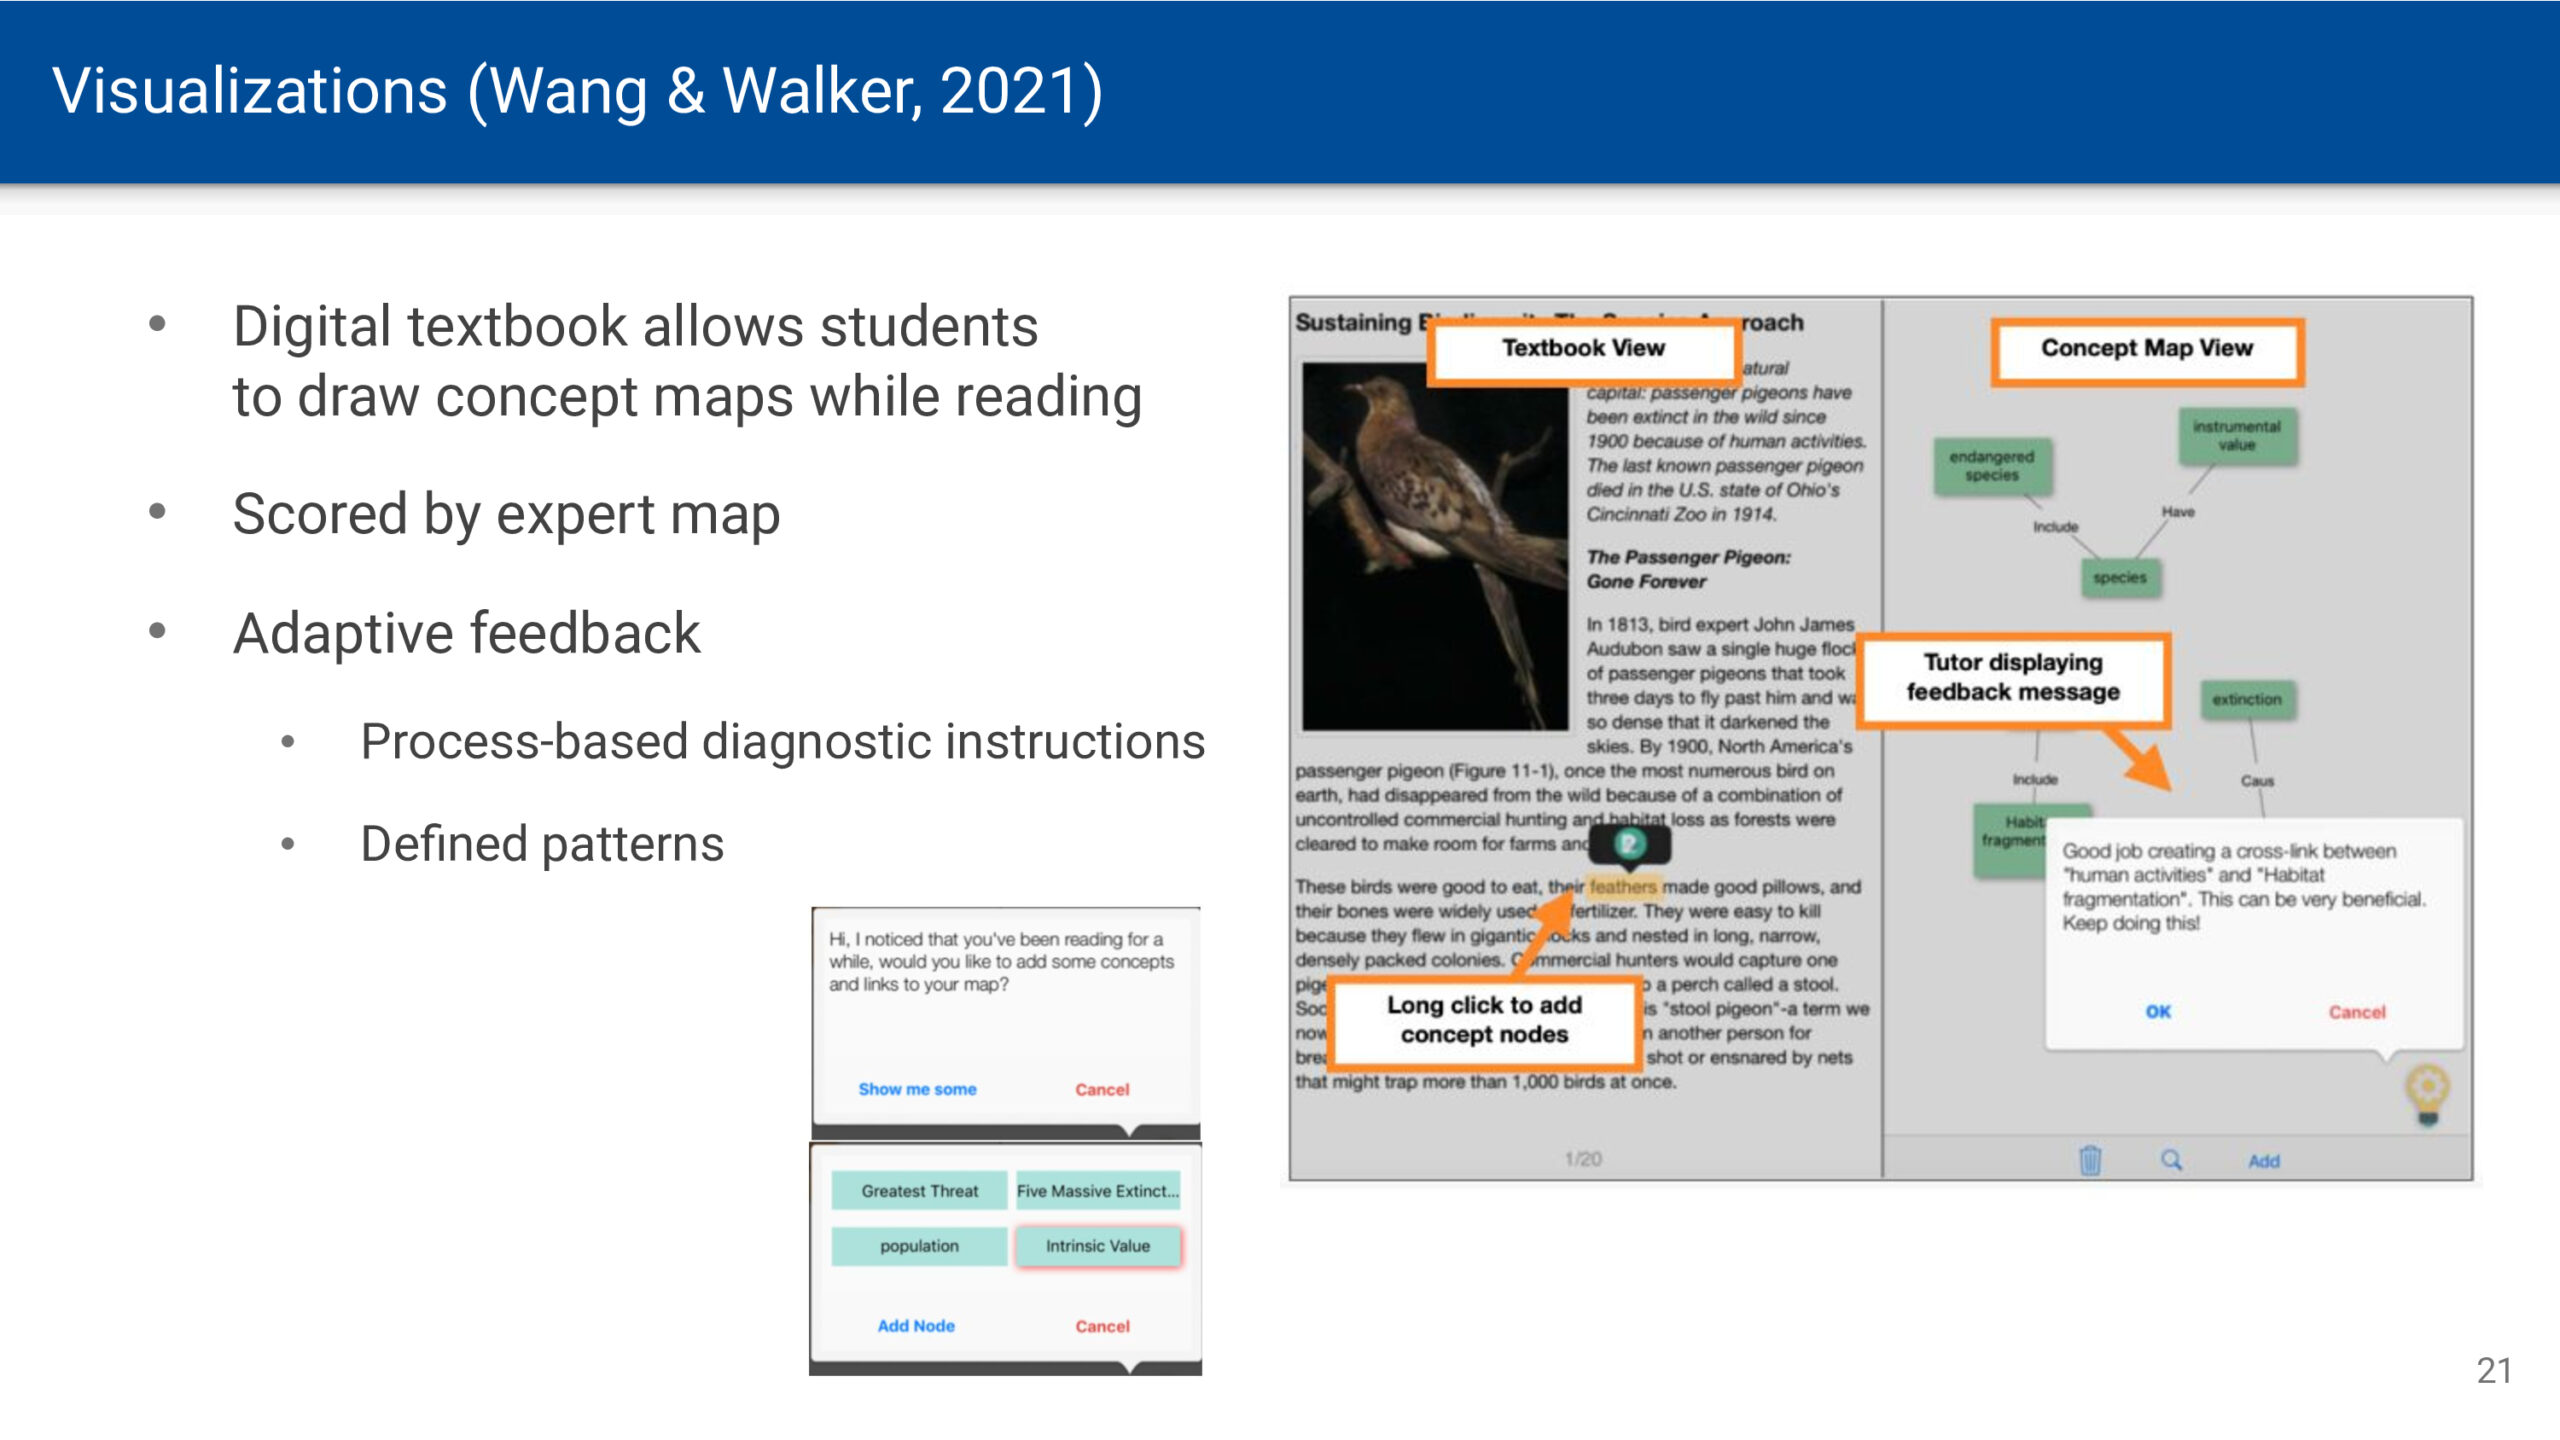
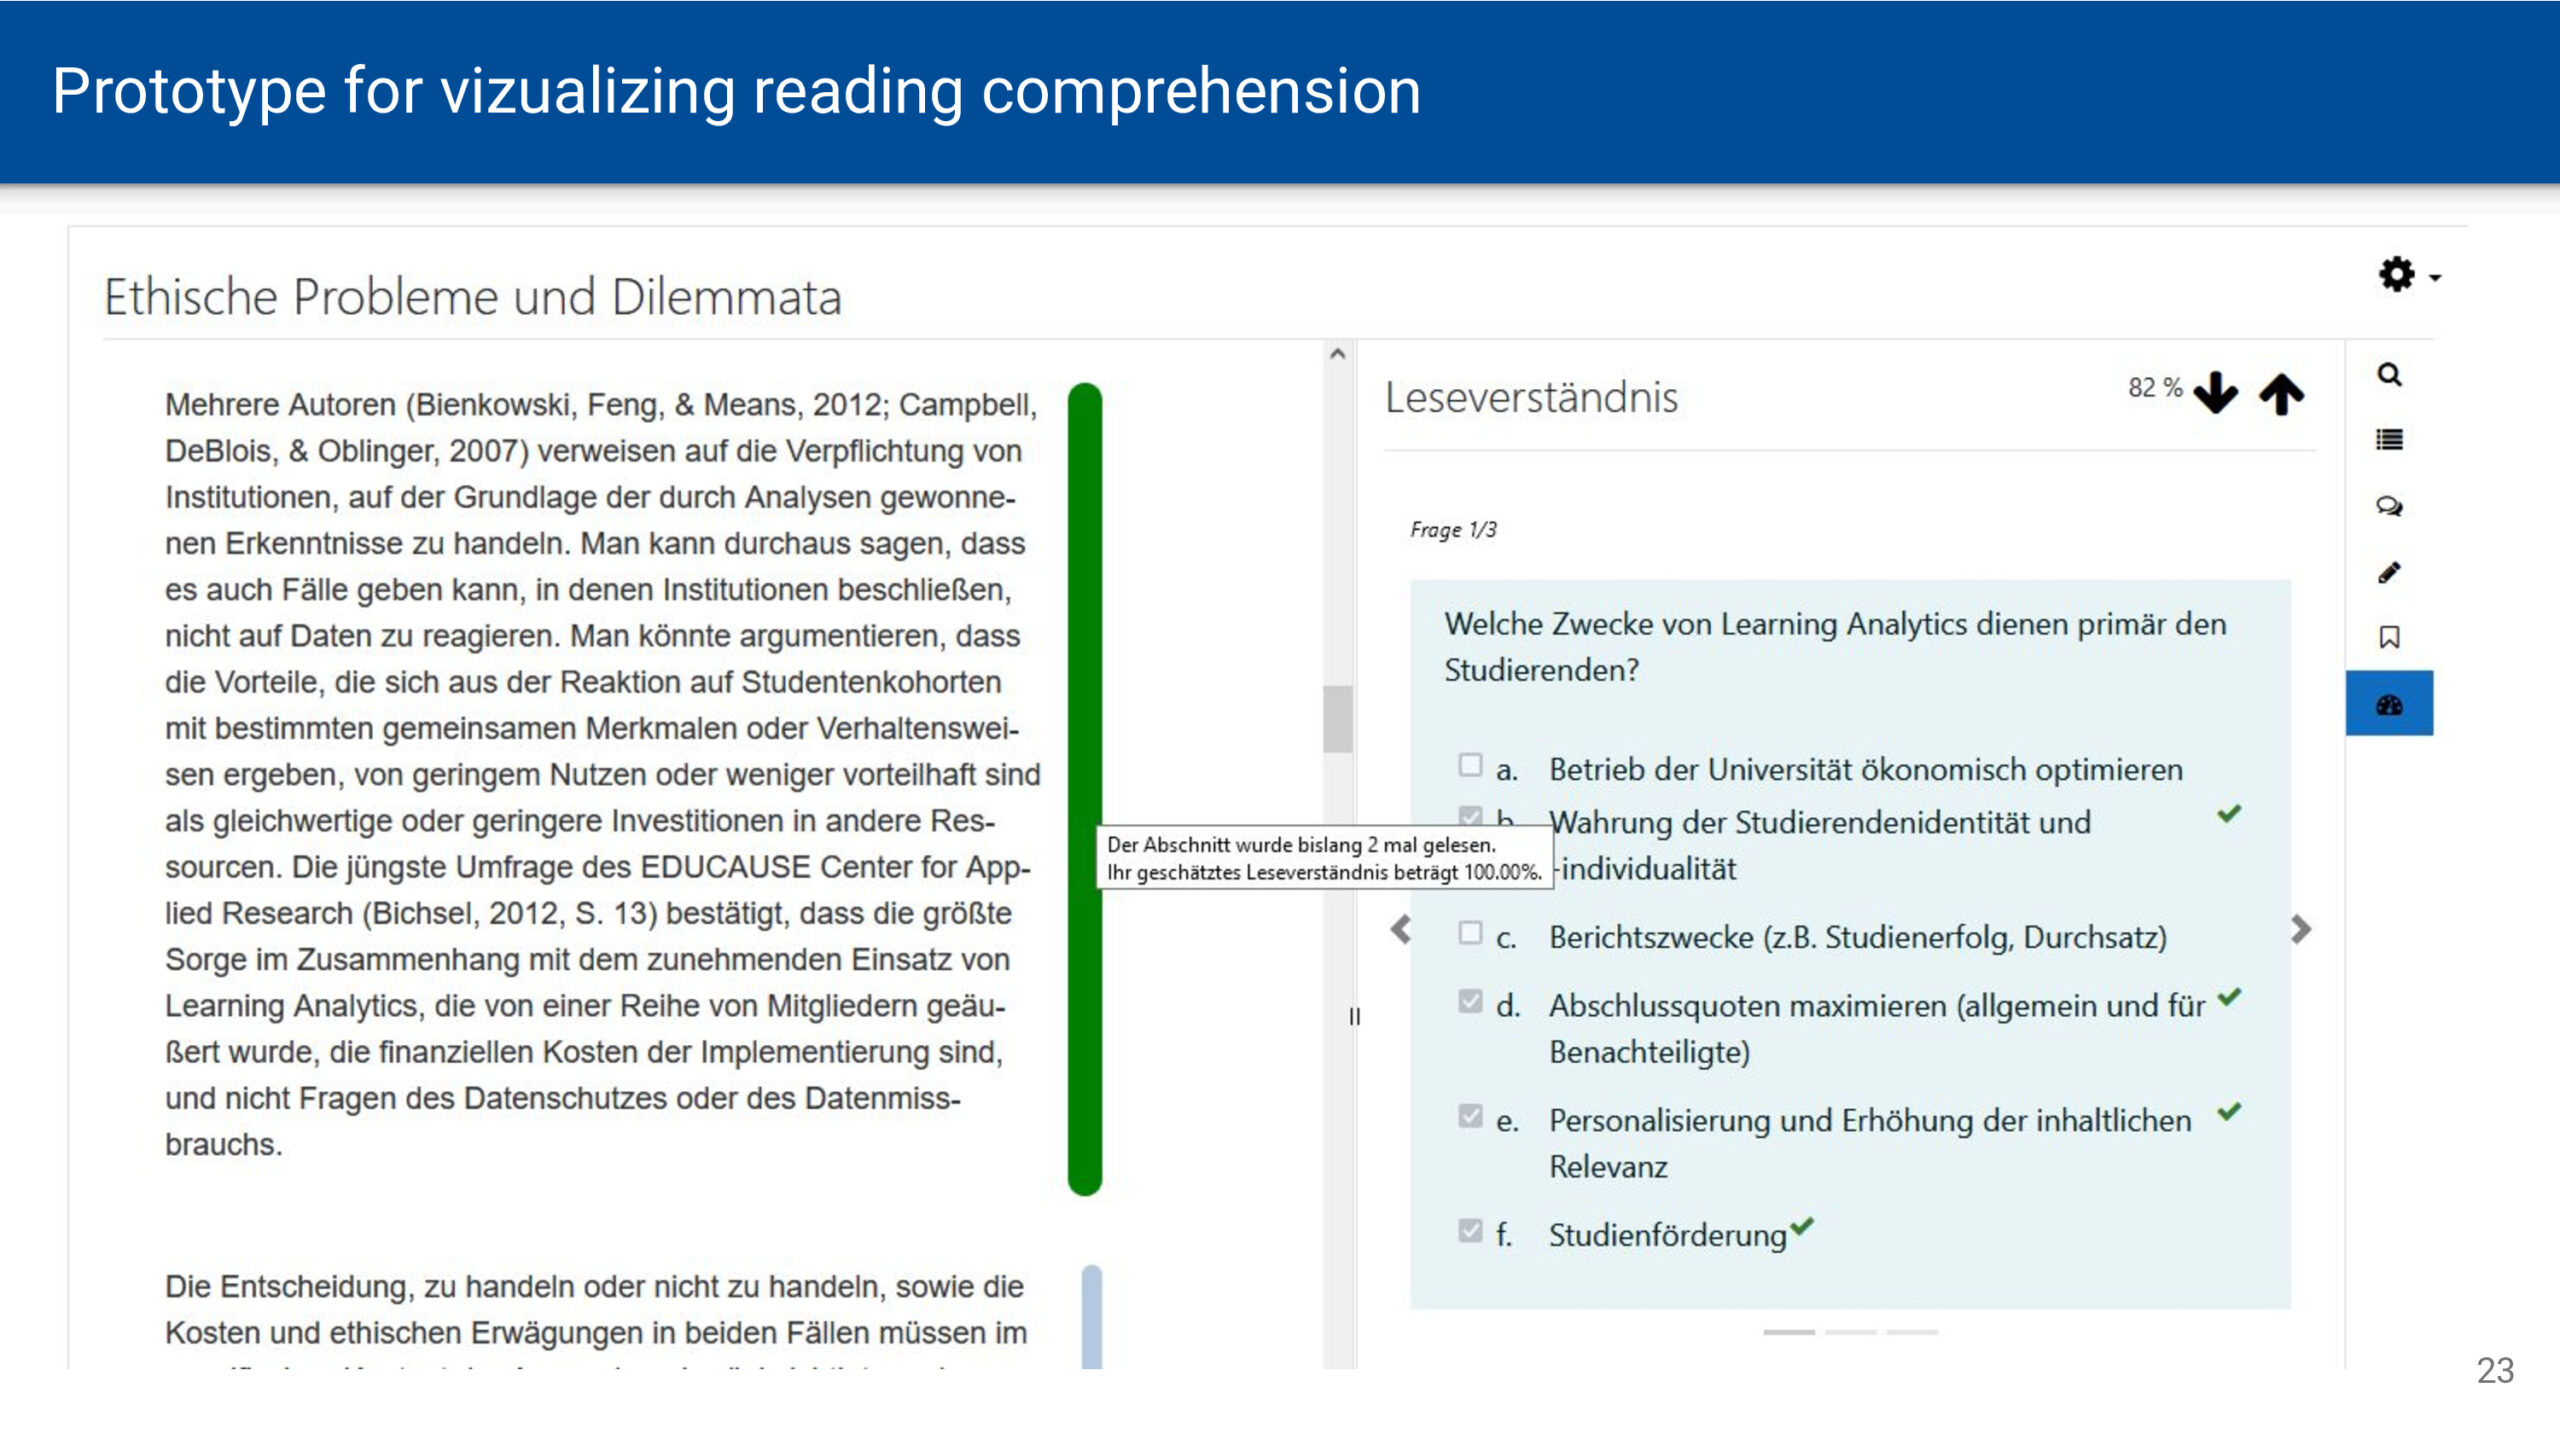
Talk 1: Dynamic Reading Comprehension Visualization in Digital Course Texts (Dennis Menz, Niels Seidel, Slavisa Radovic)

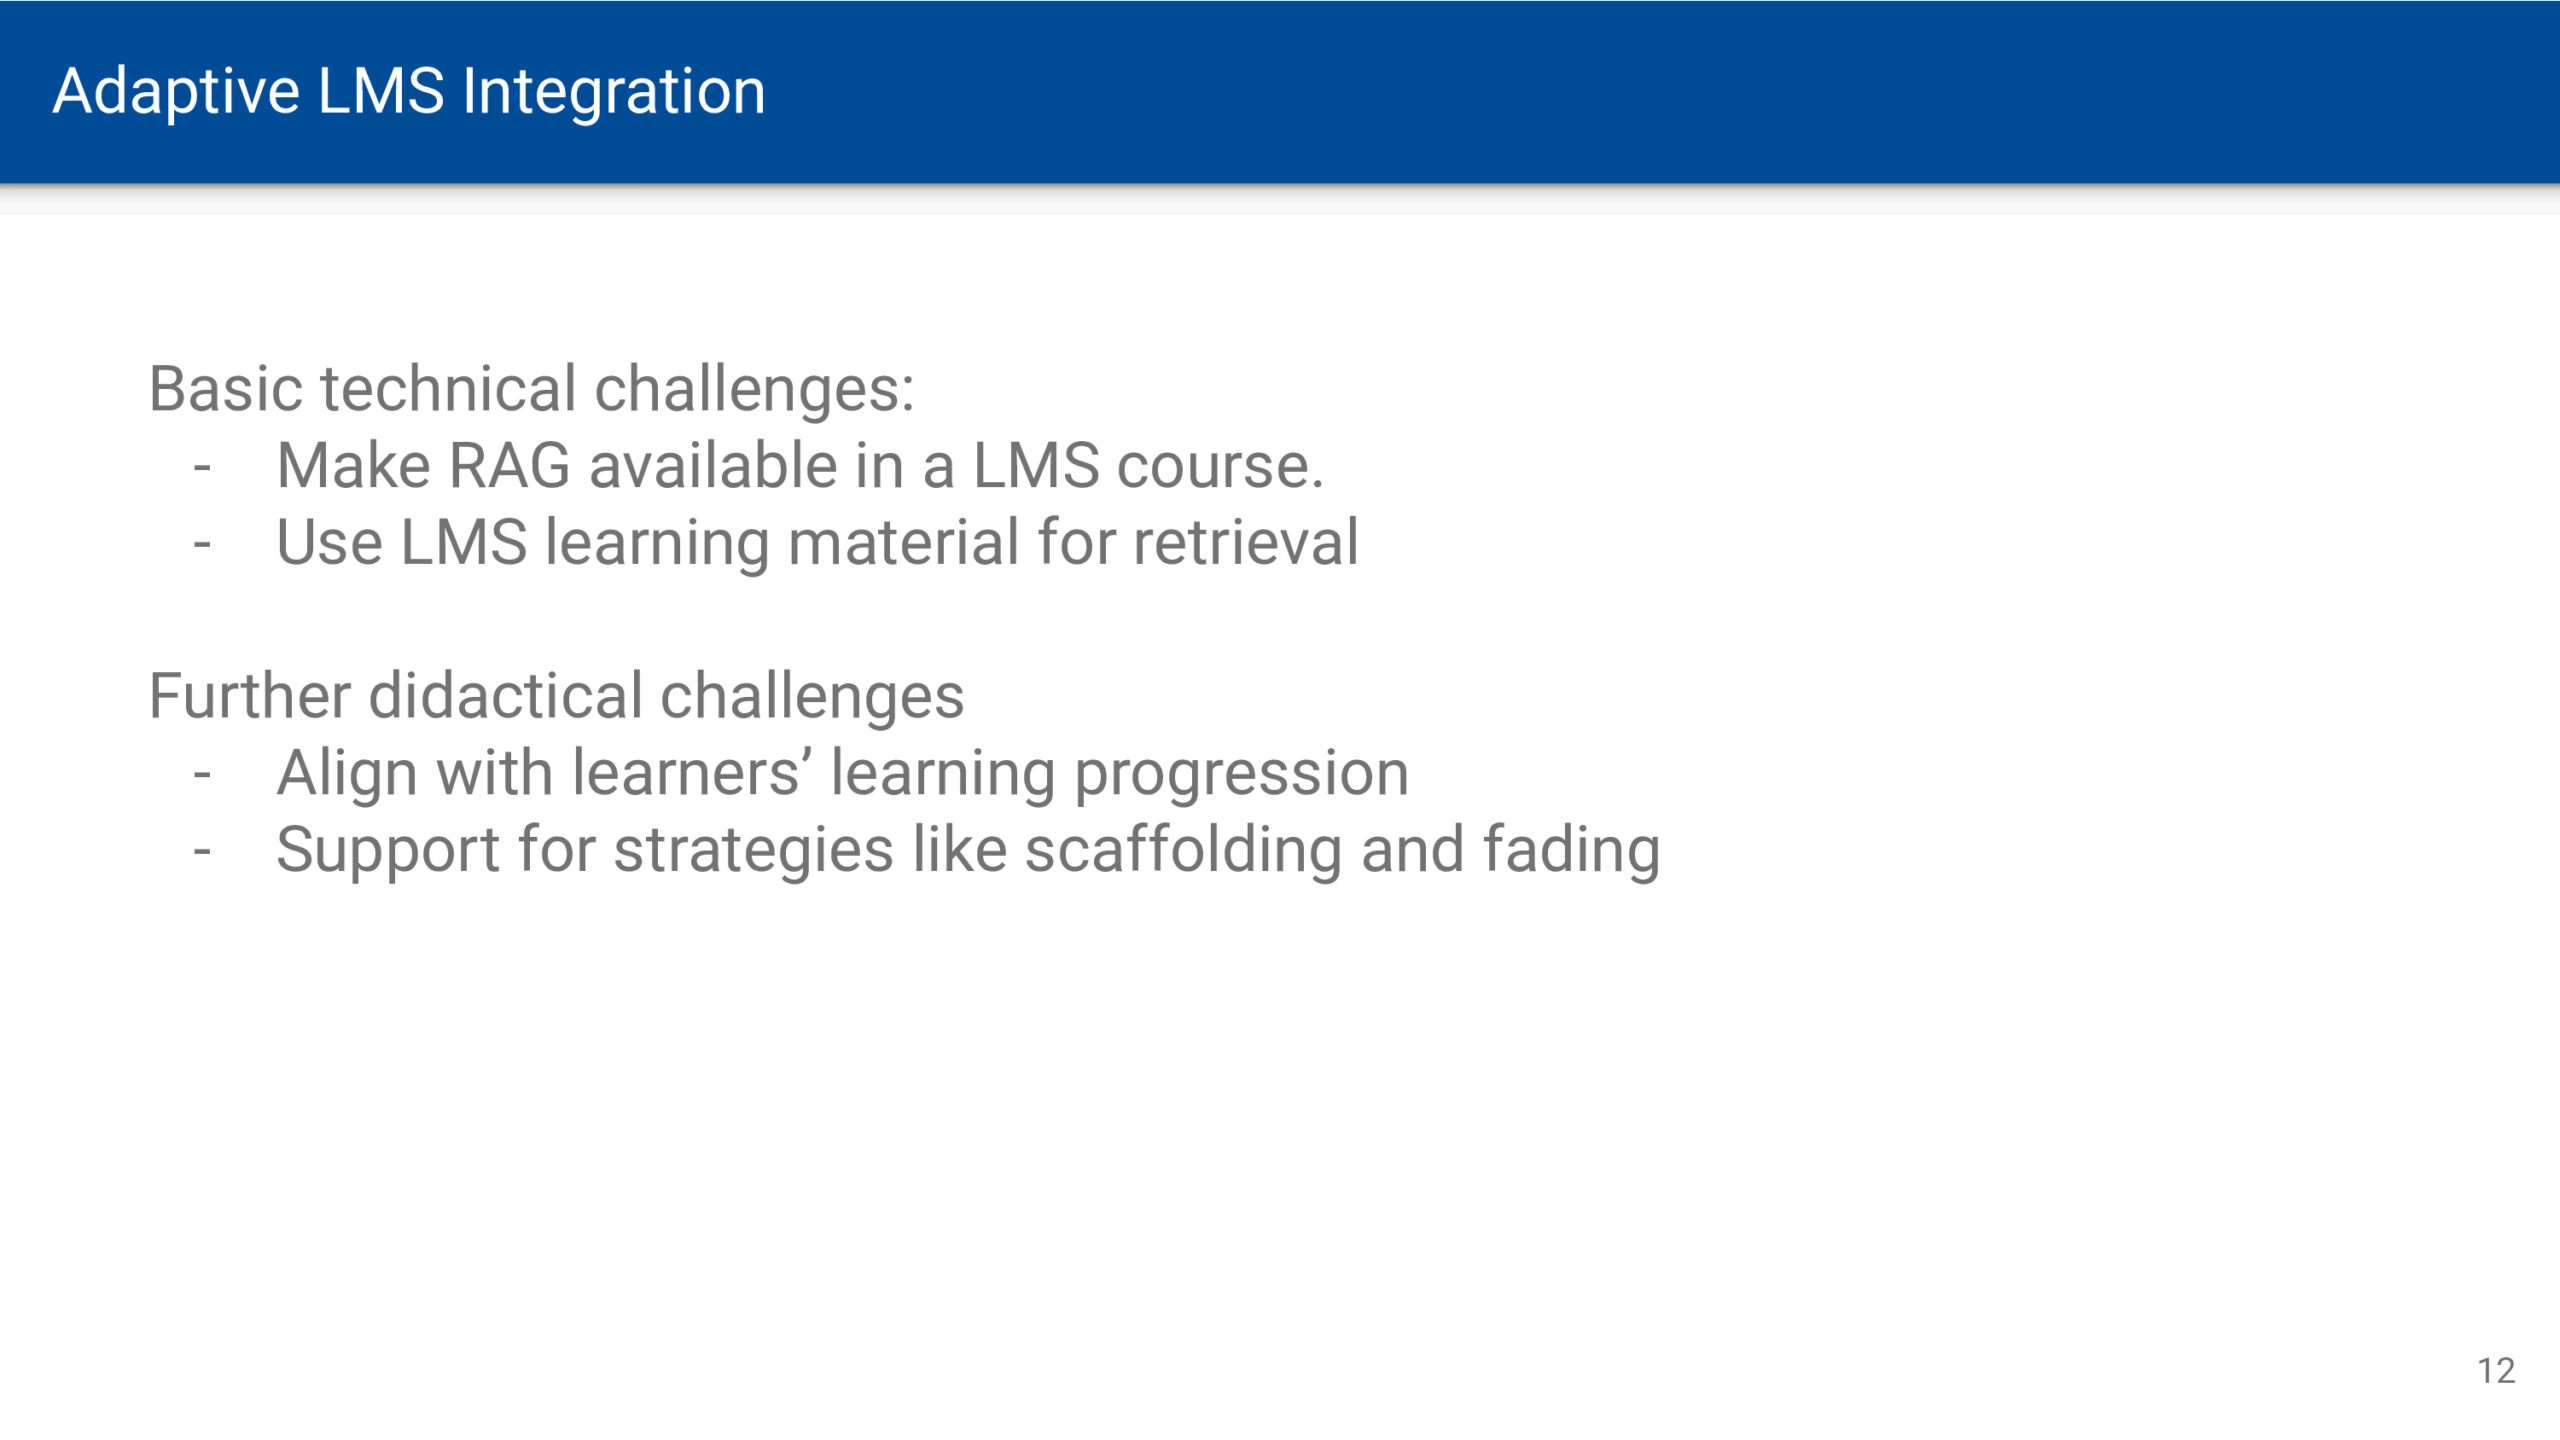
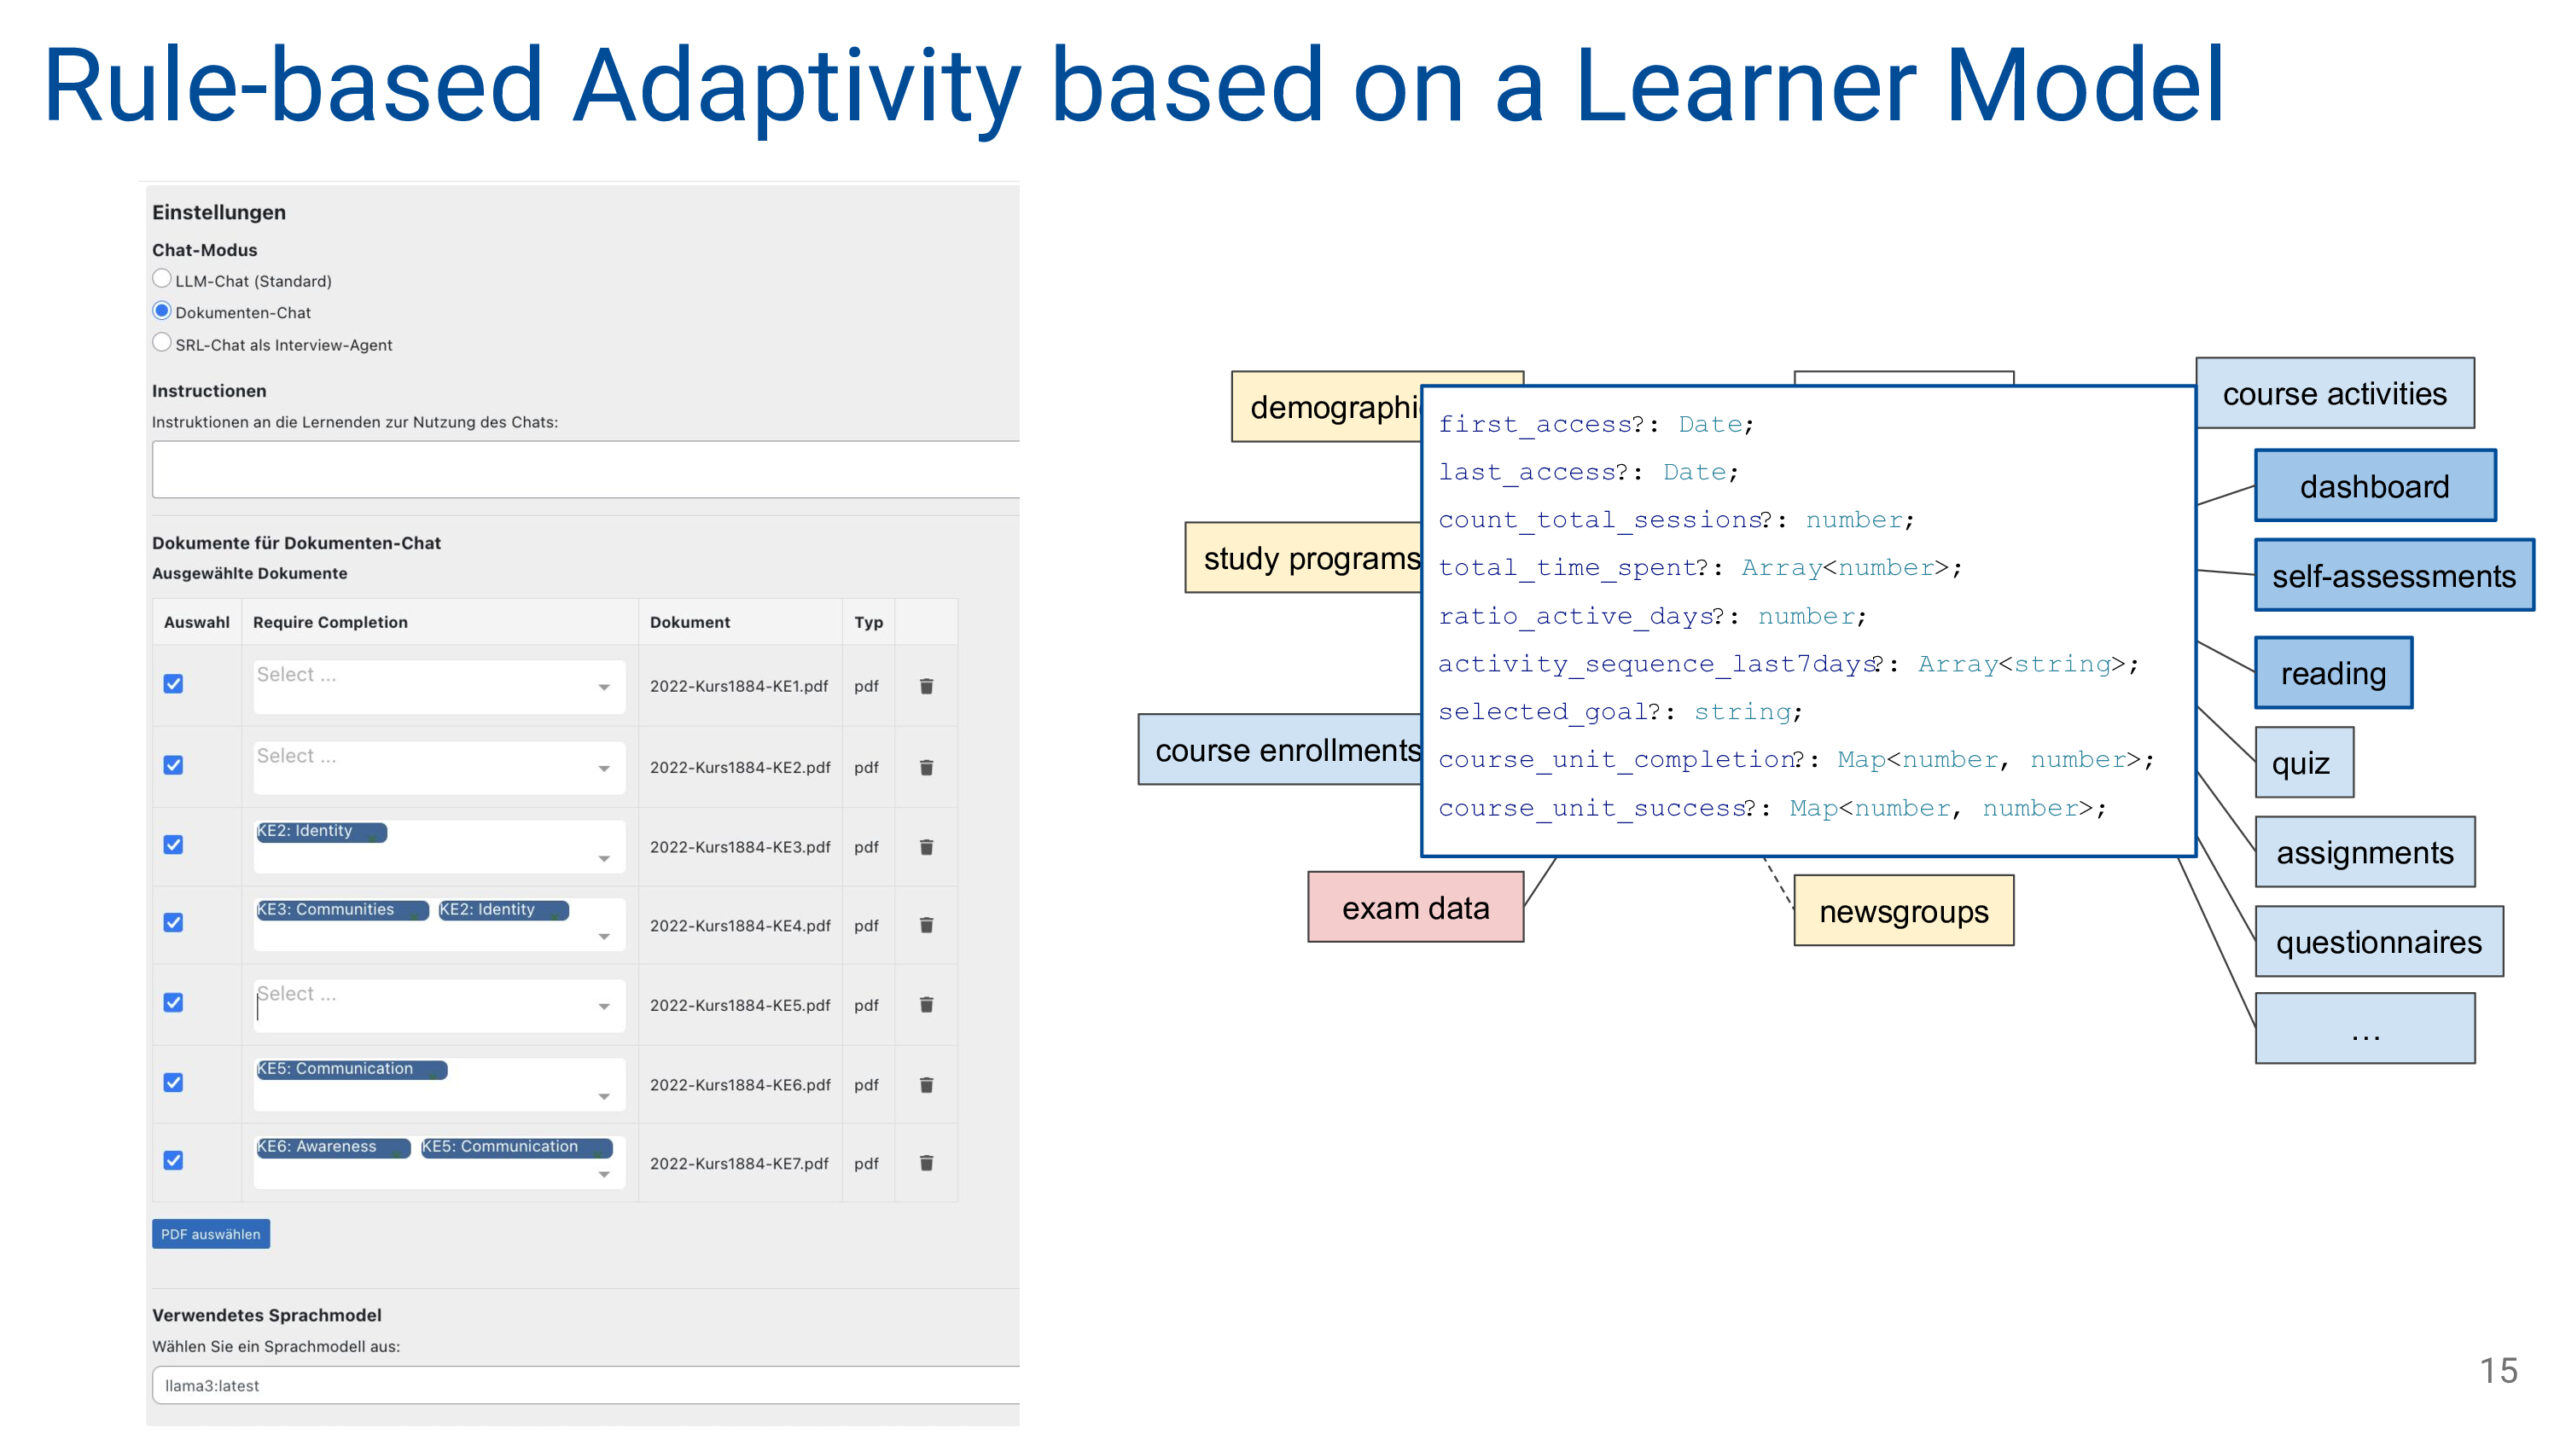
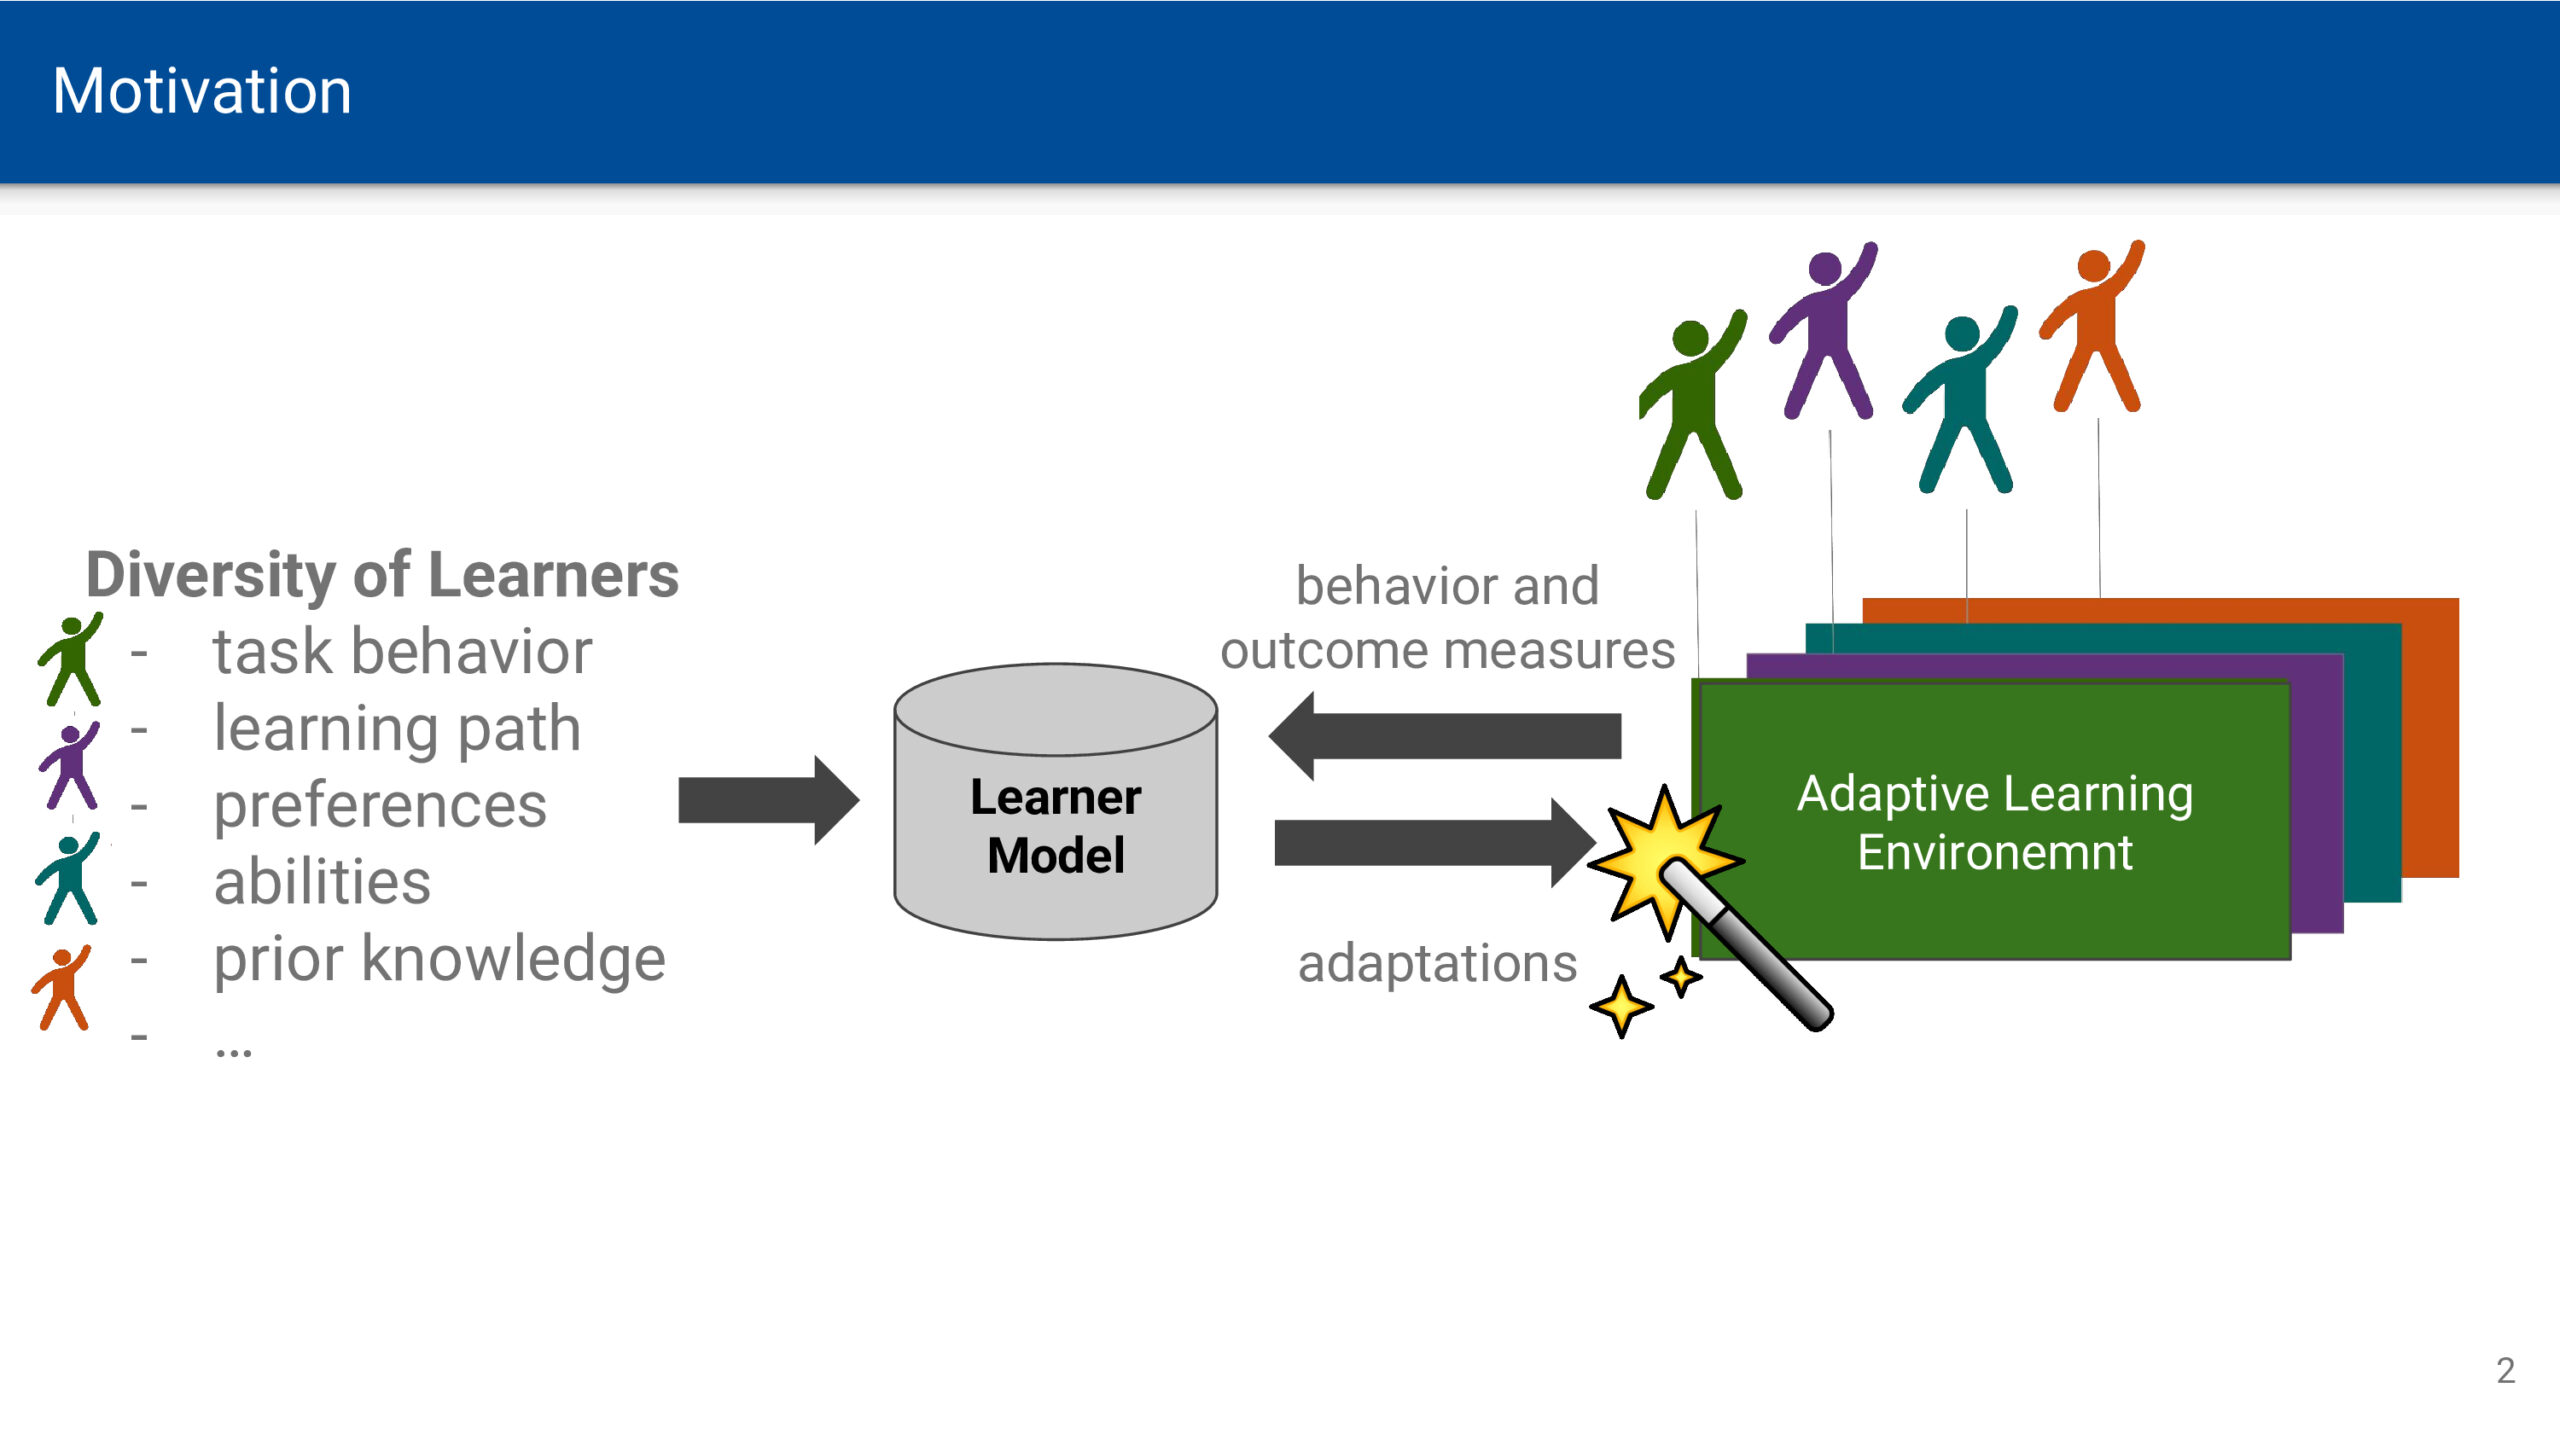
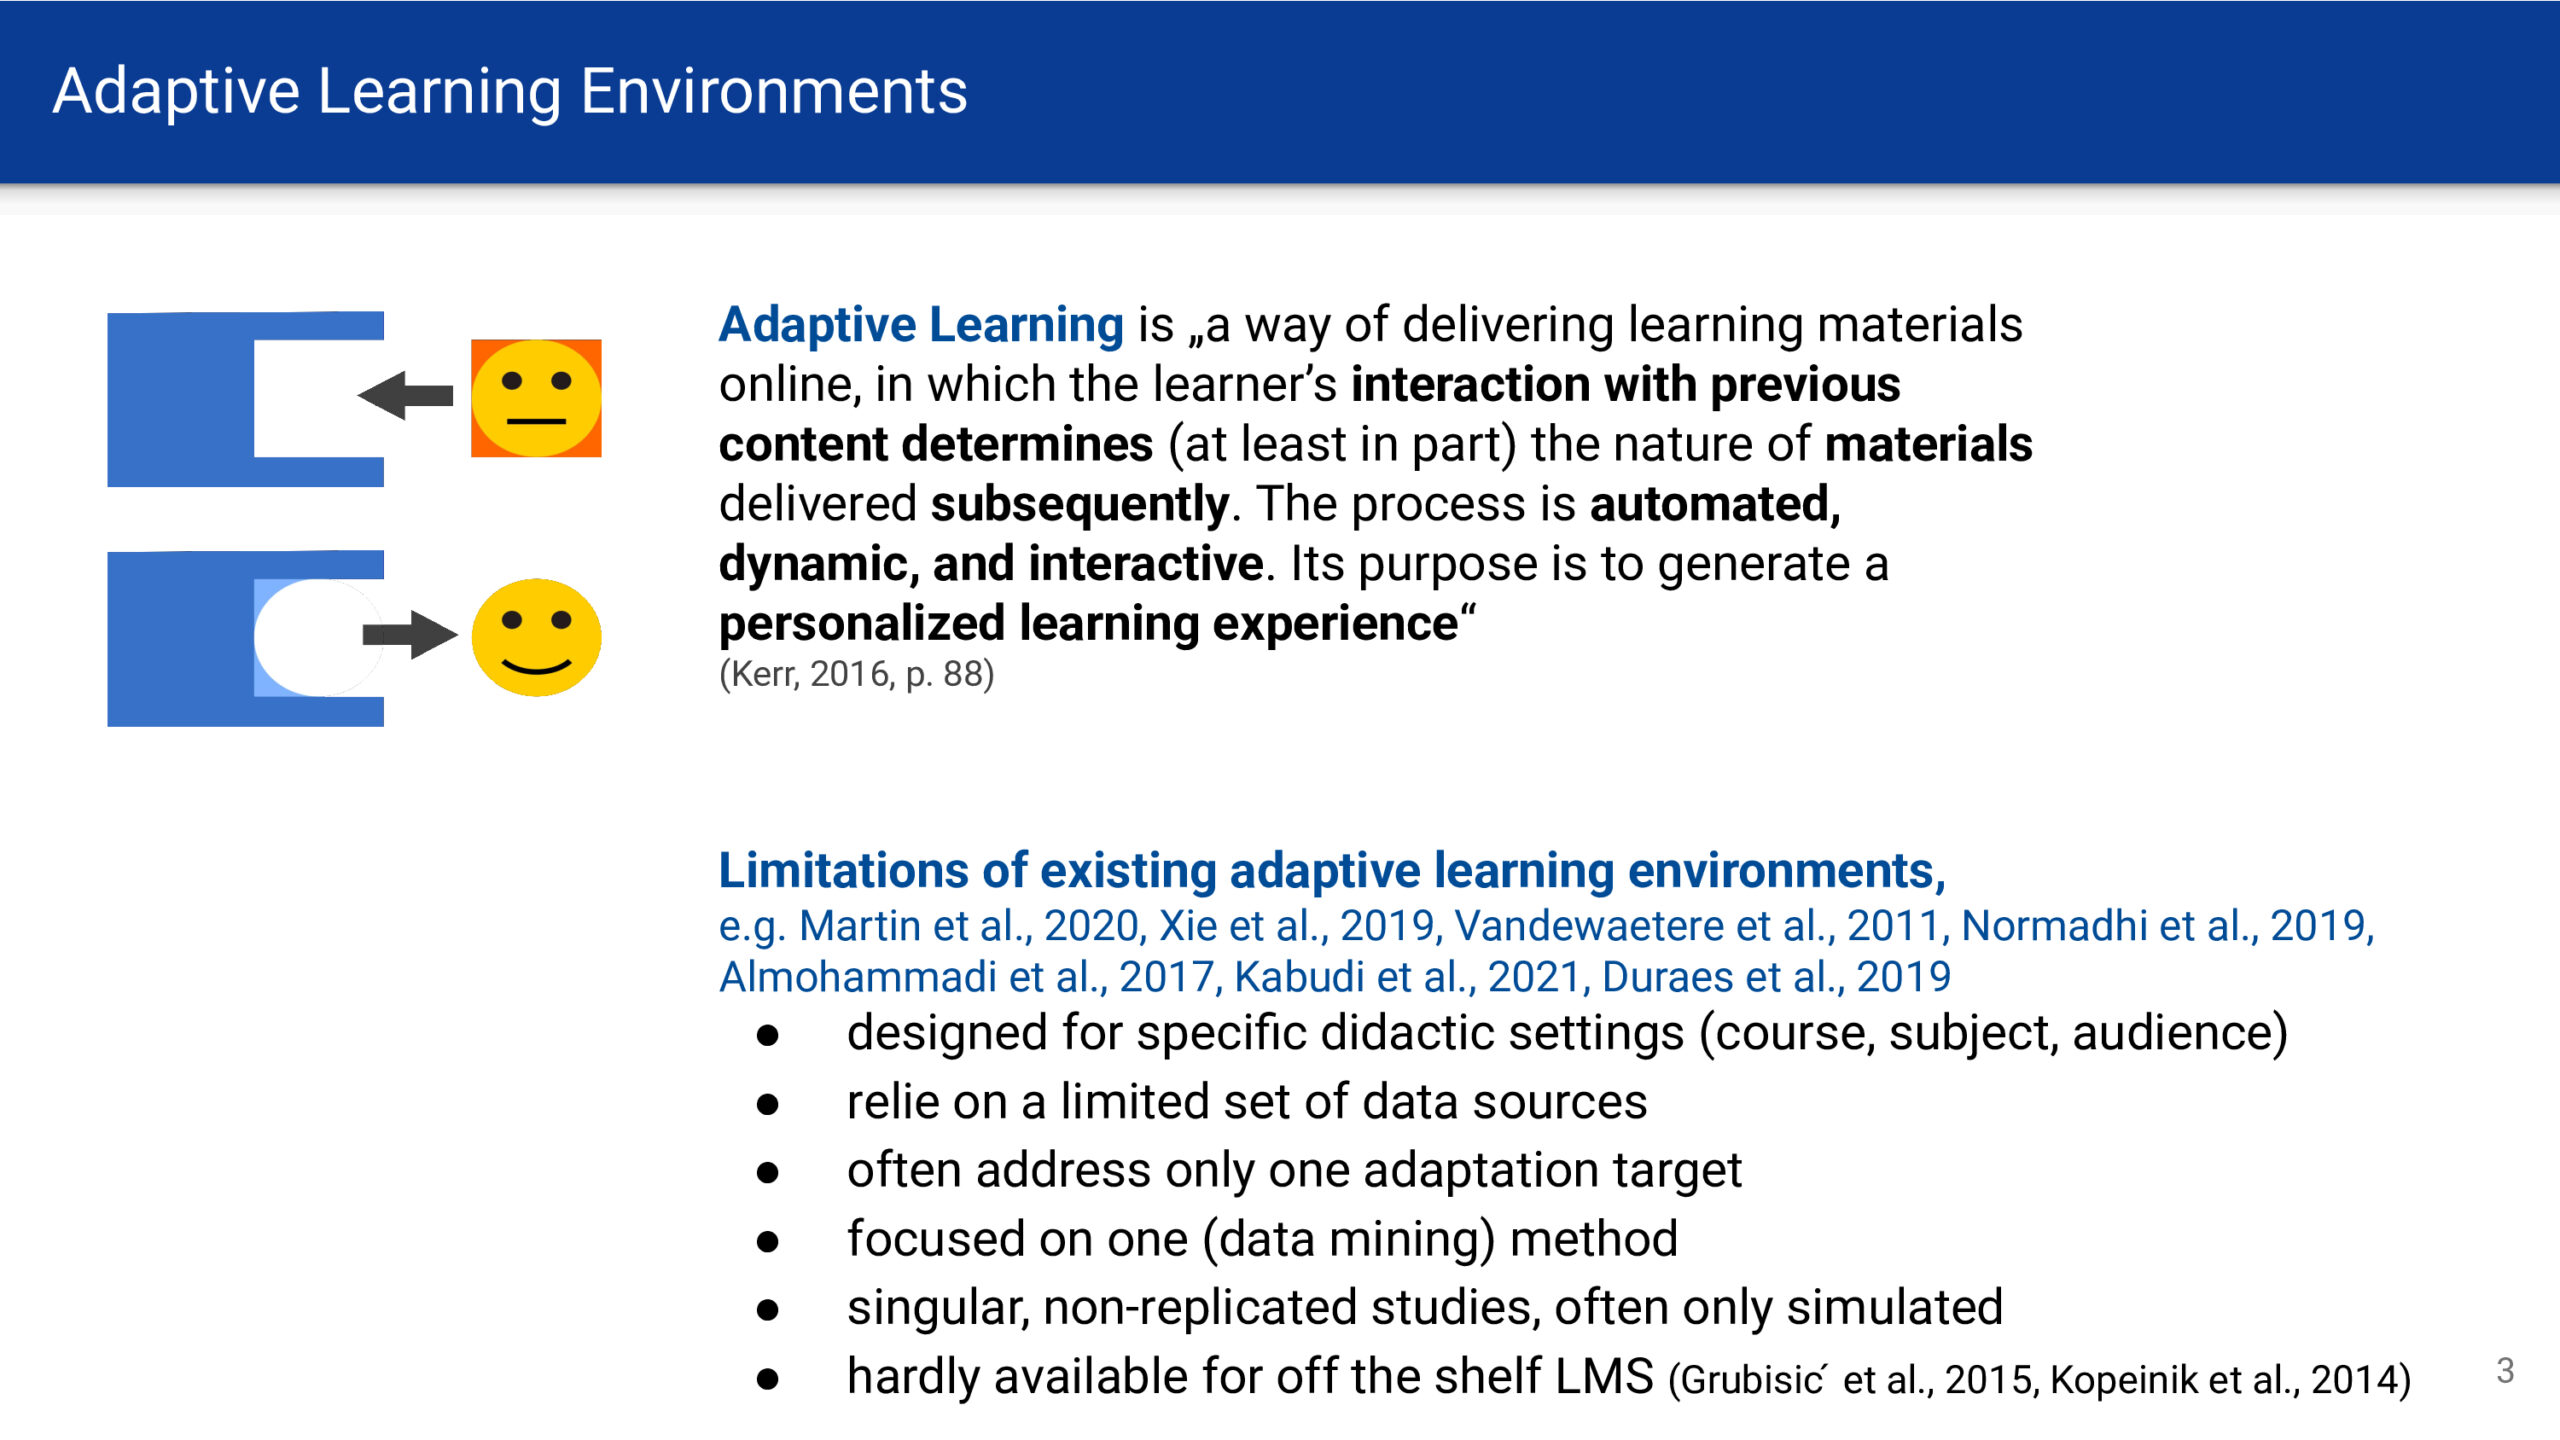
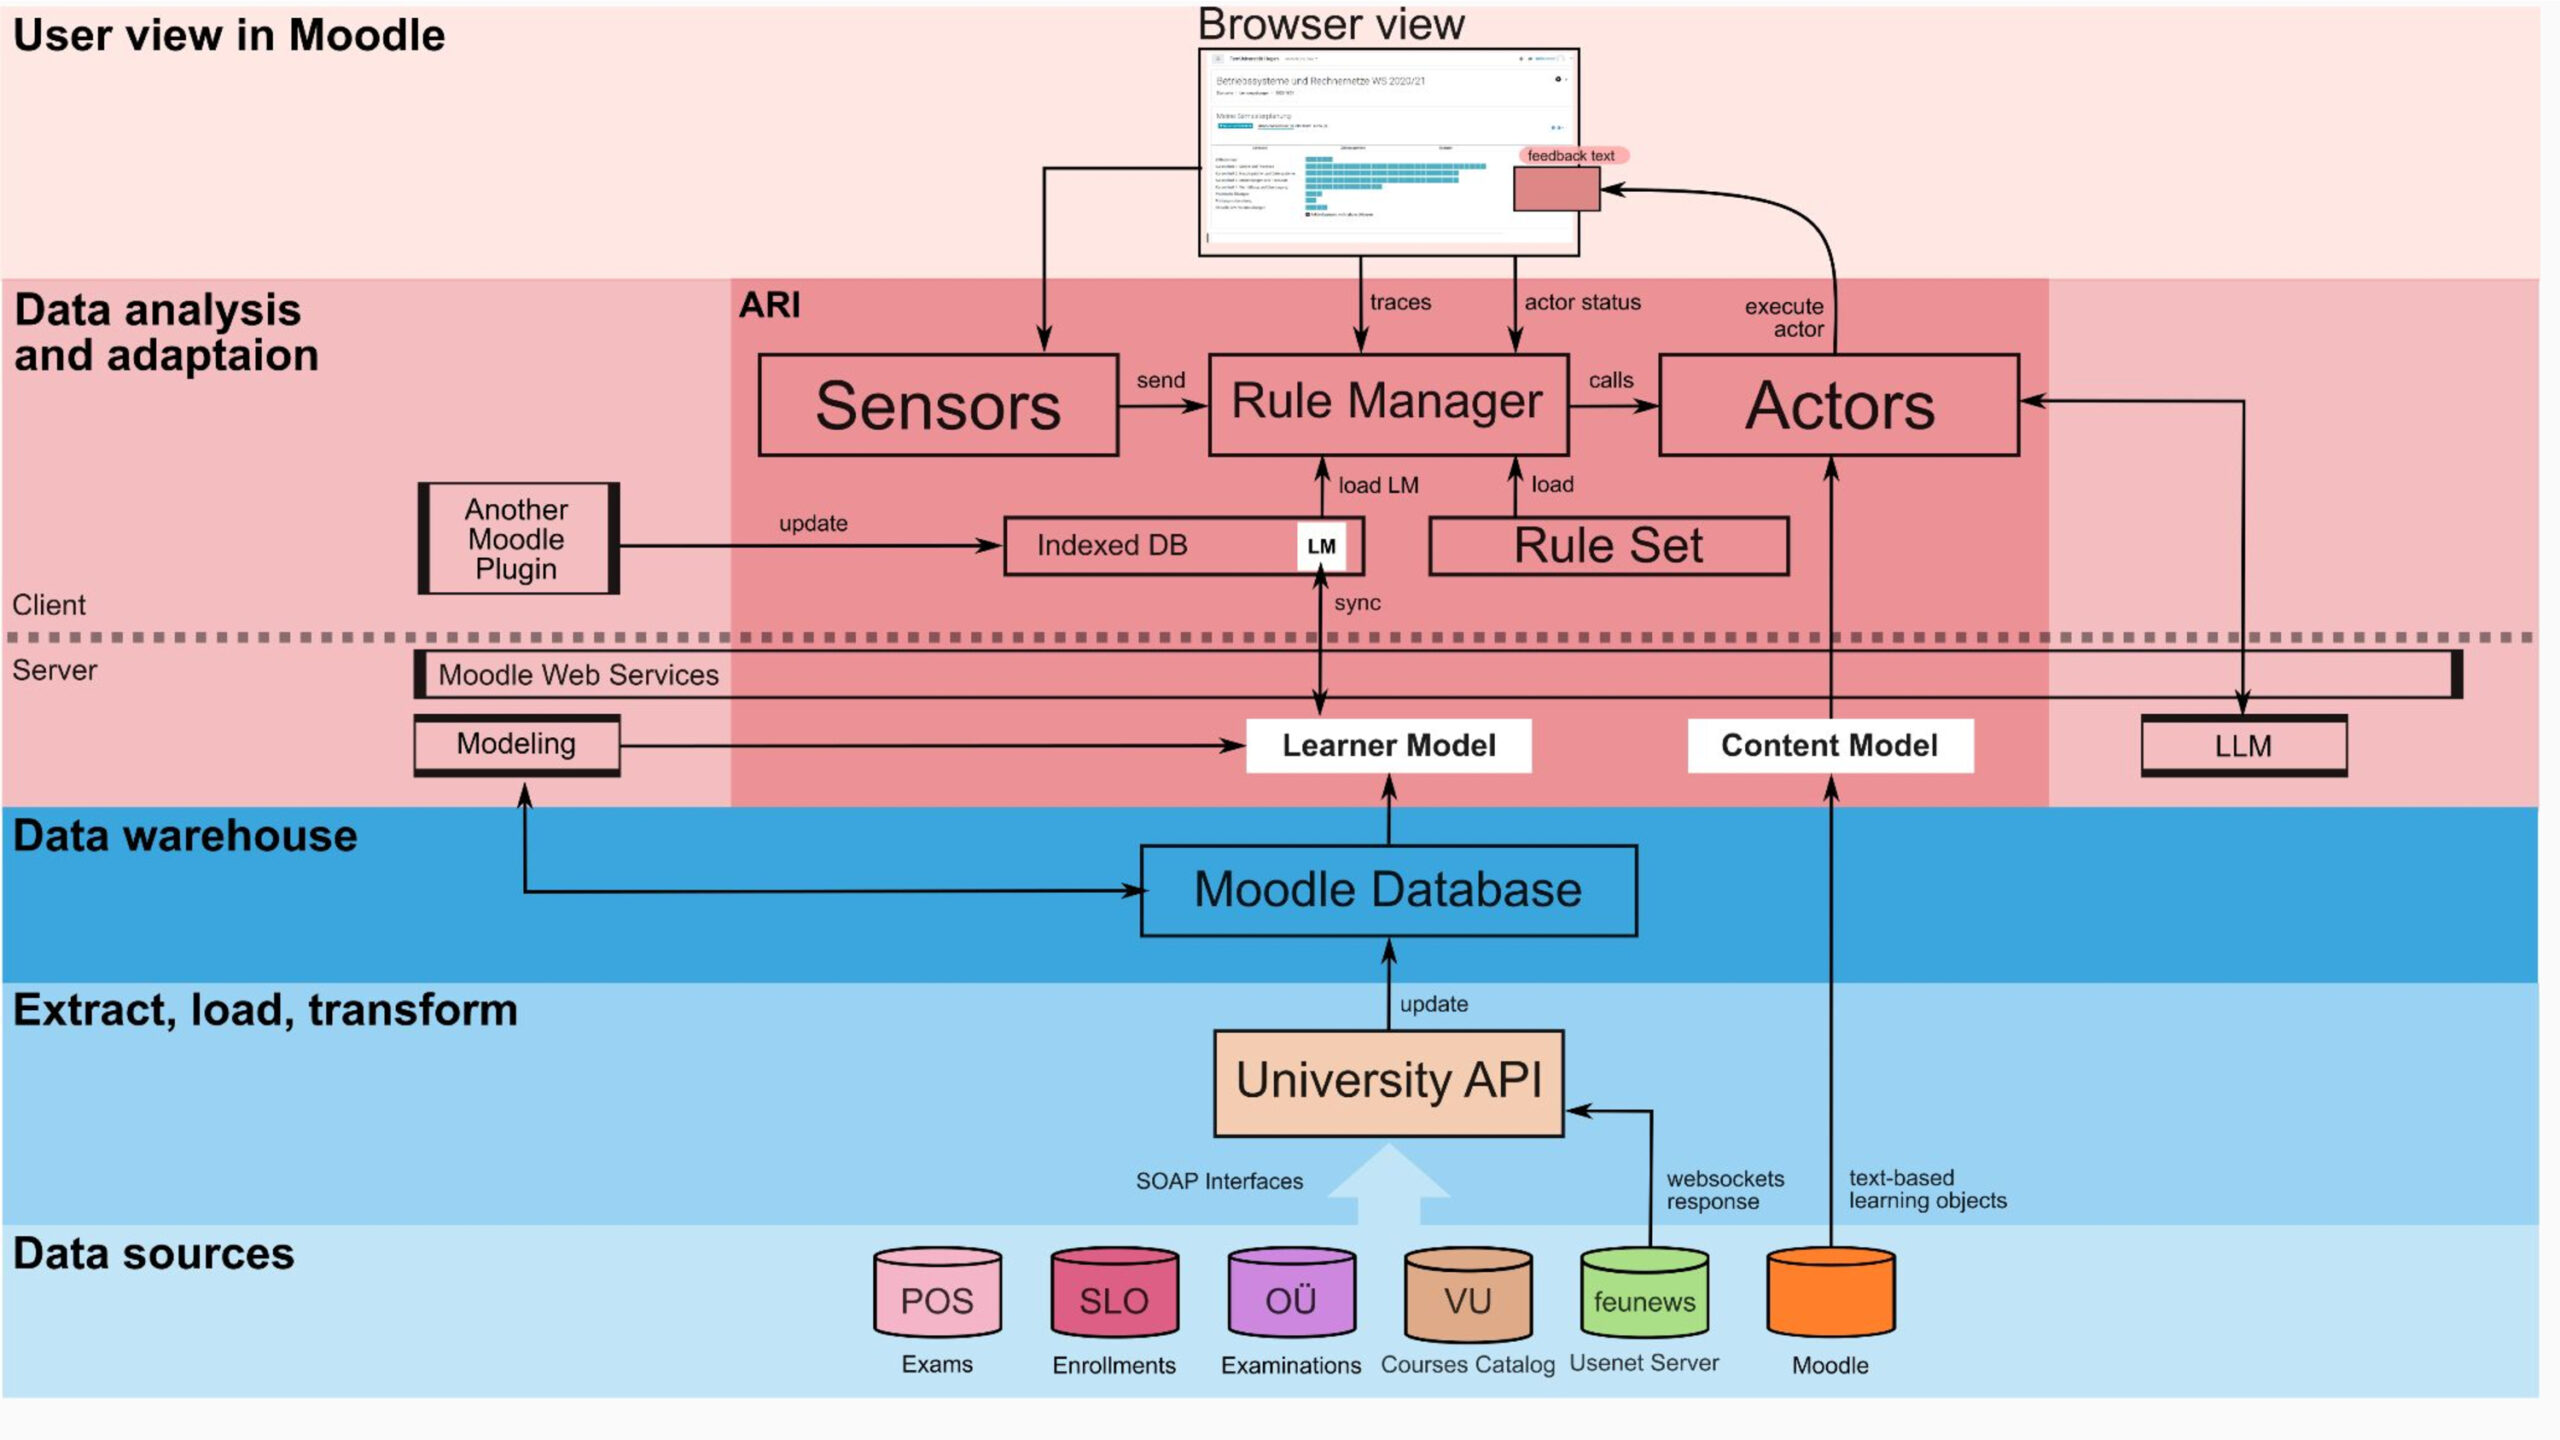
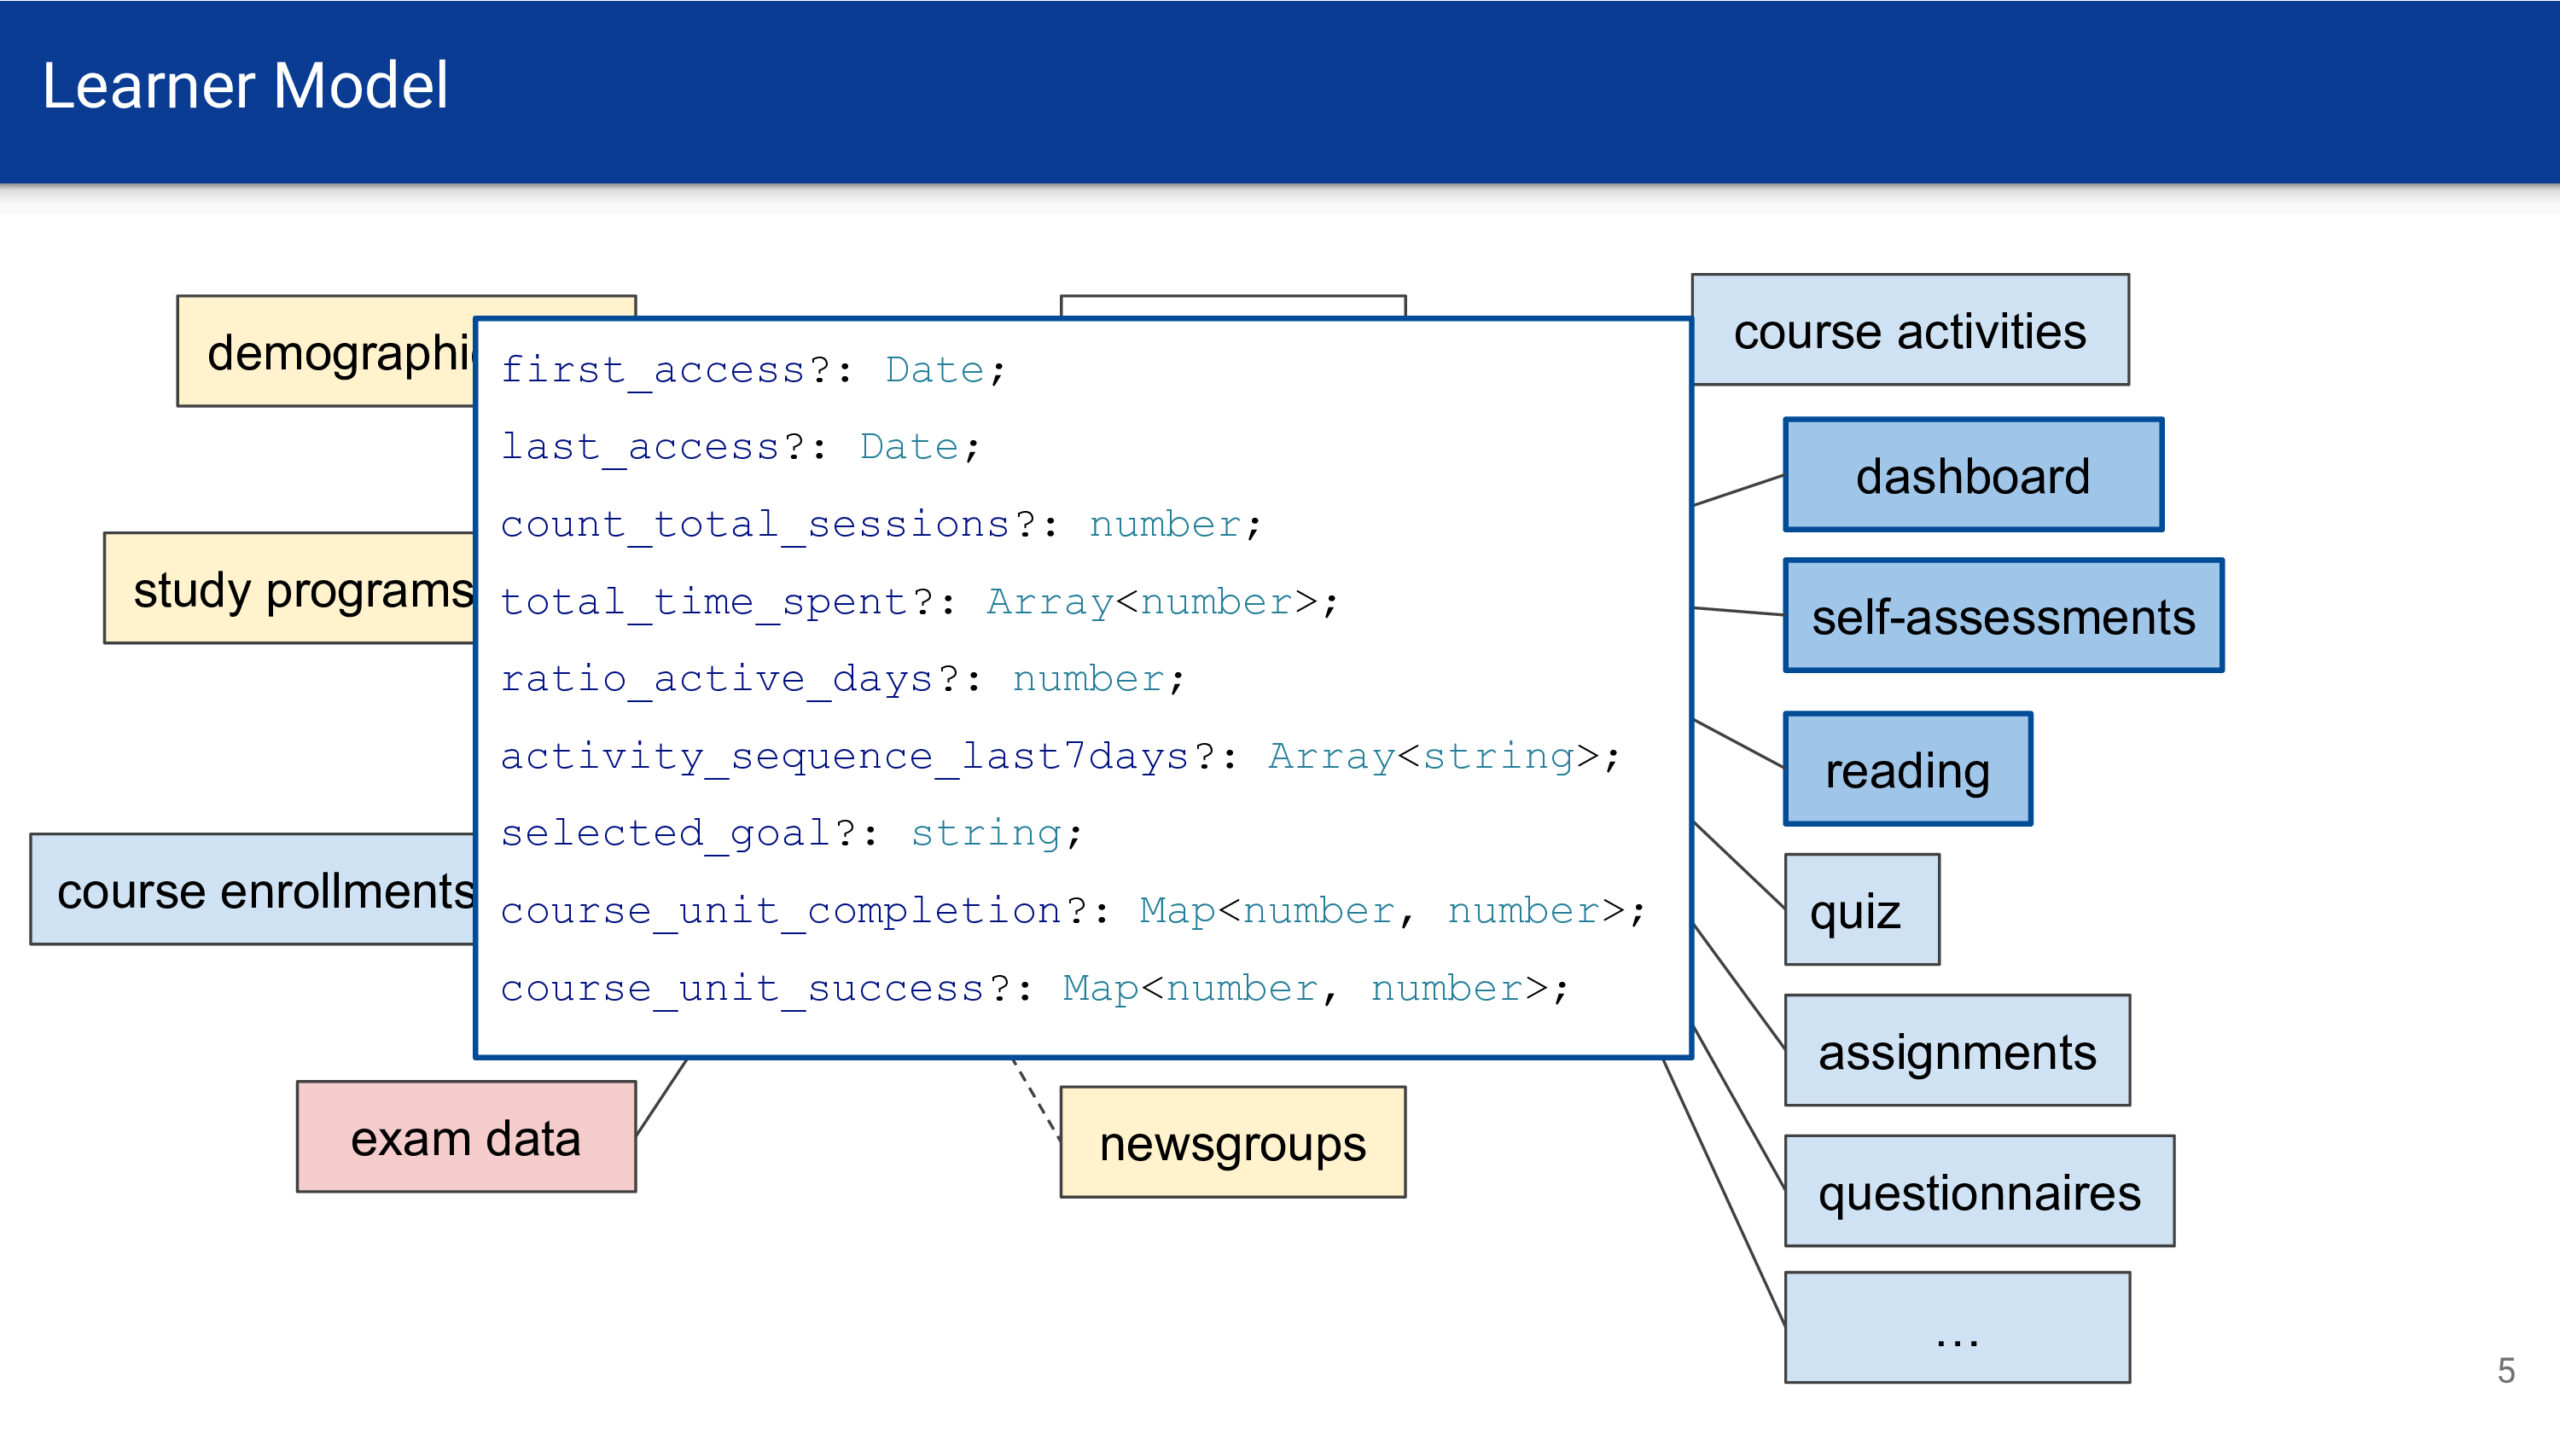
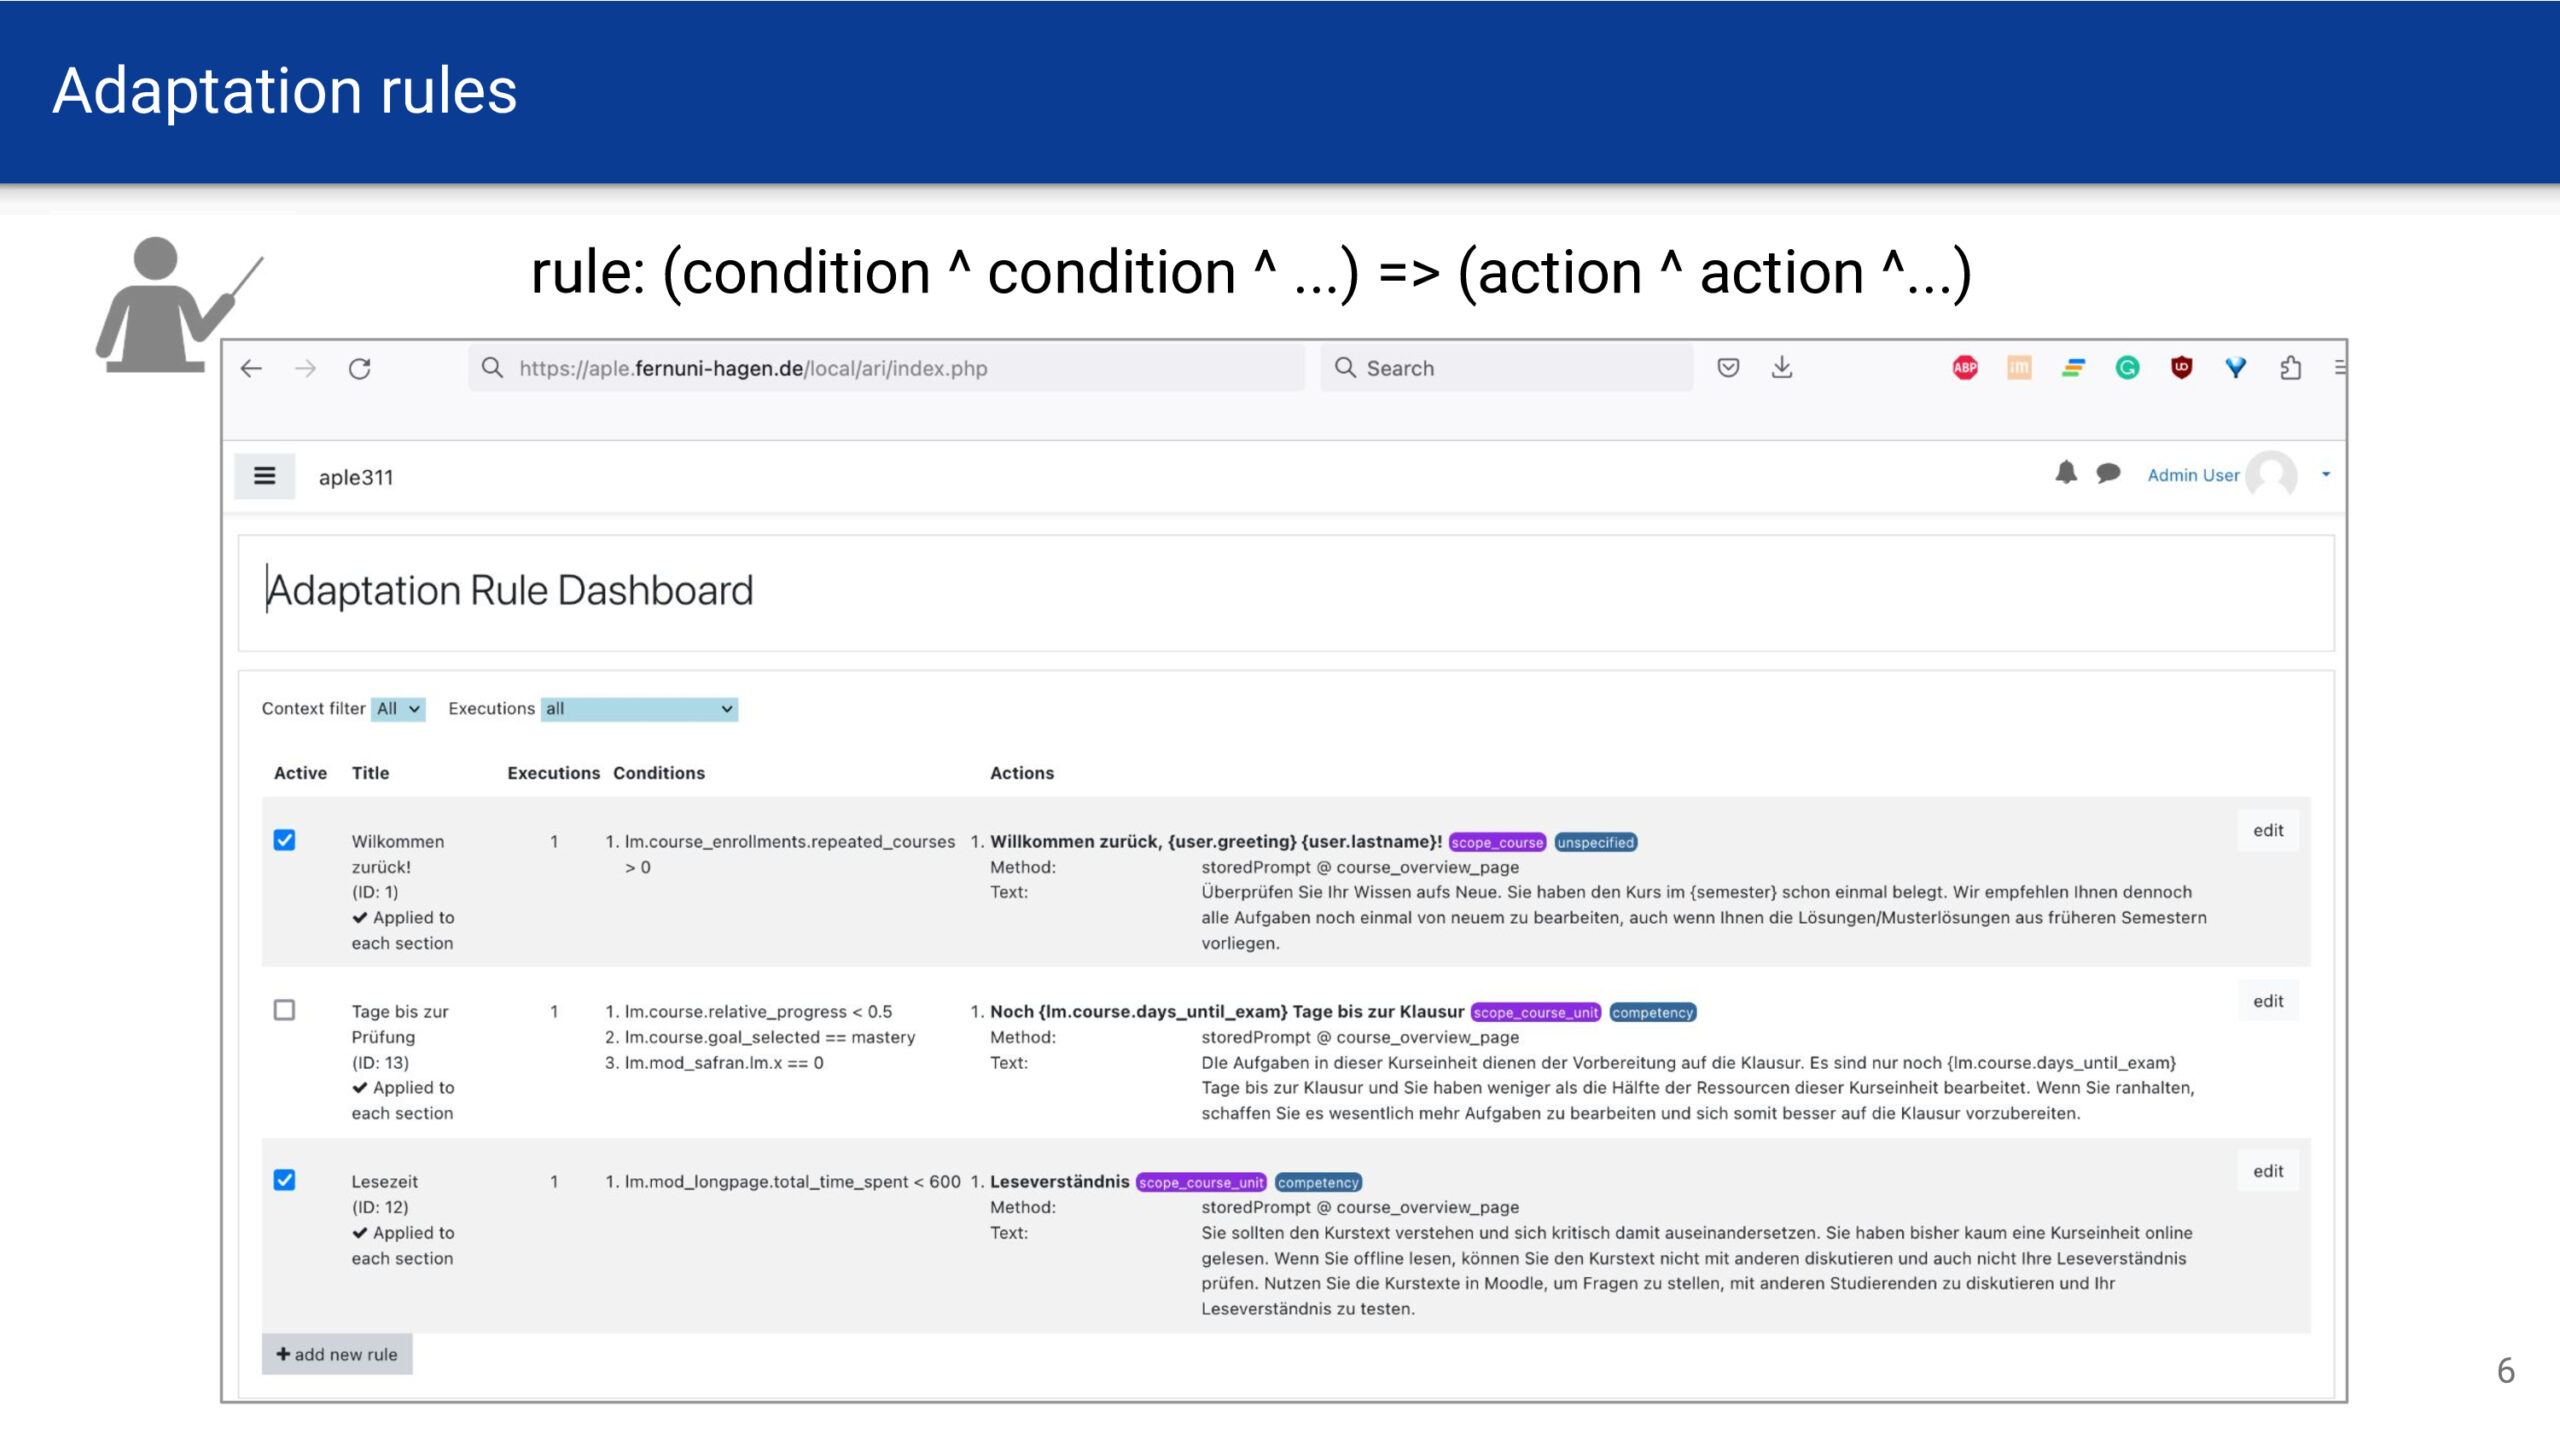
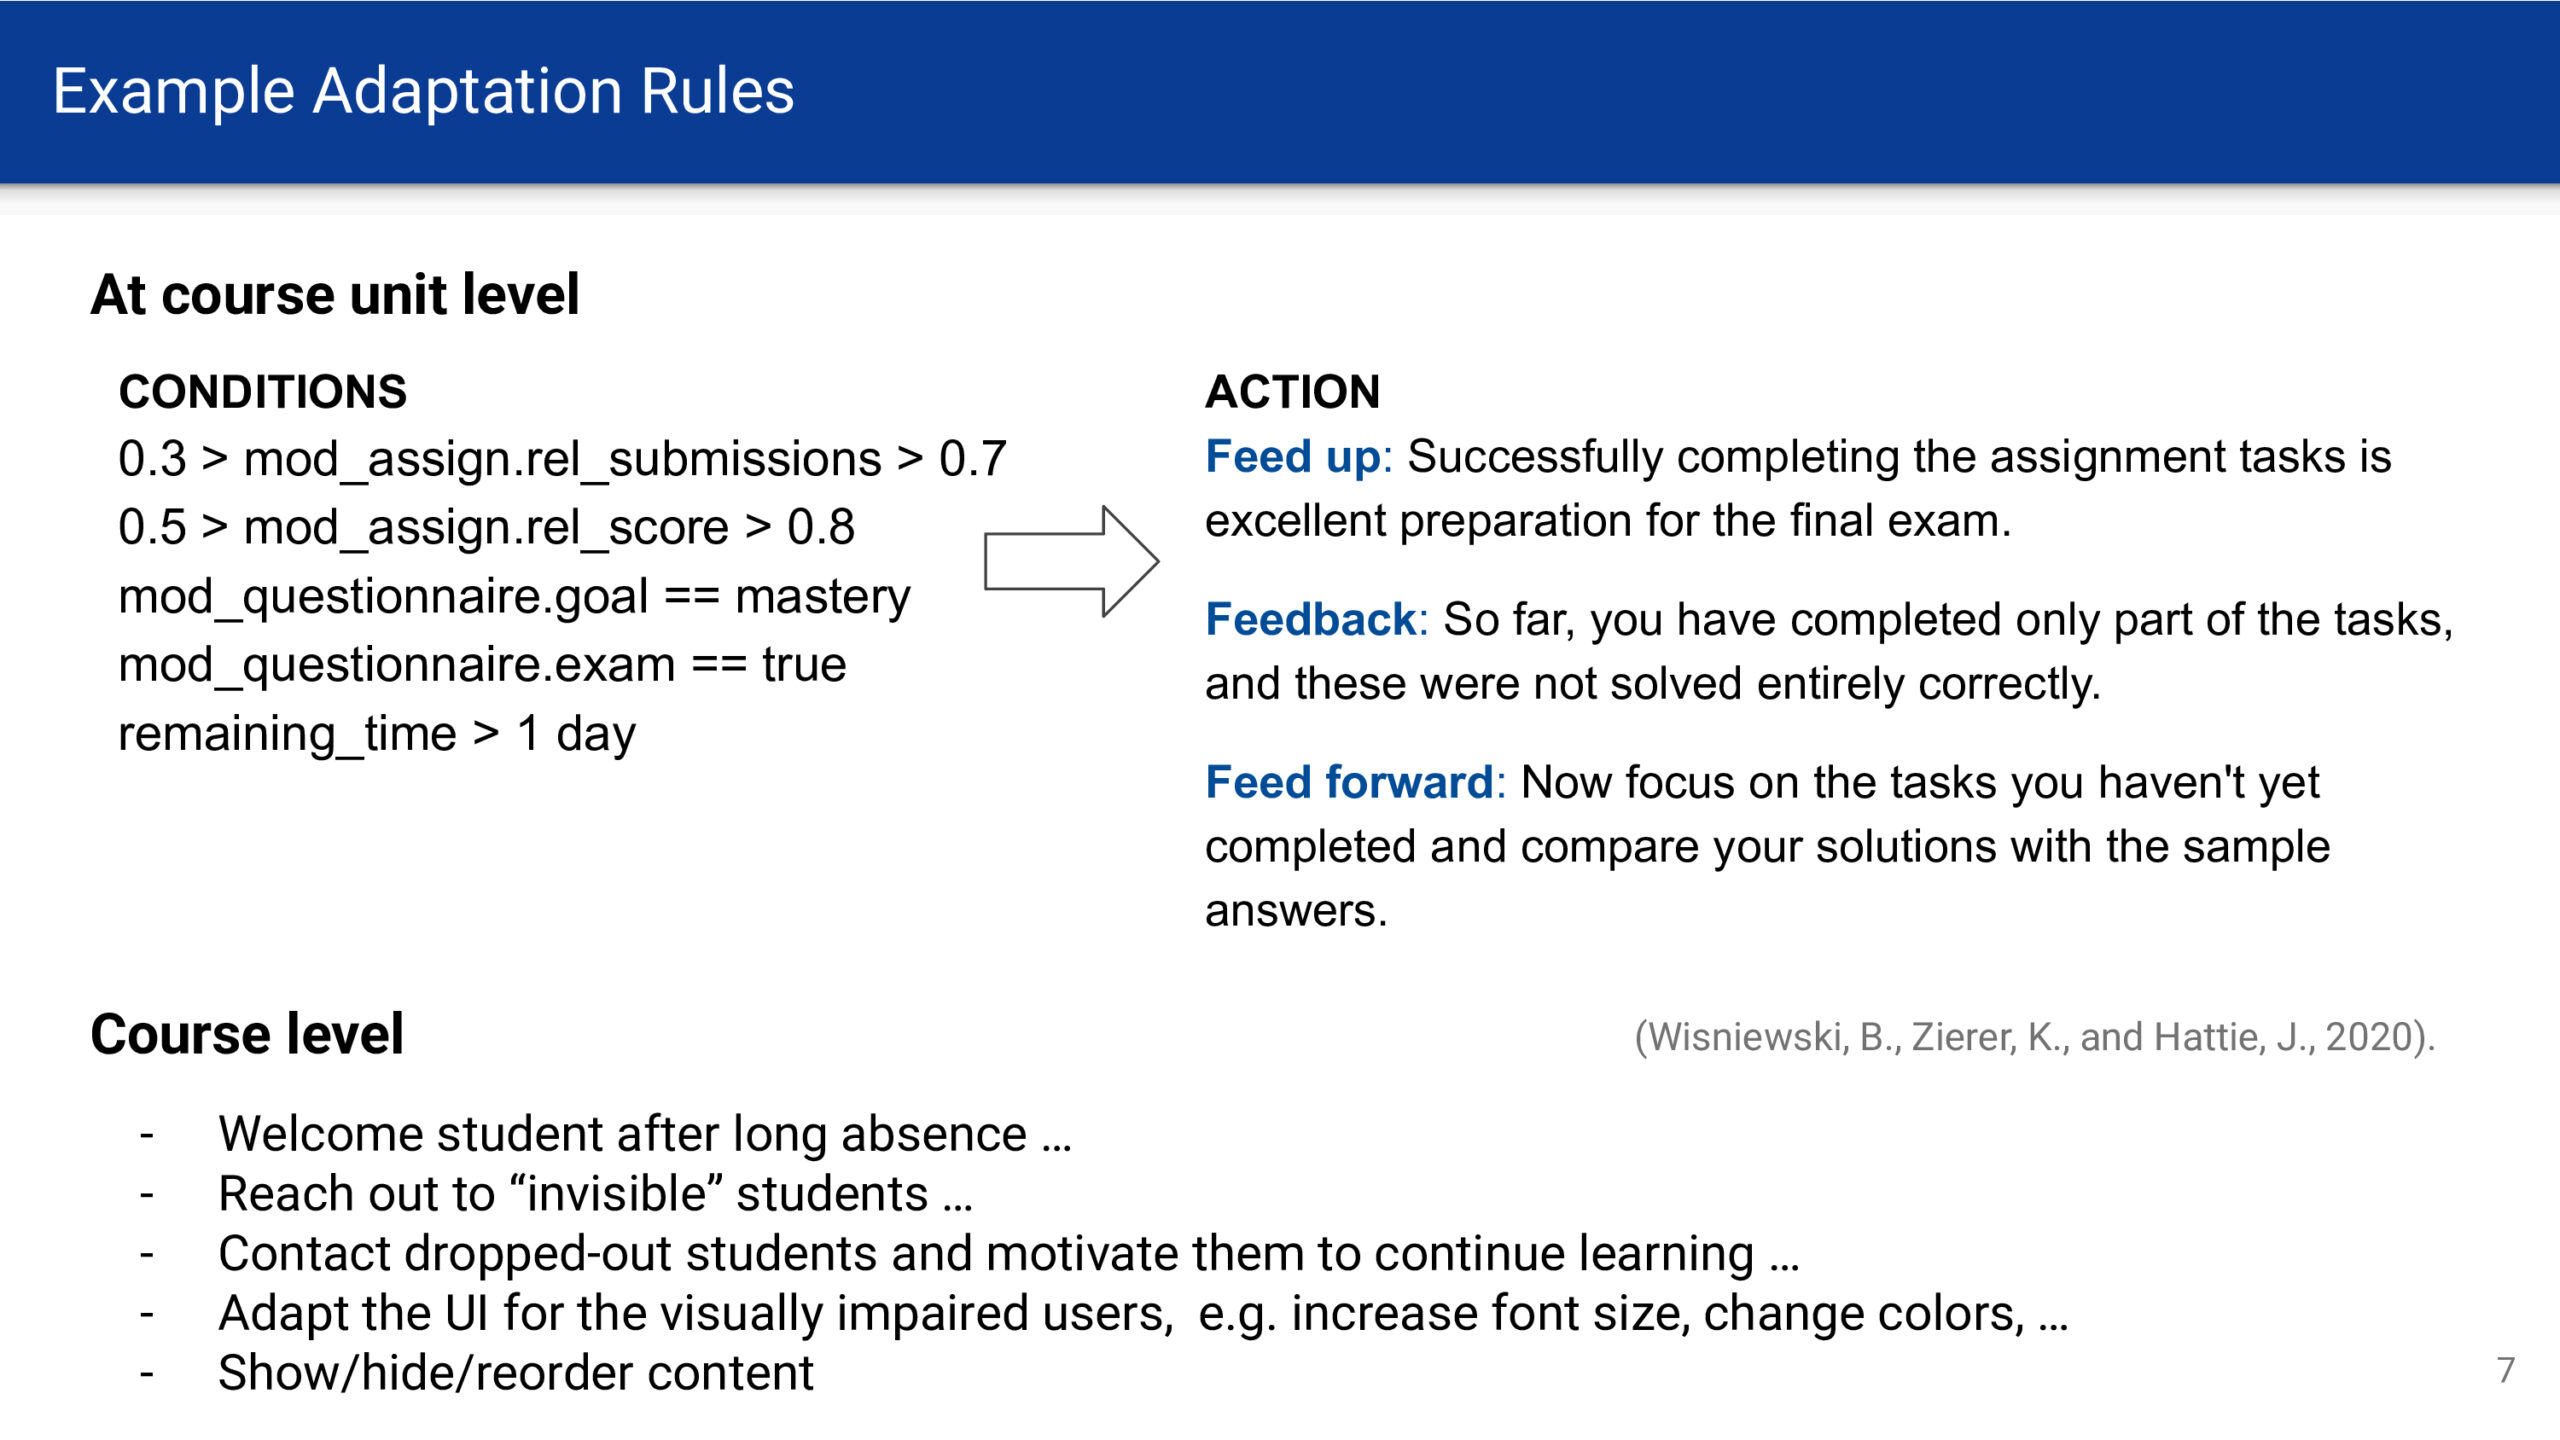
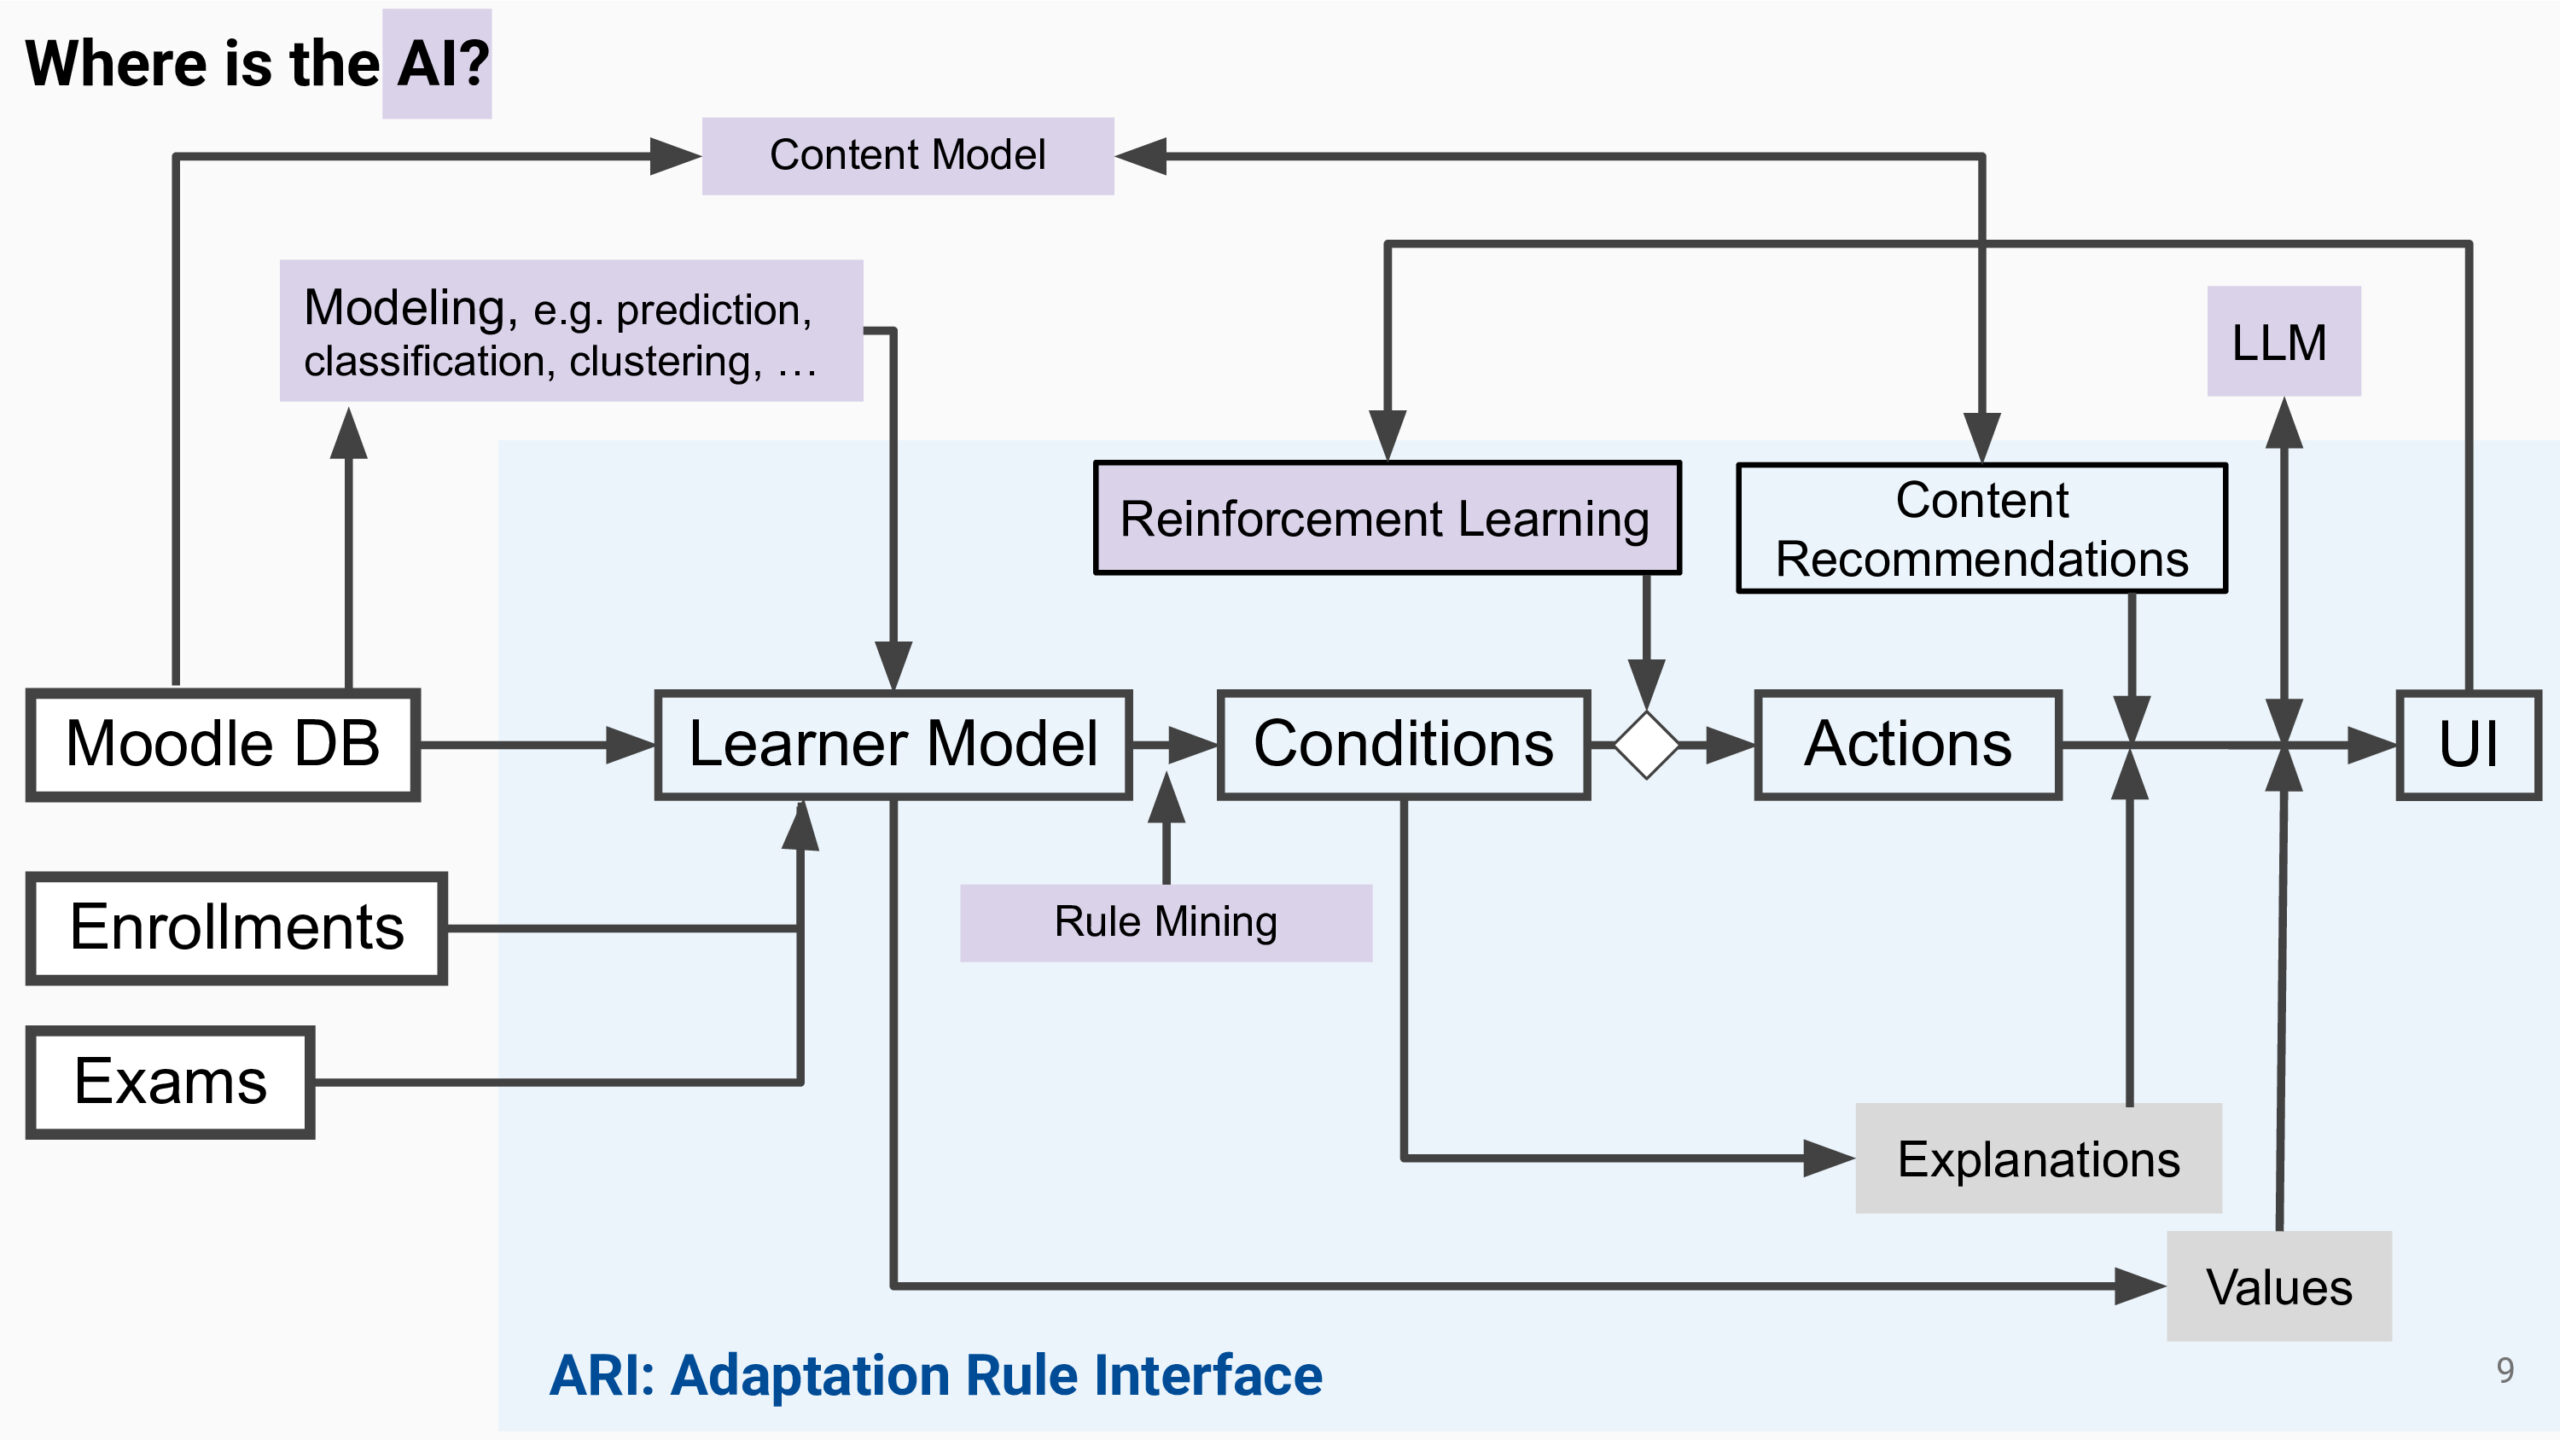
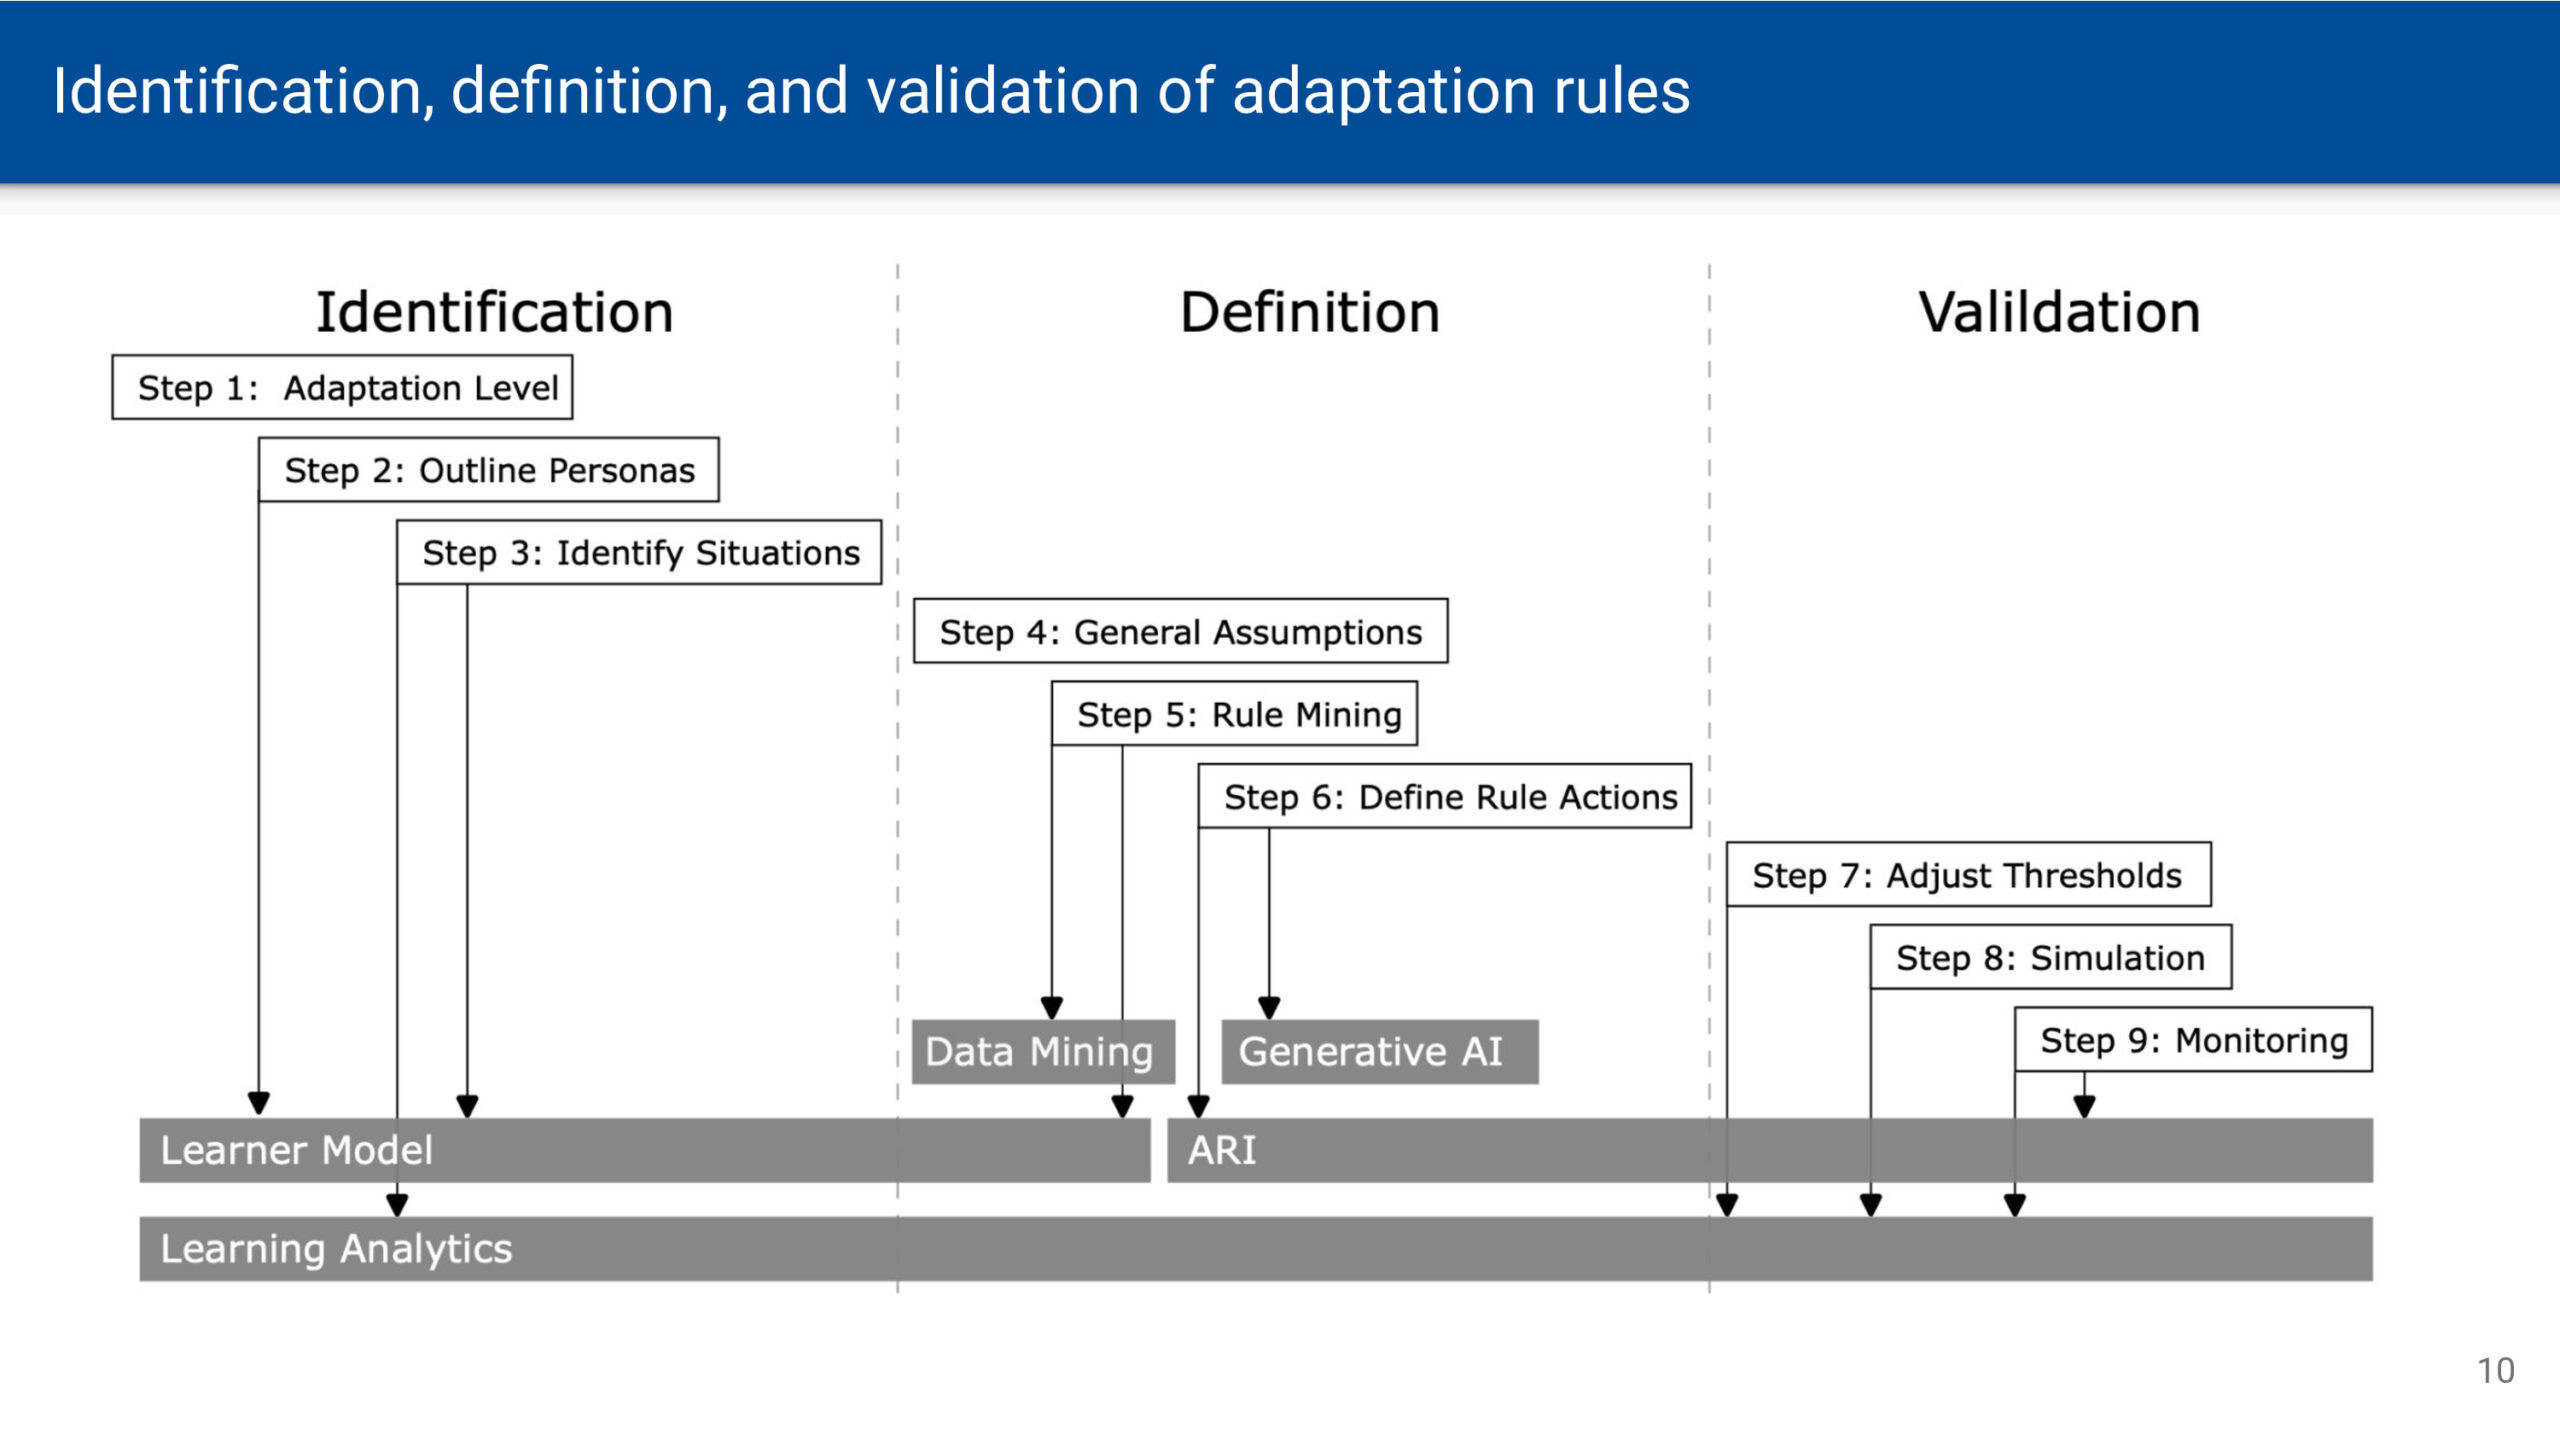
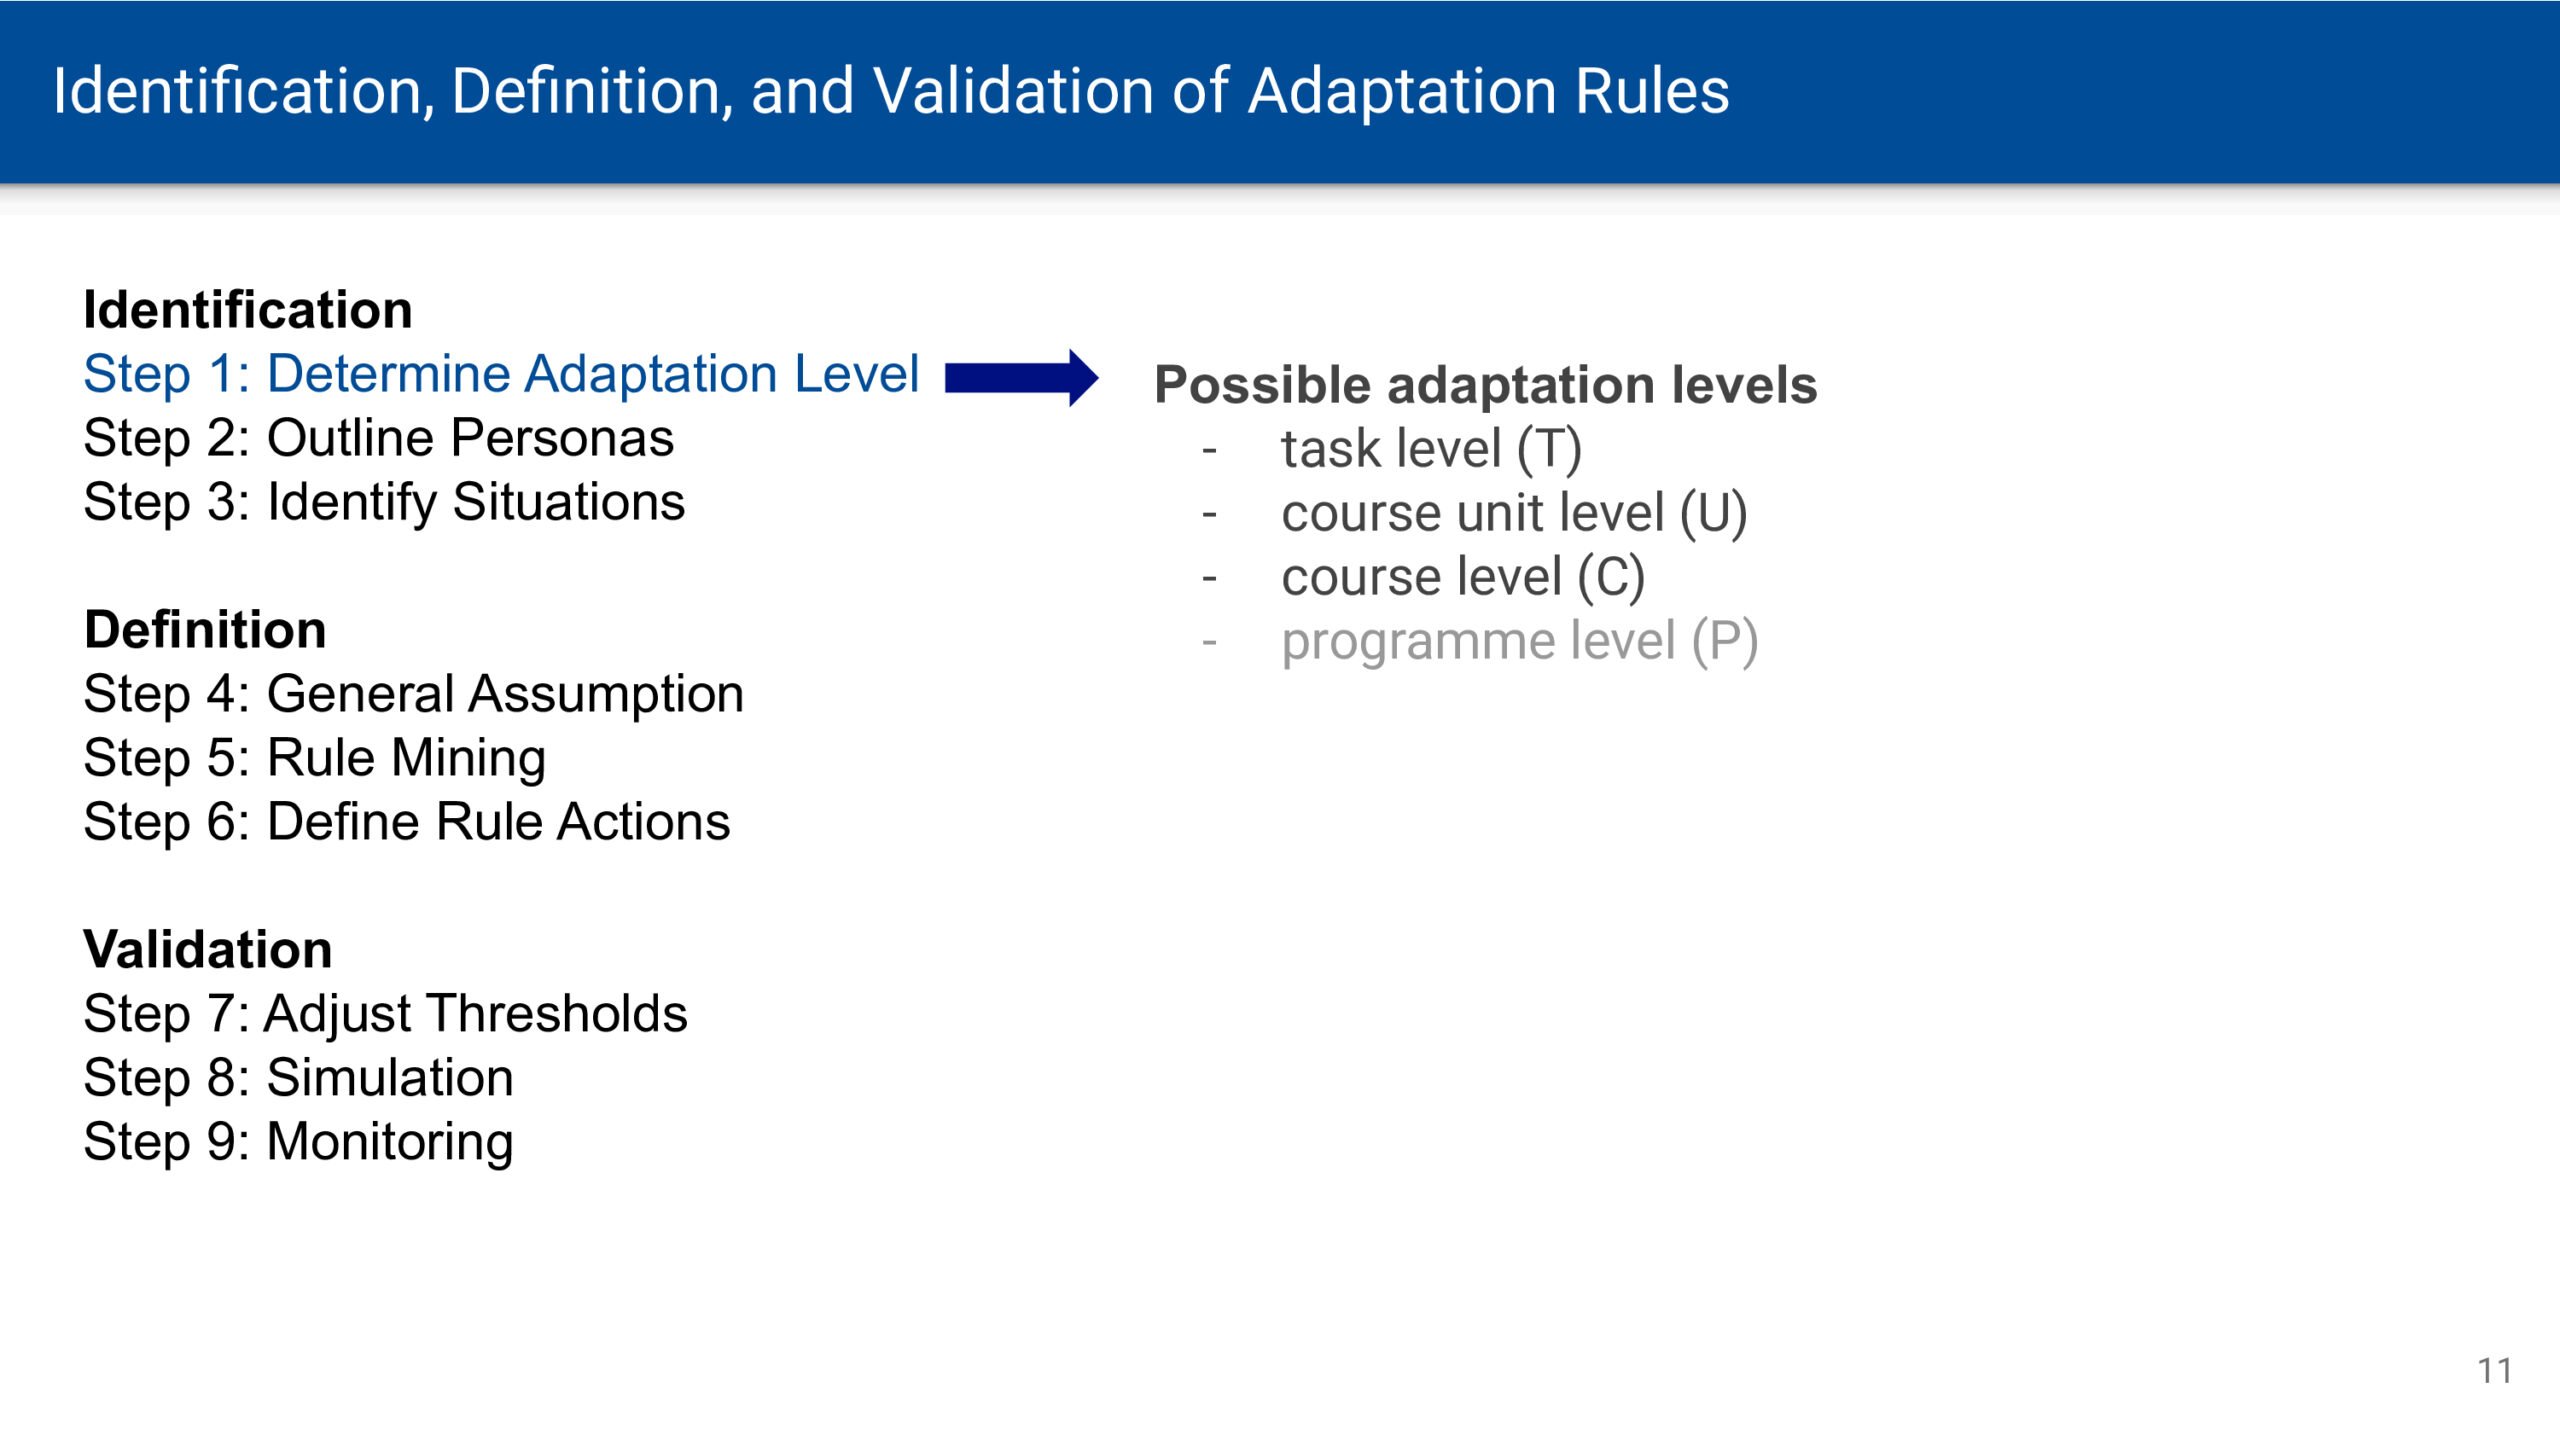
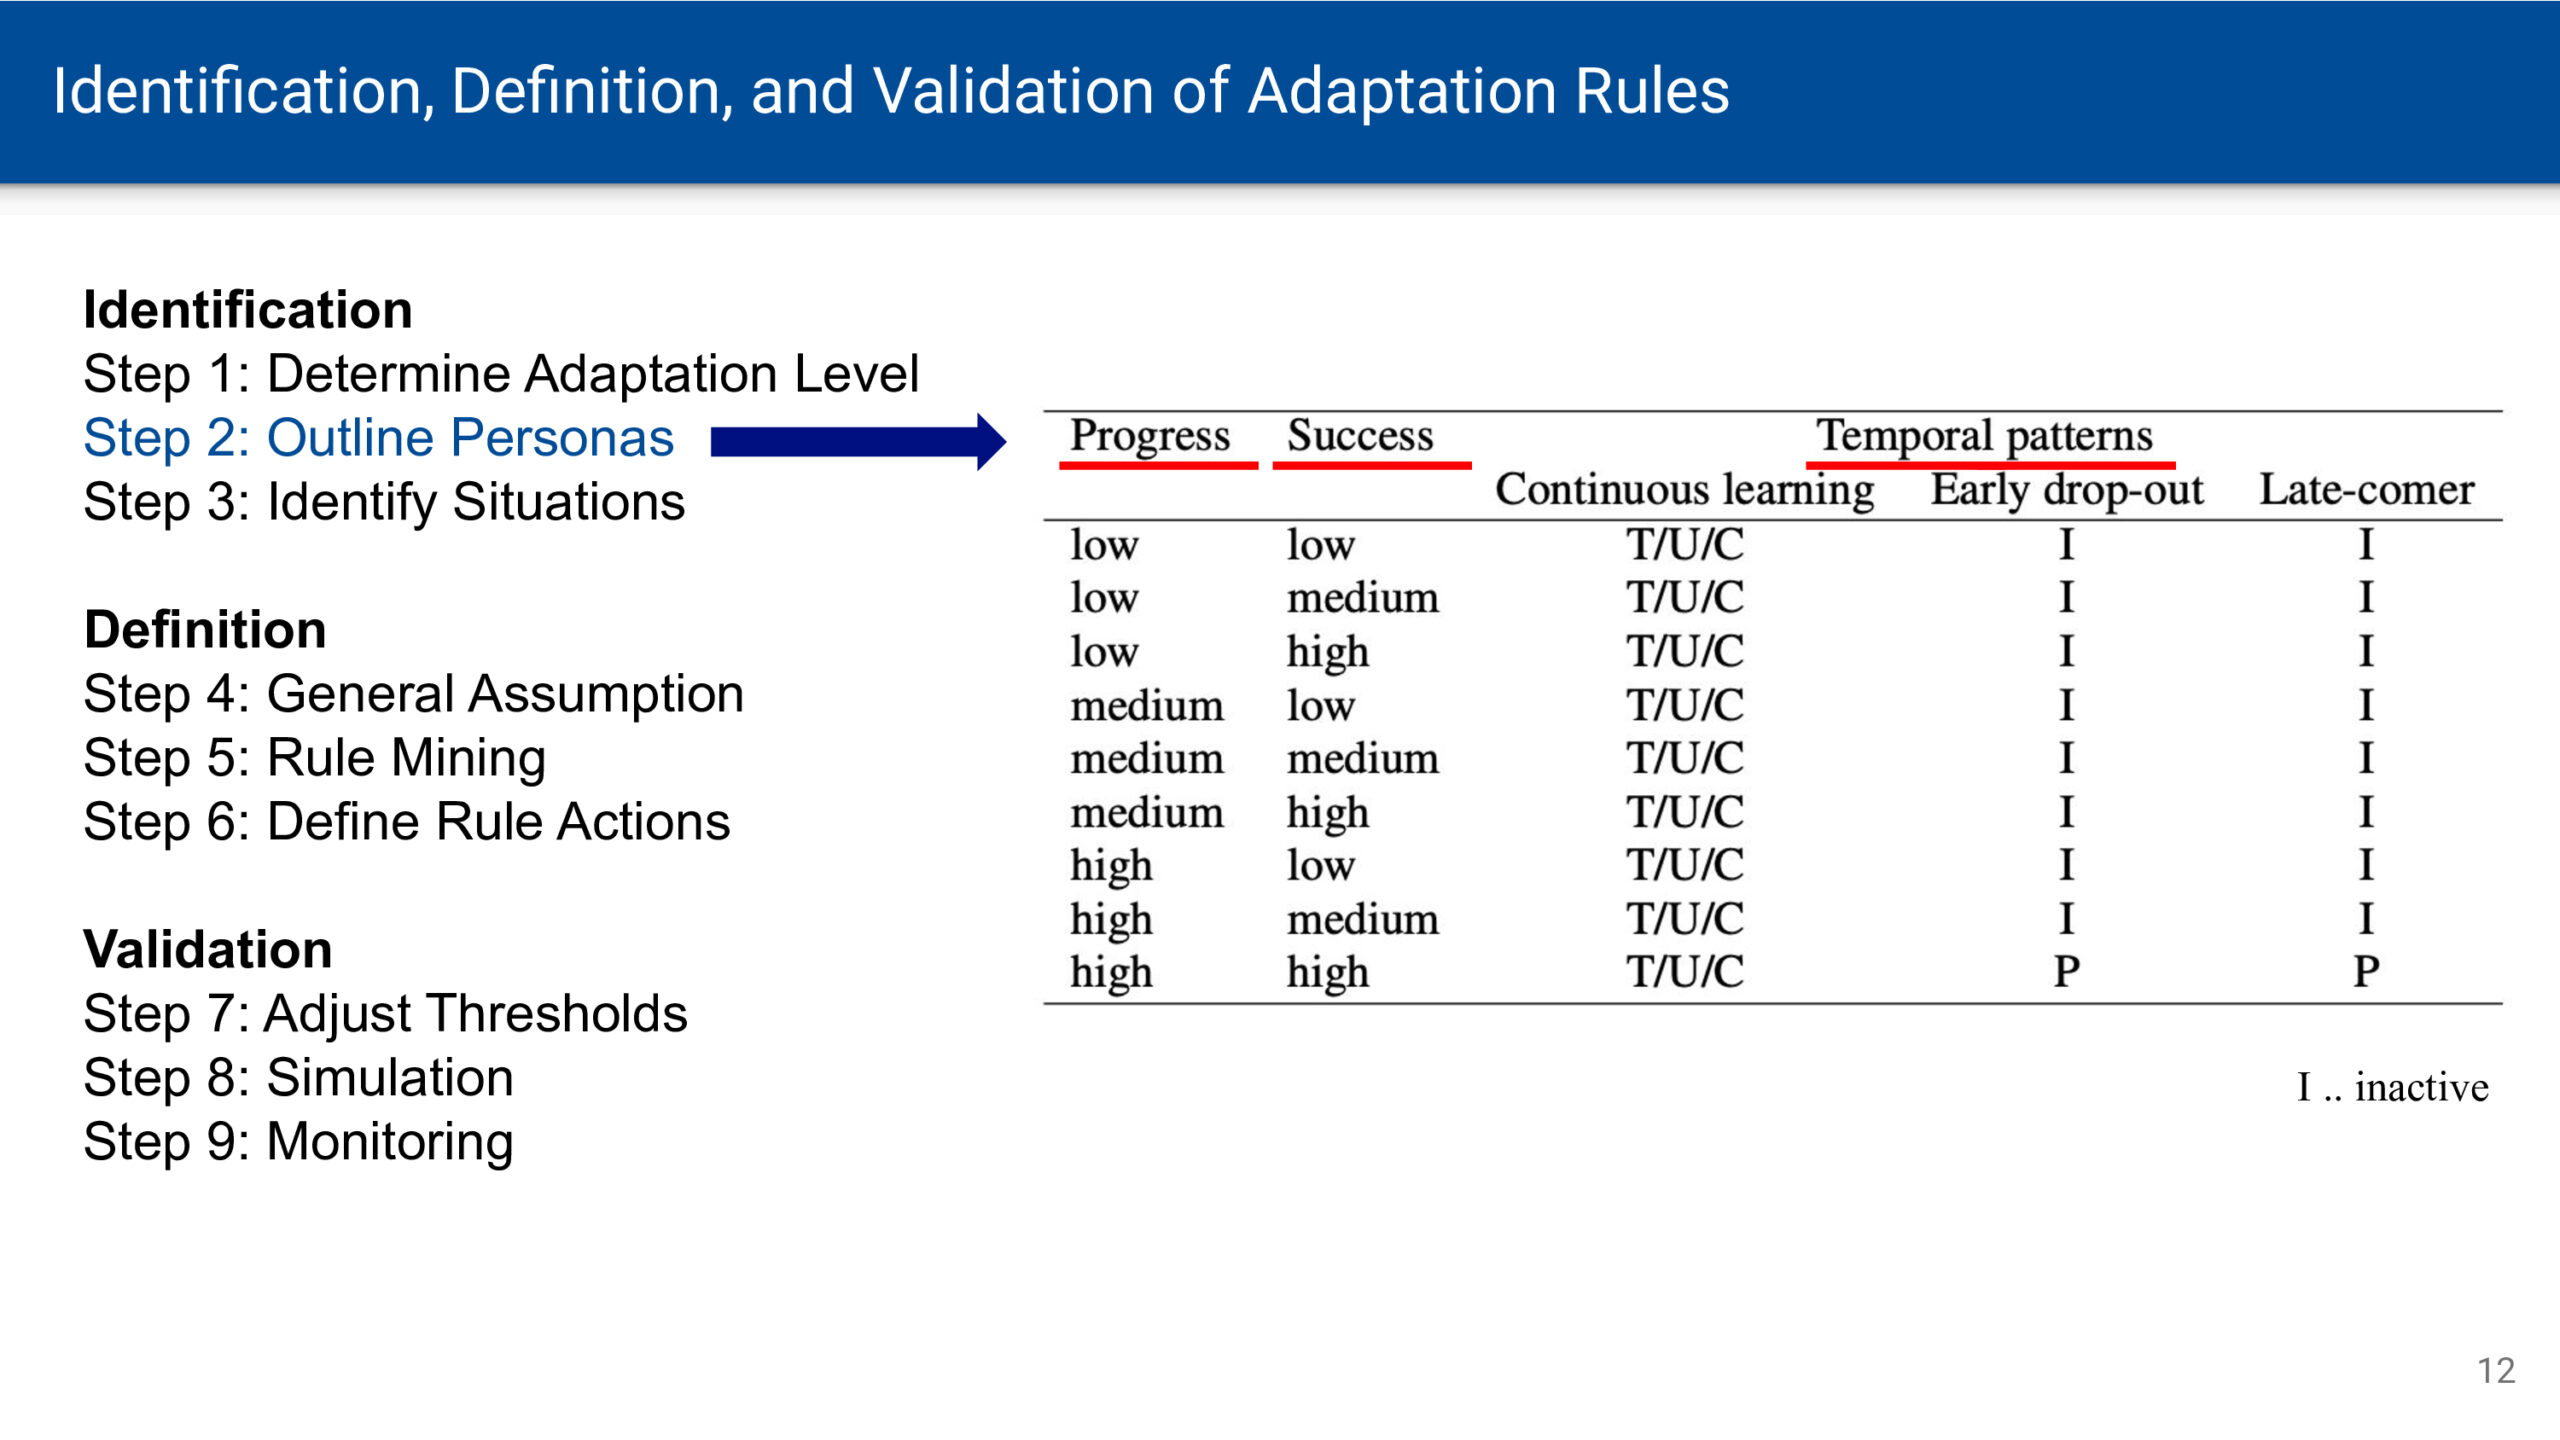
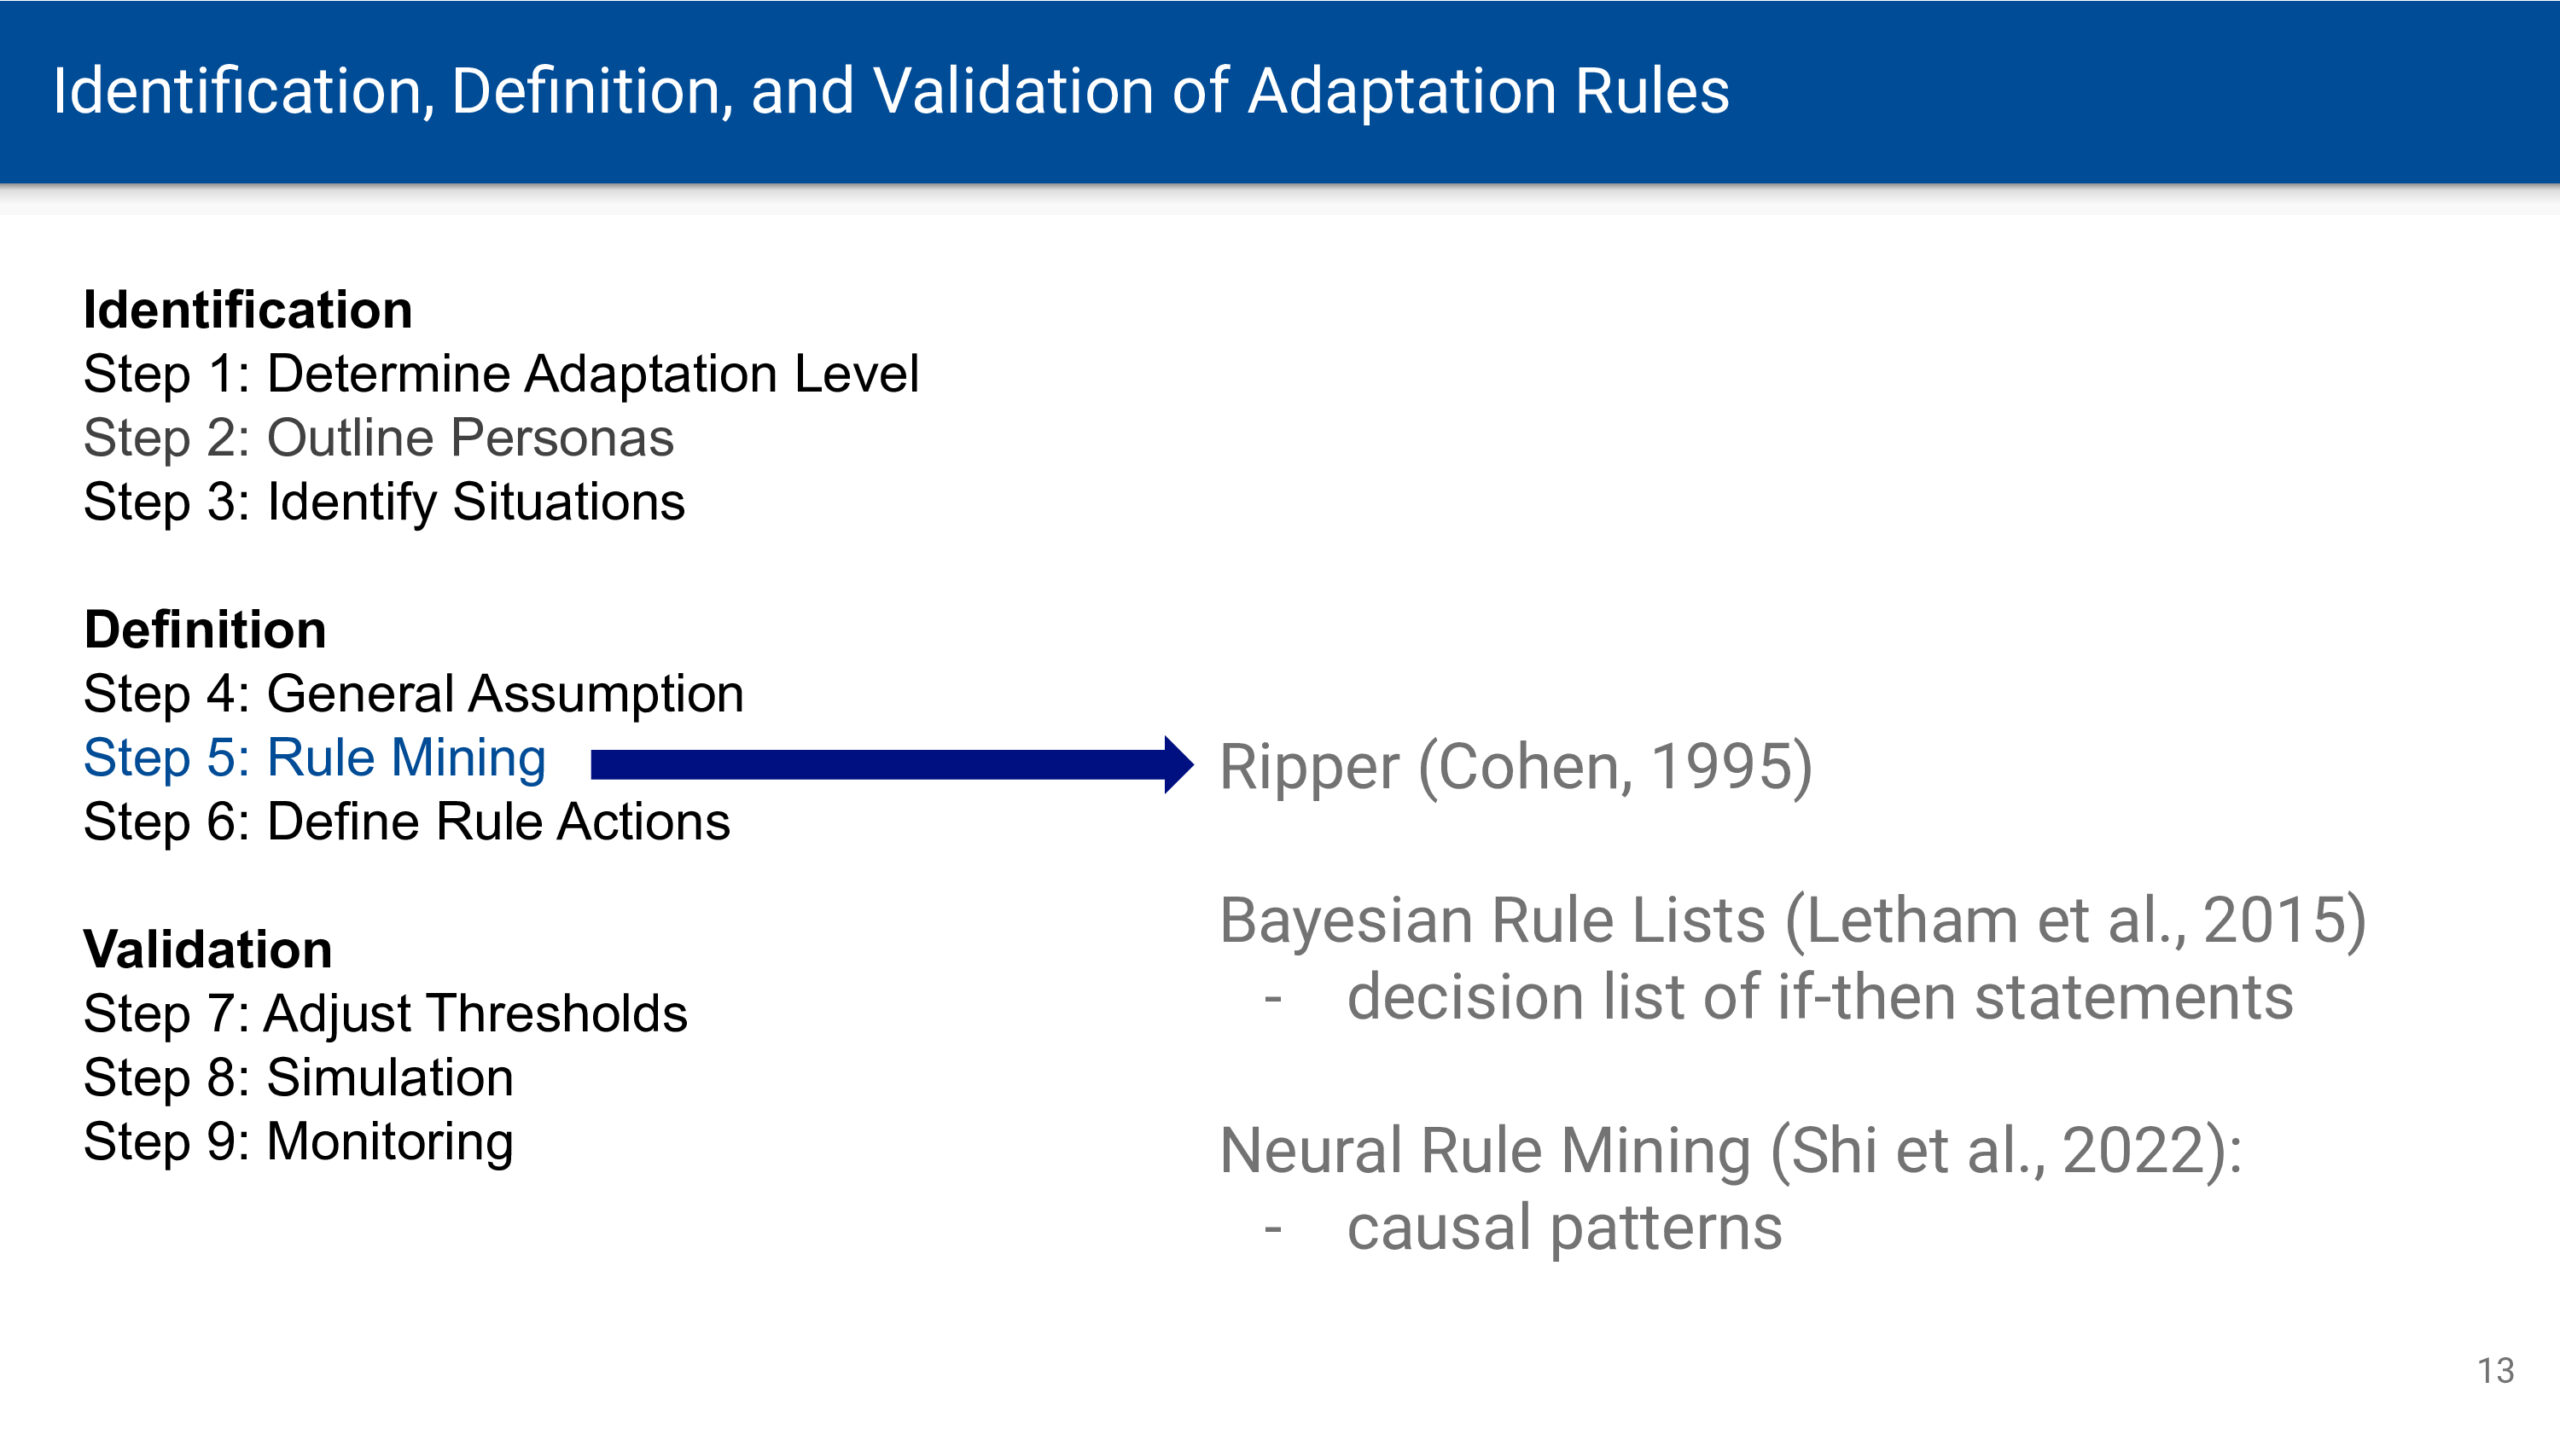
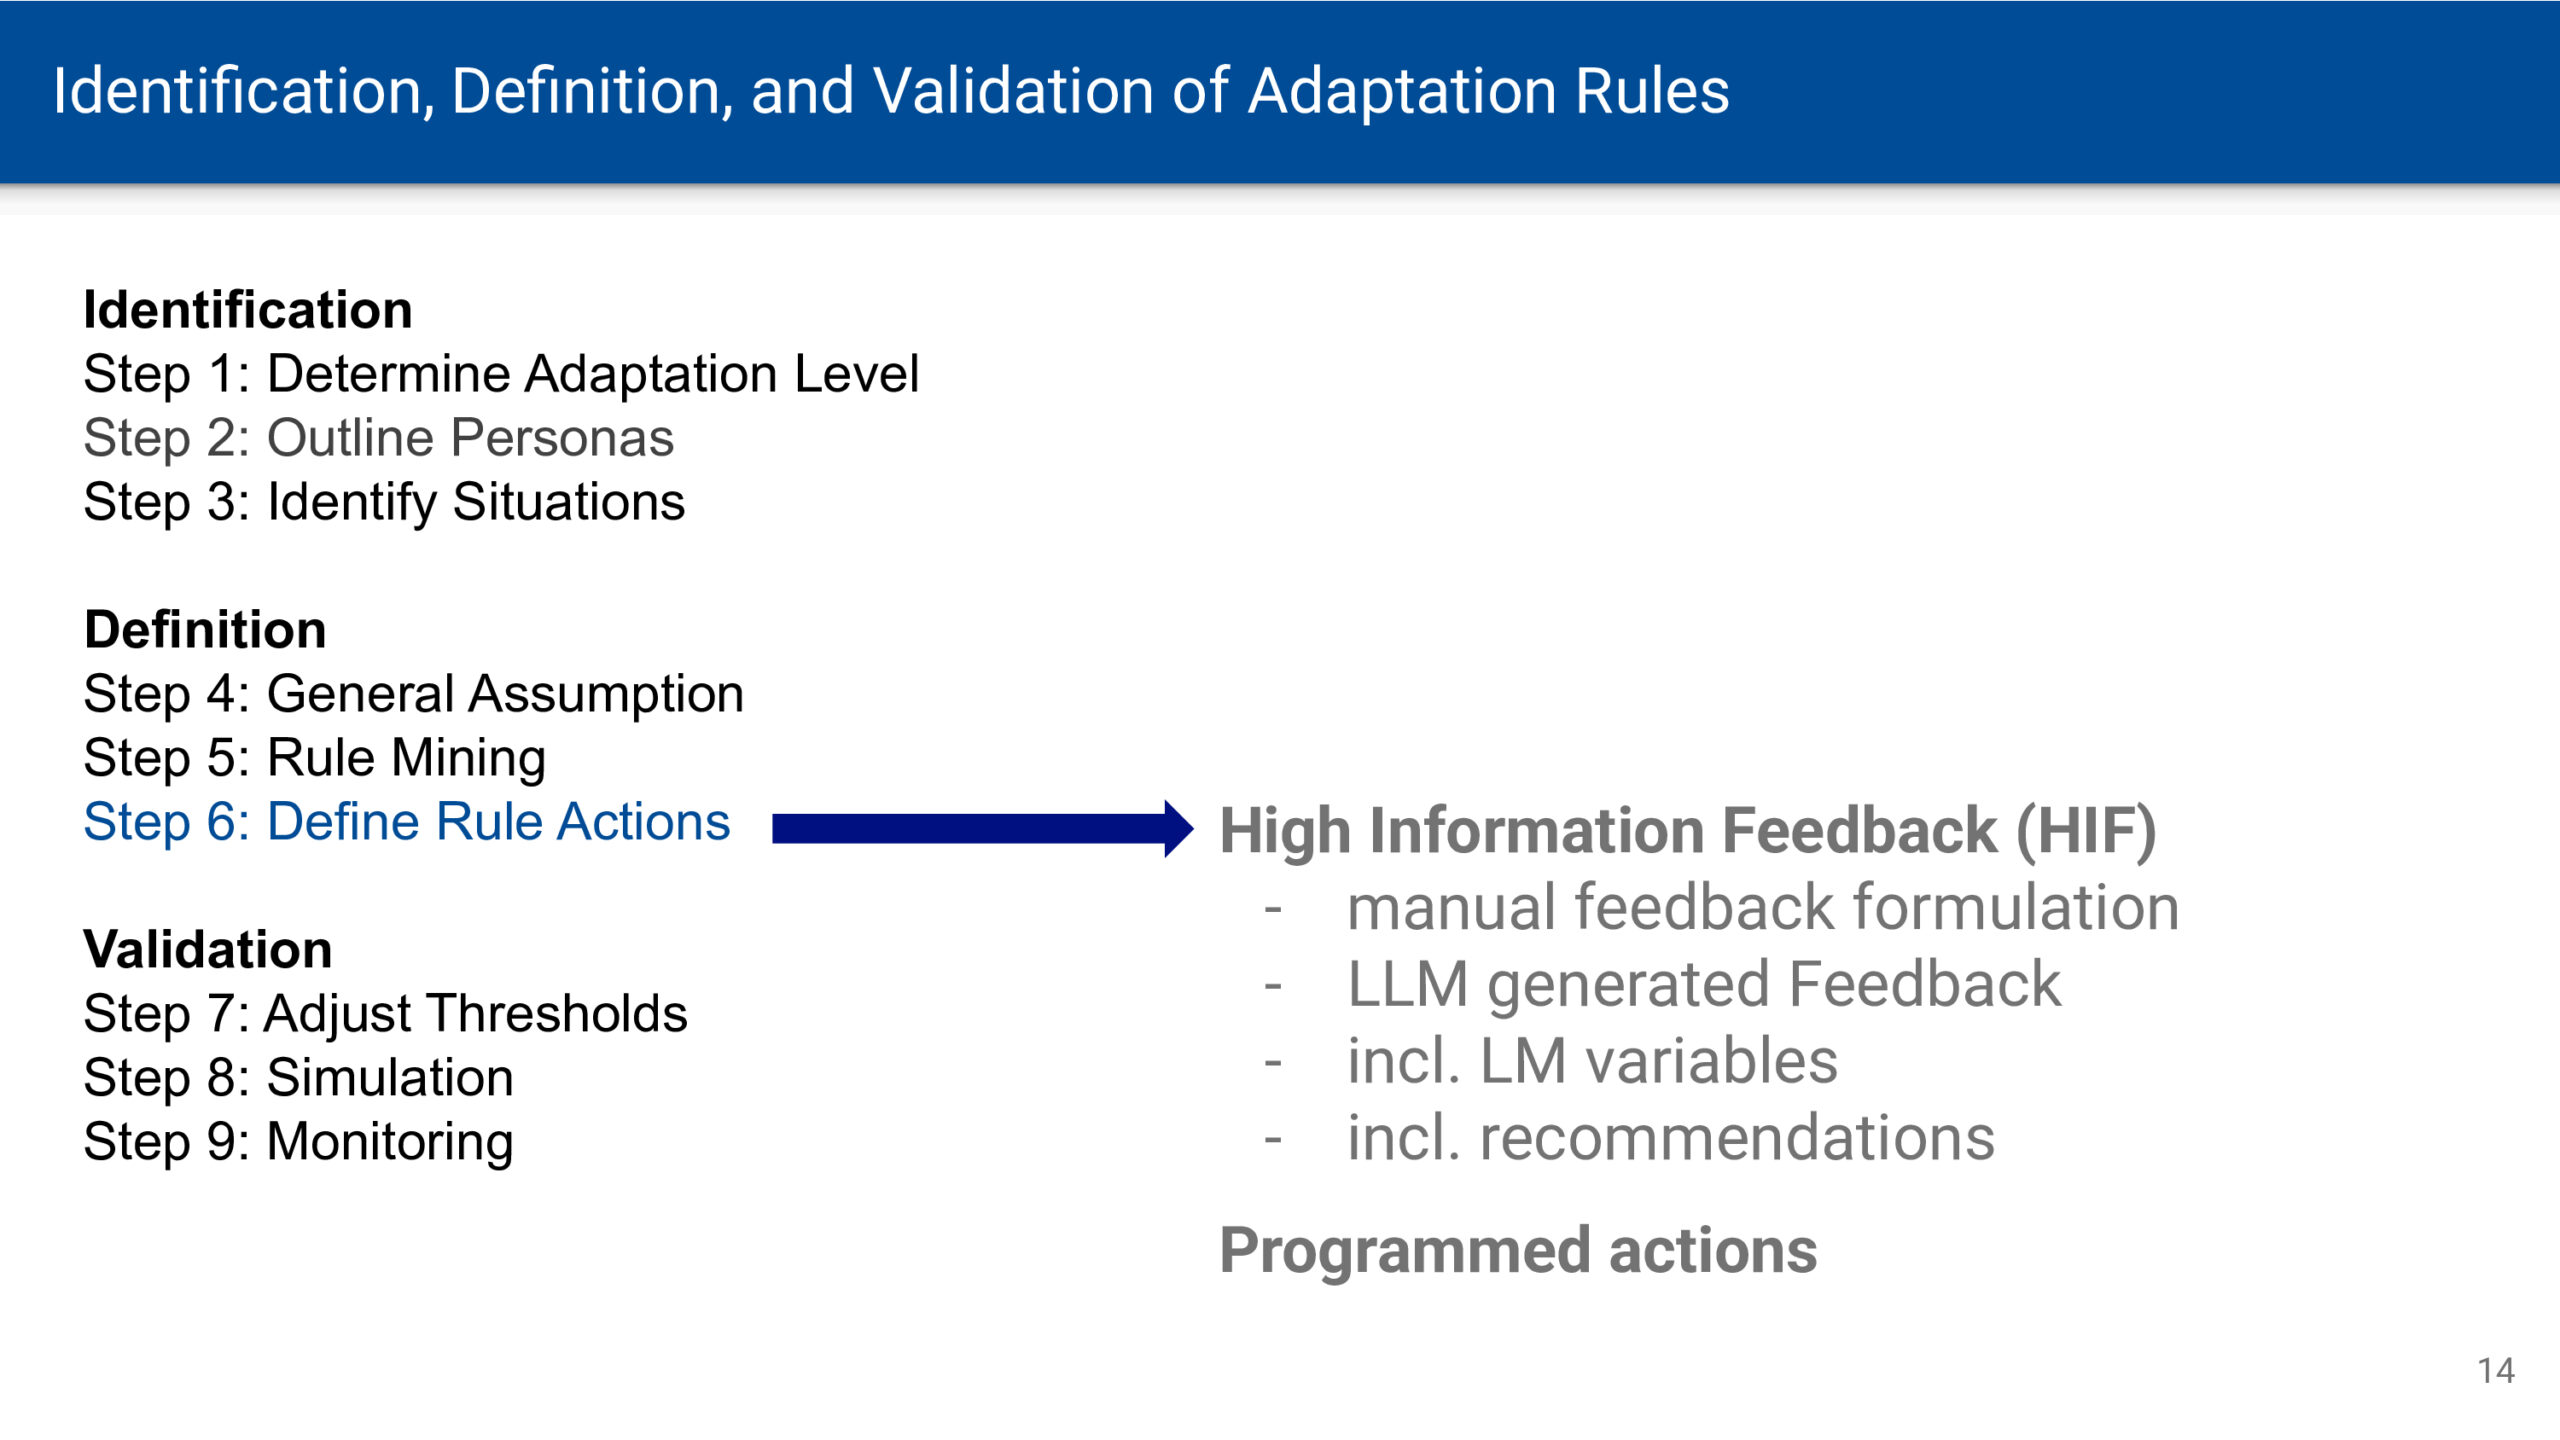
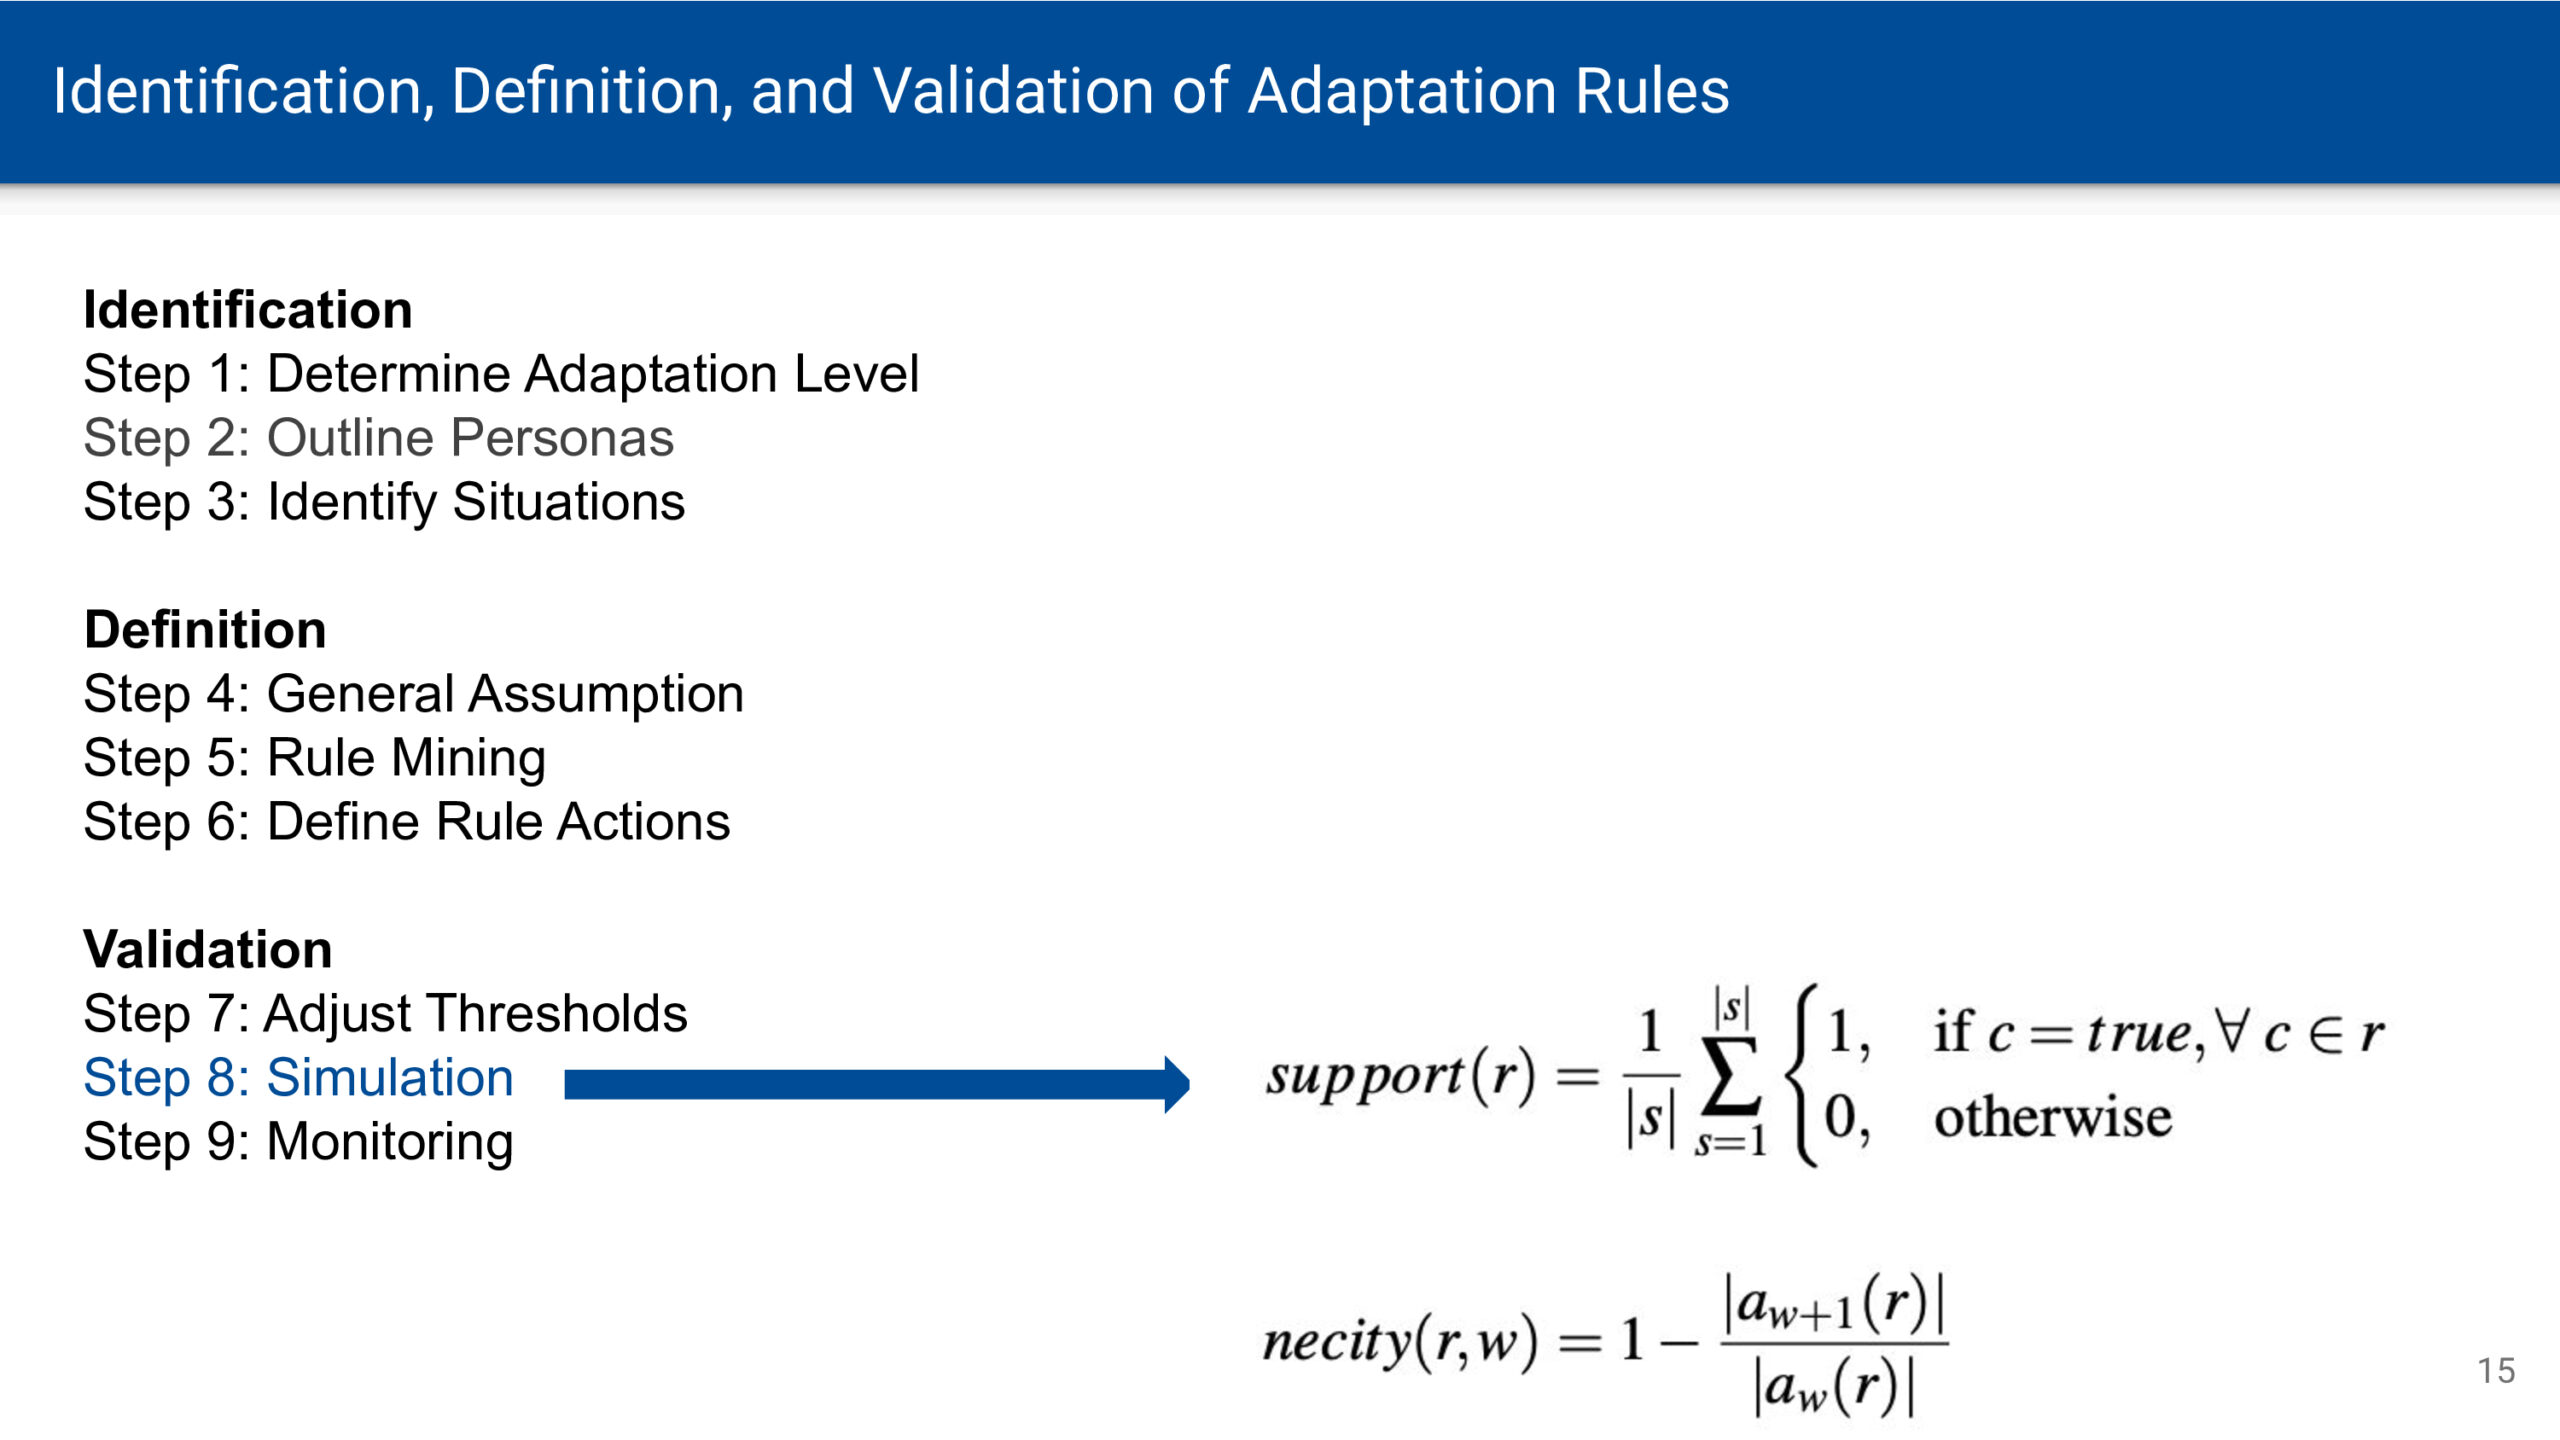
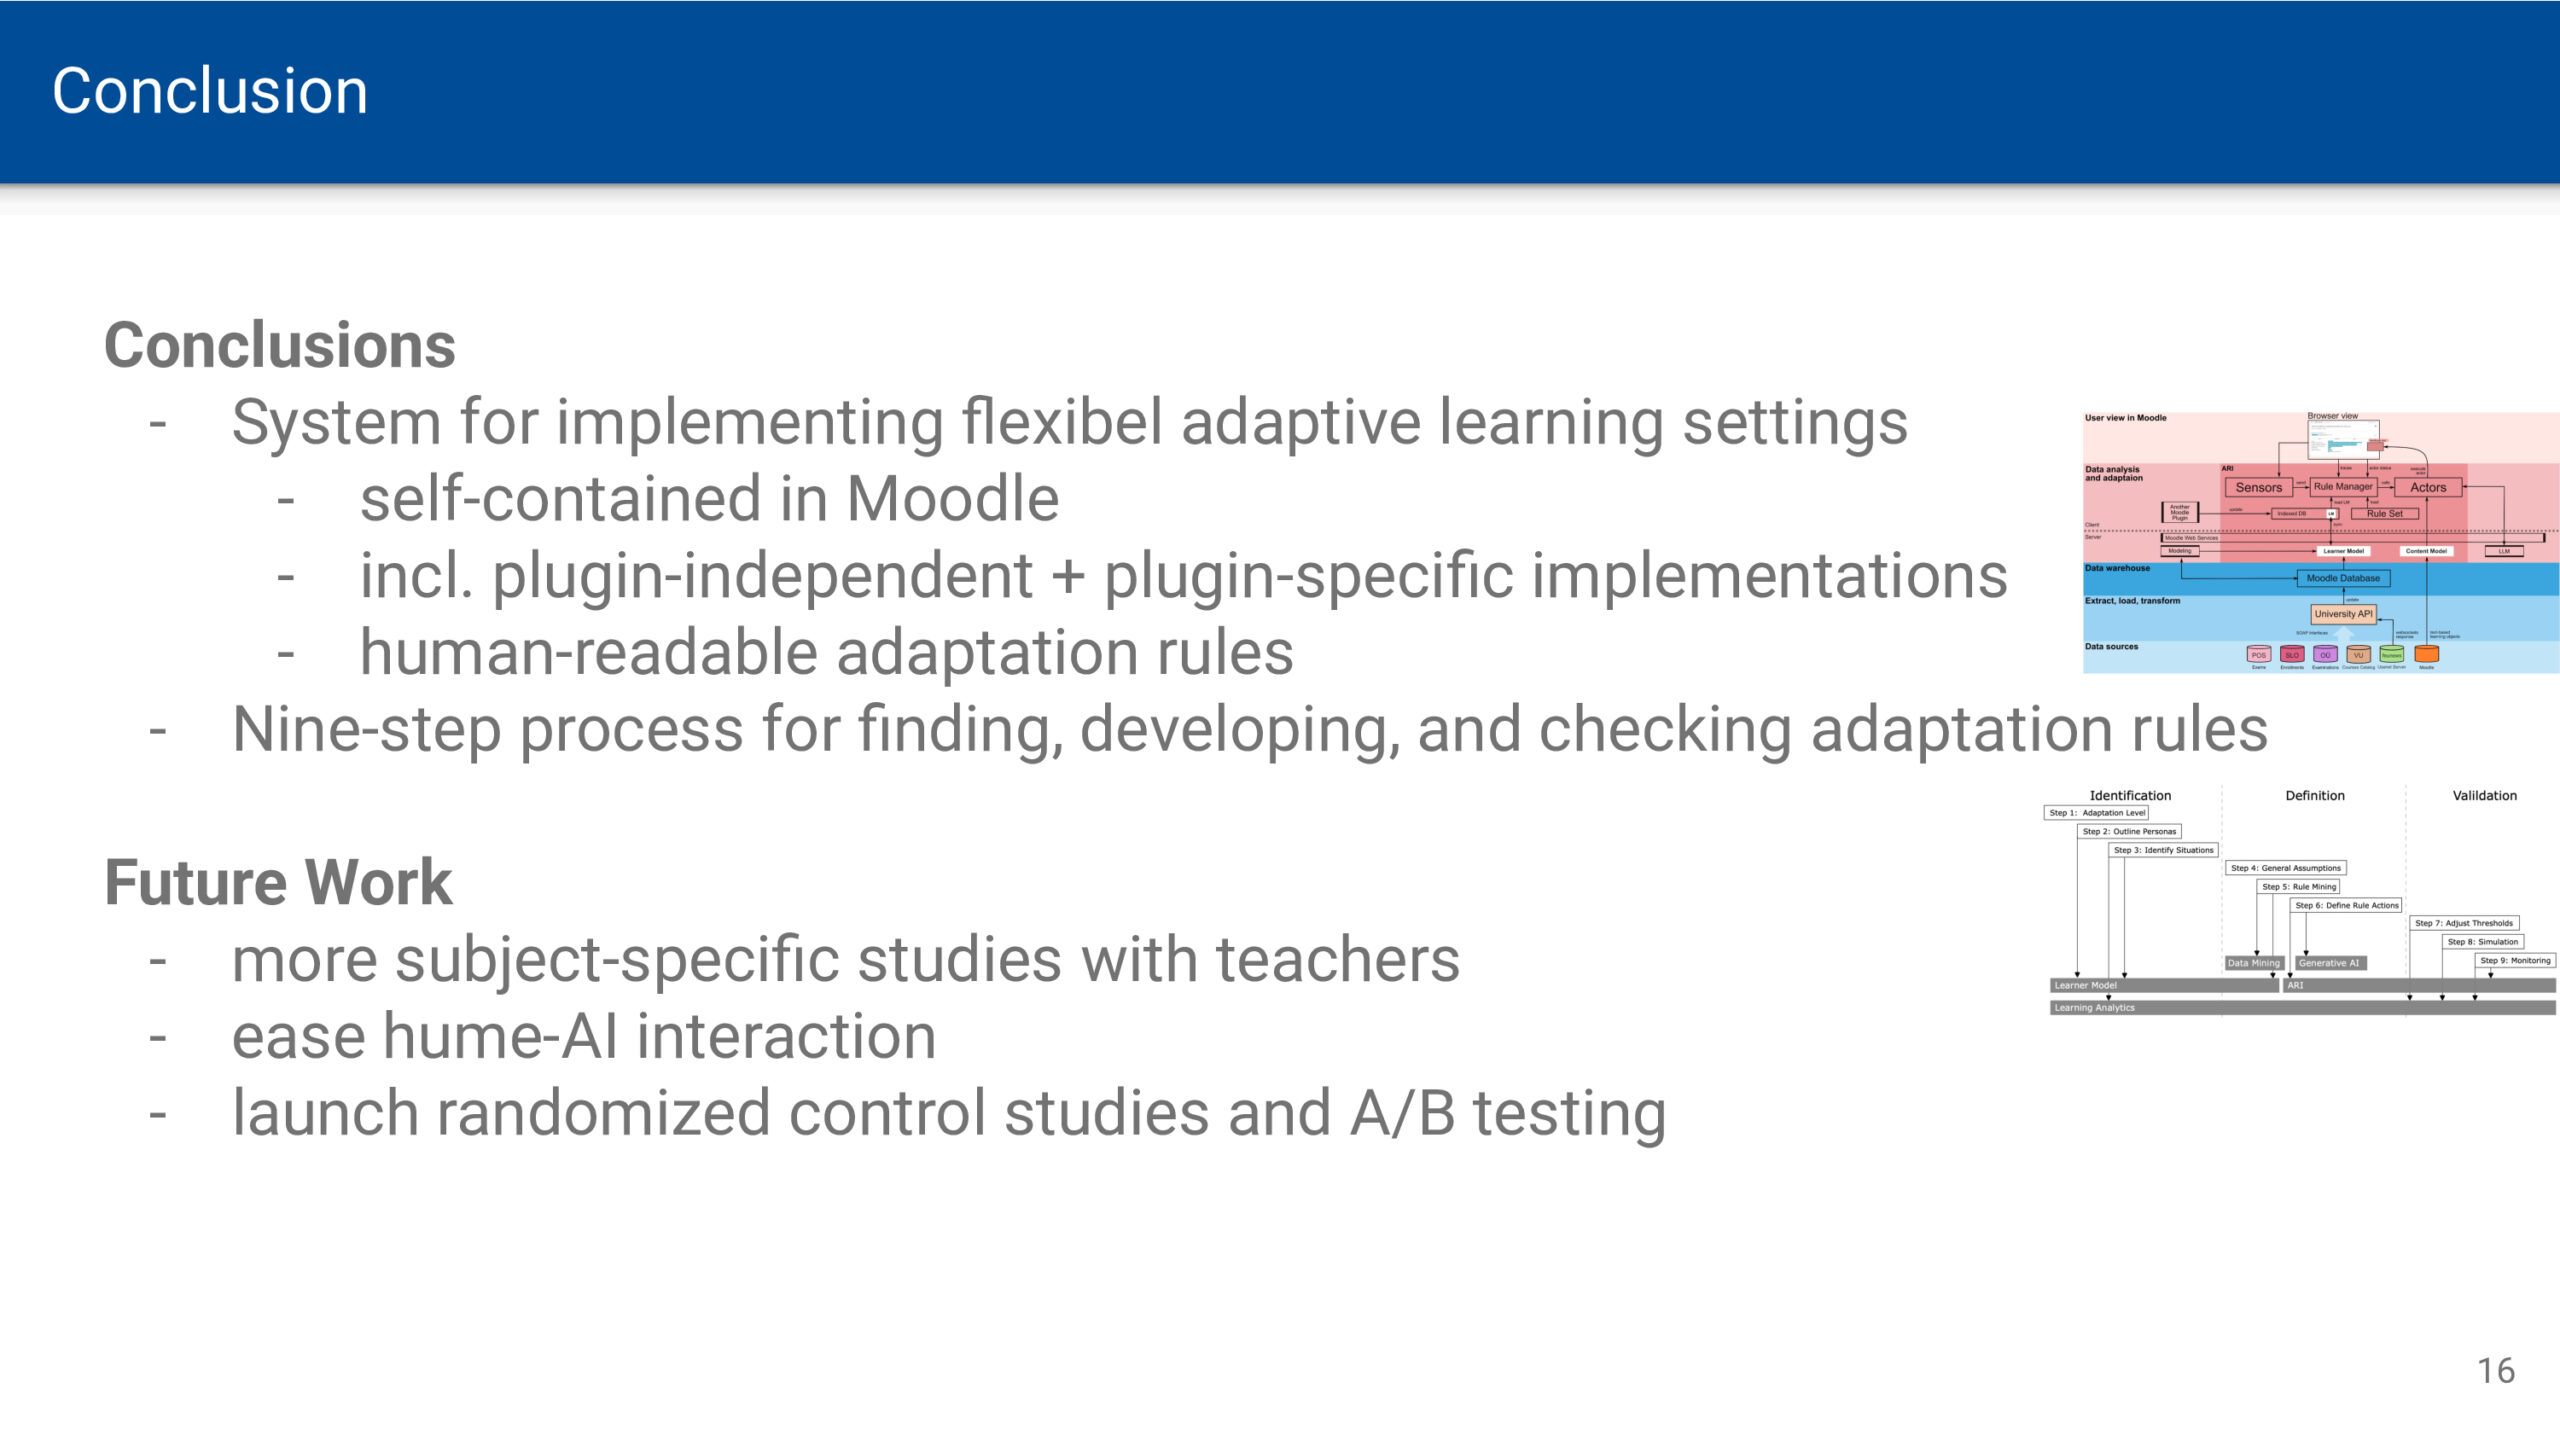
Talk 2: Architecture for Gradually AI-teamed Adaptation Rules in Learning Management Systems (Niels Seidel)

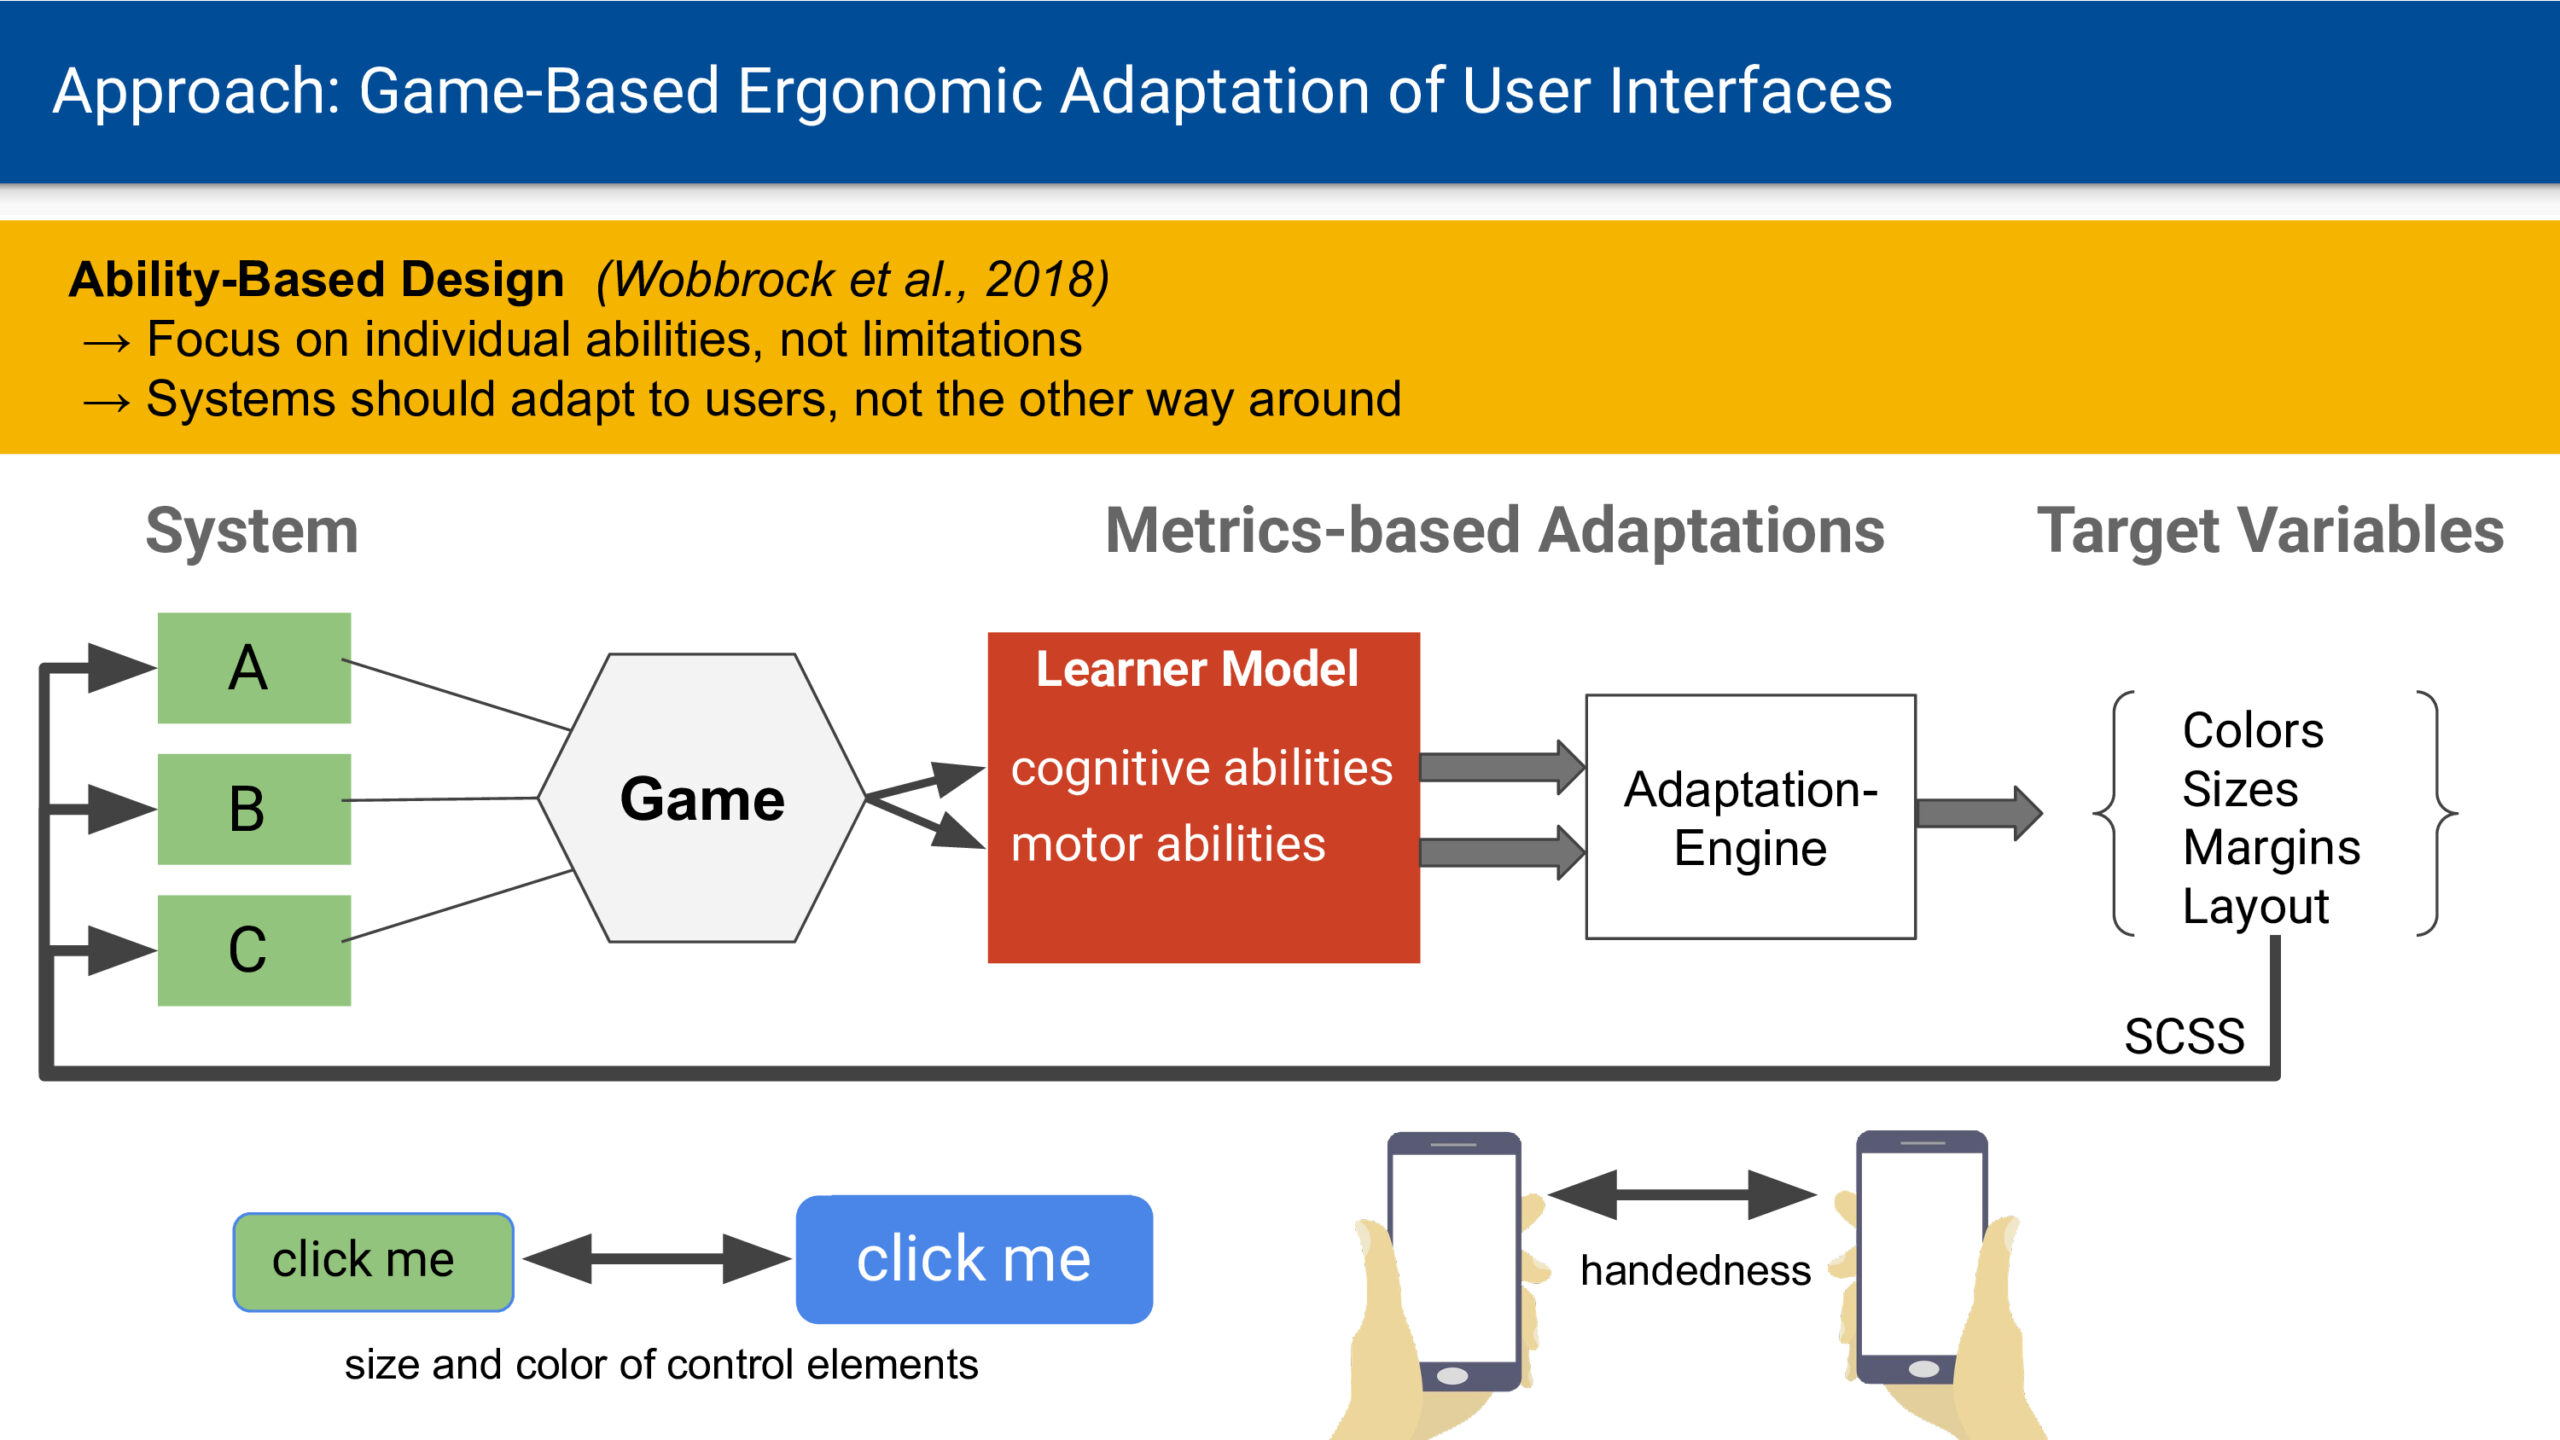
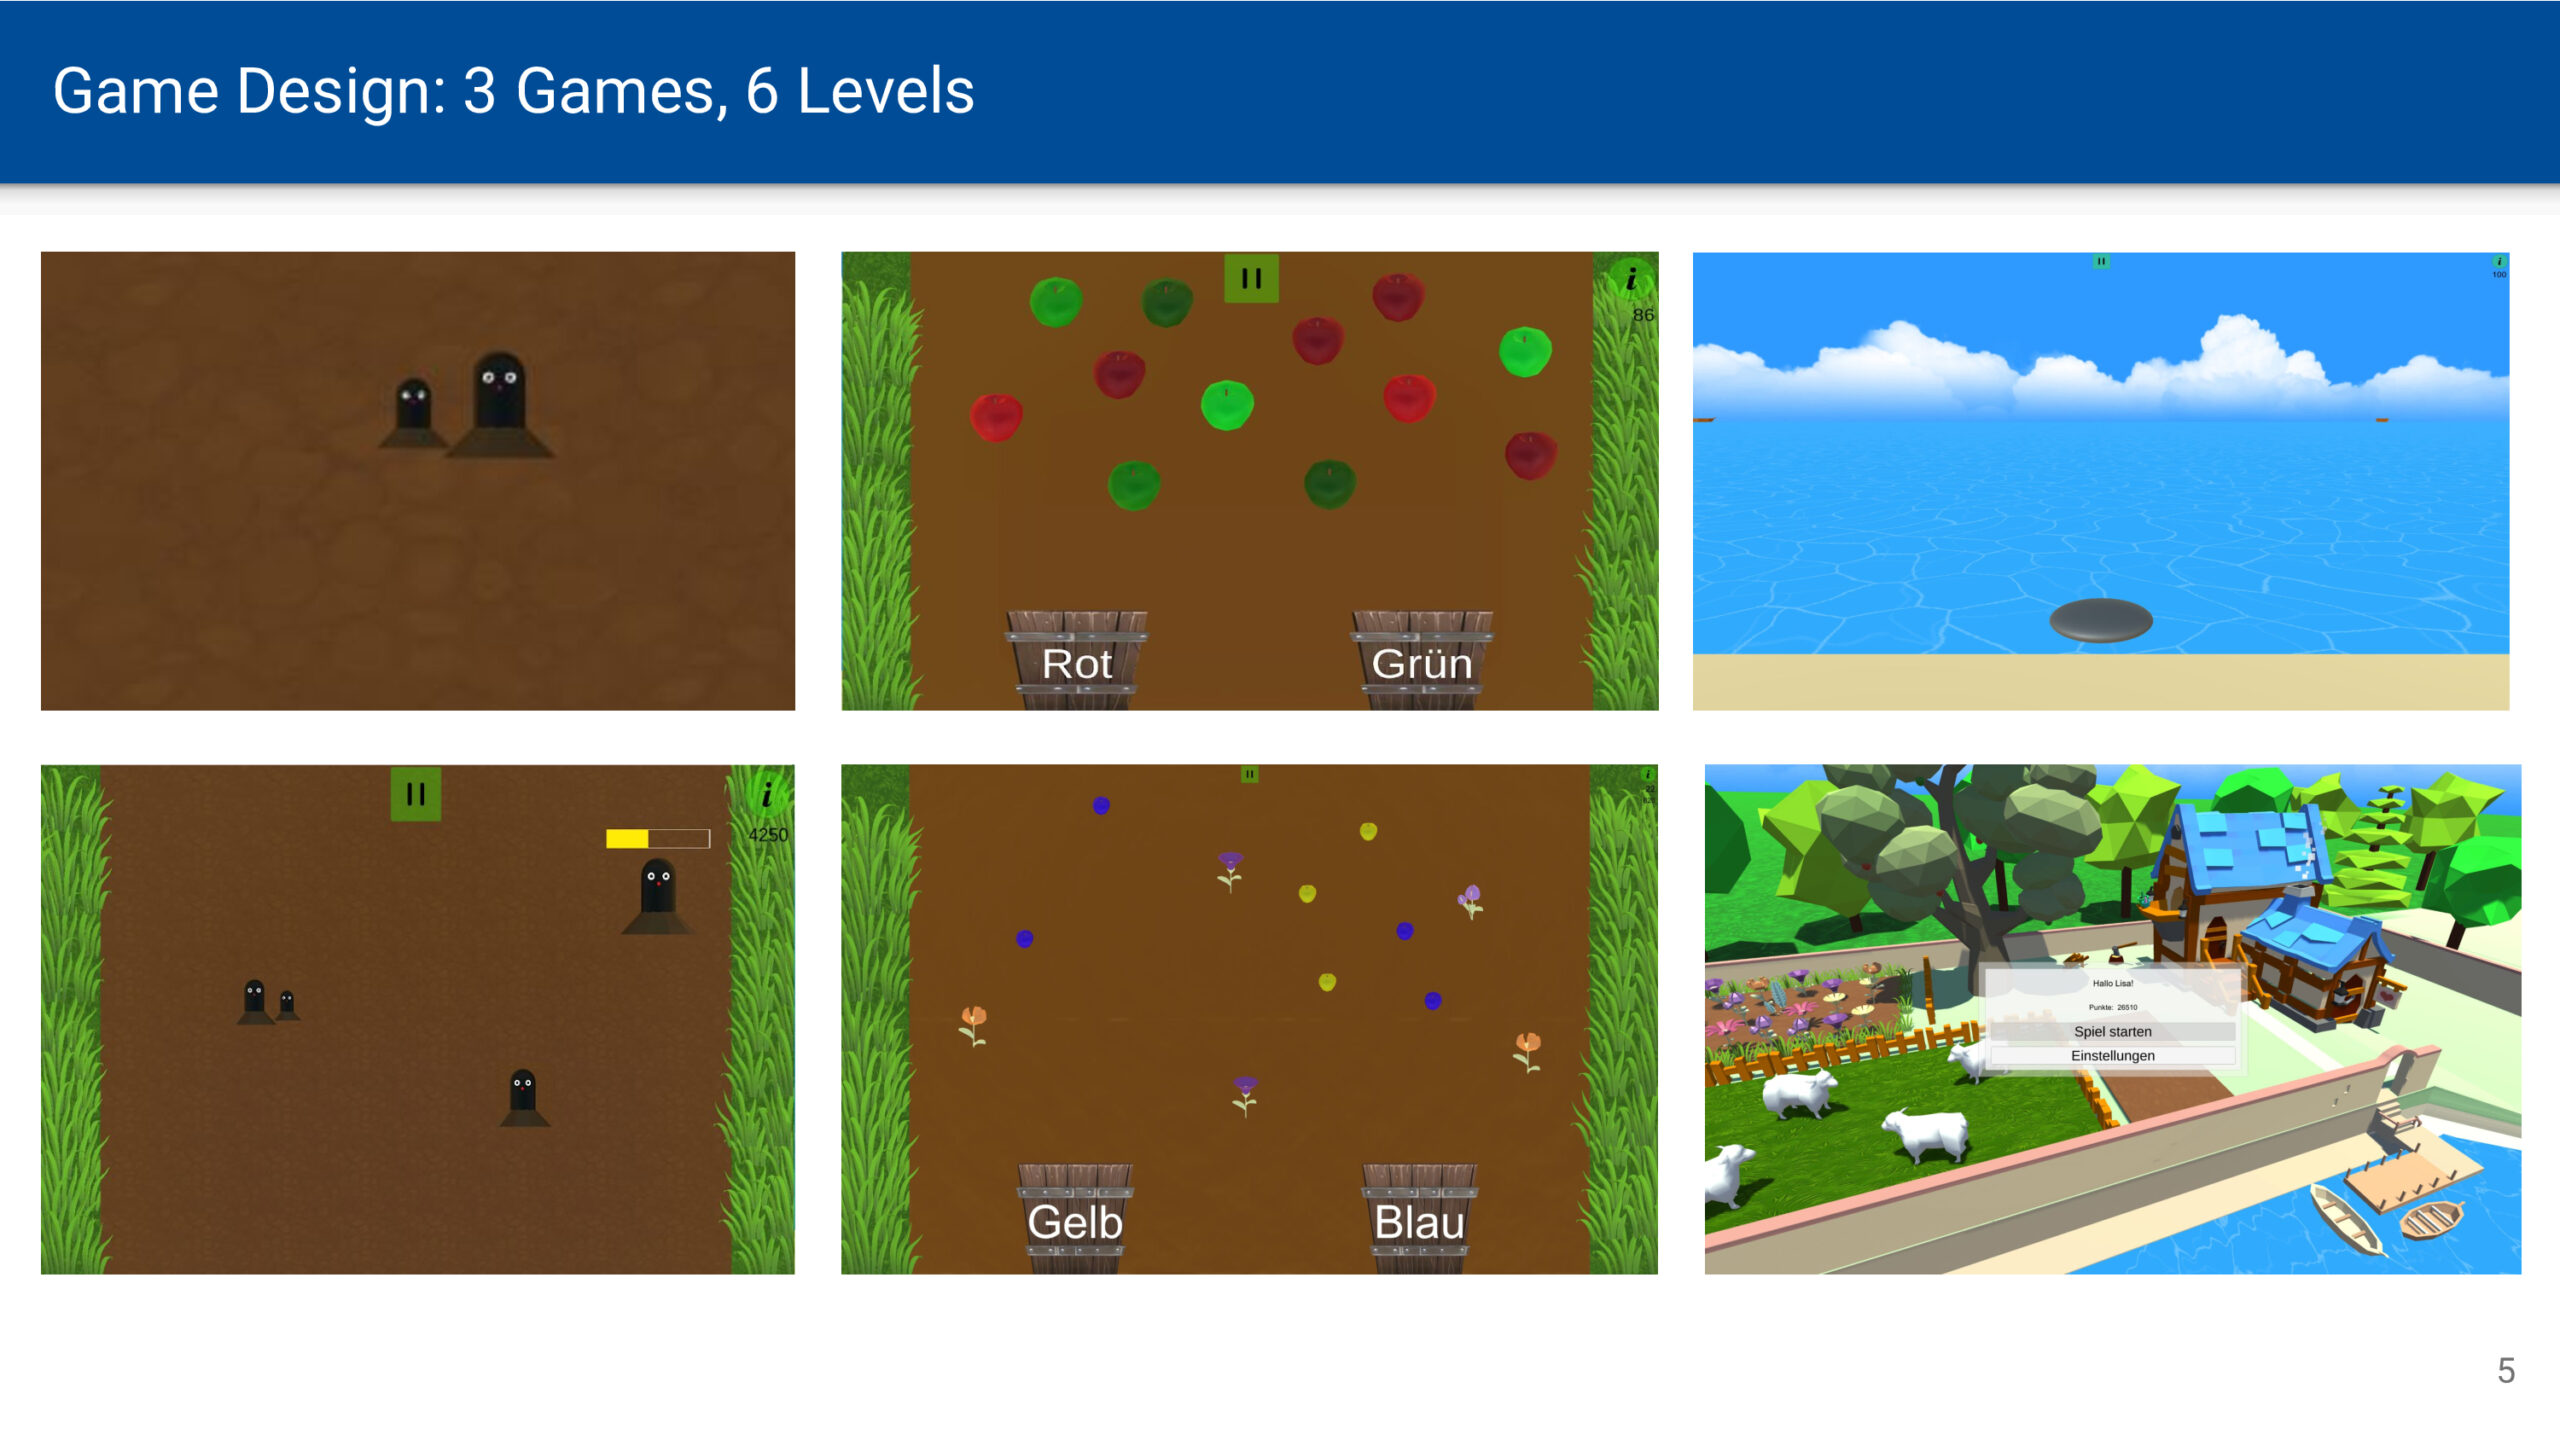
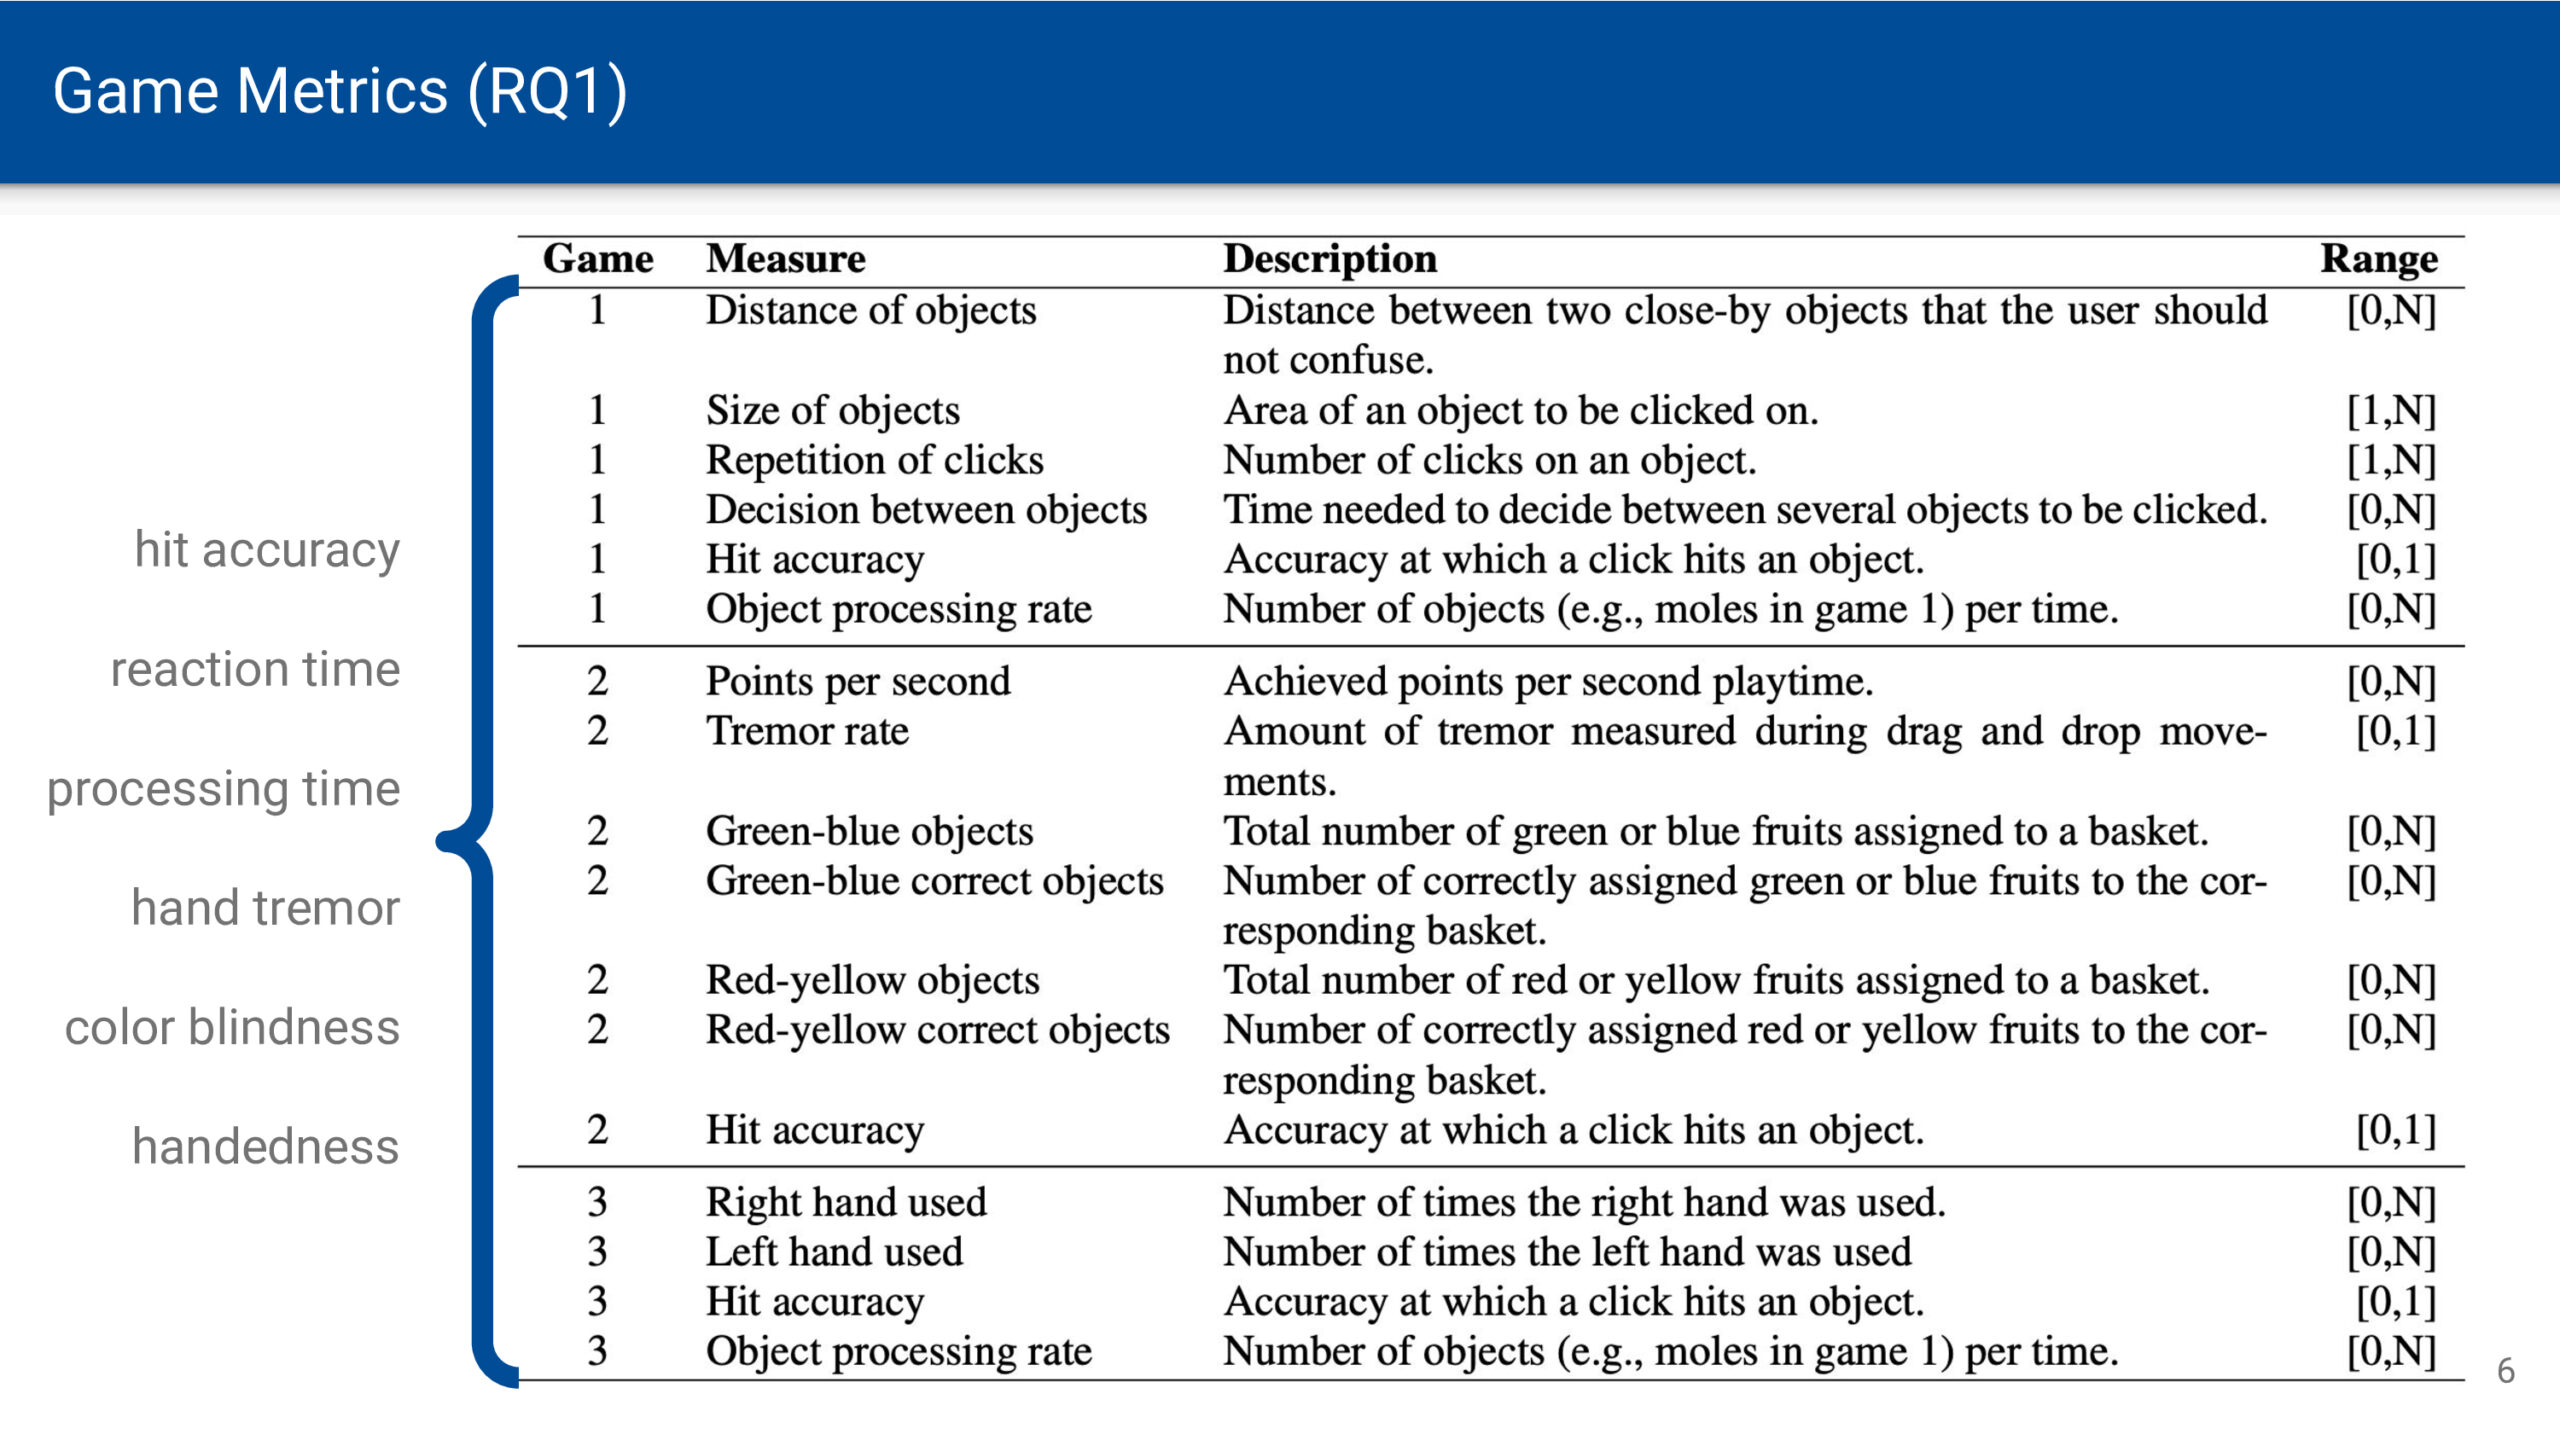
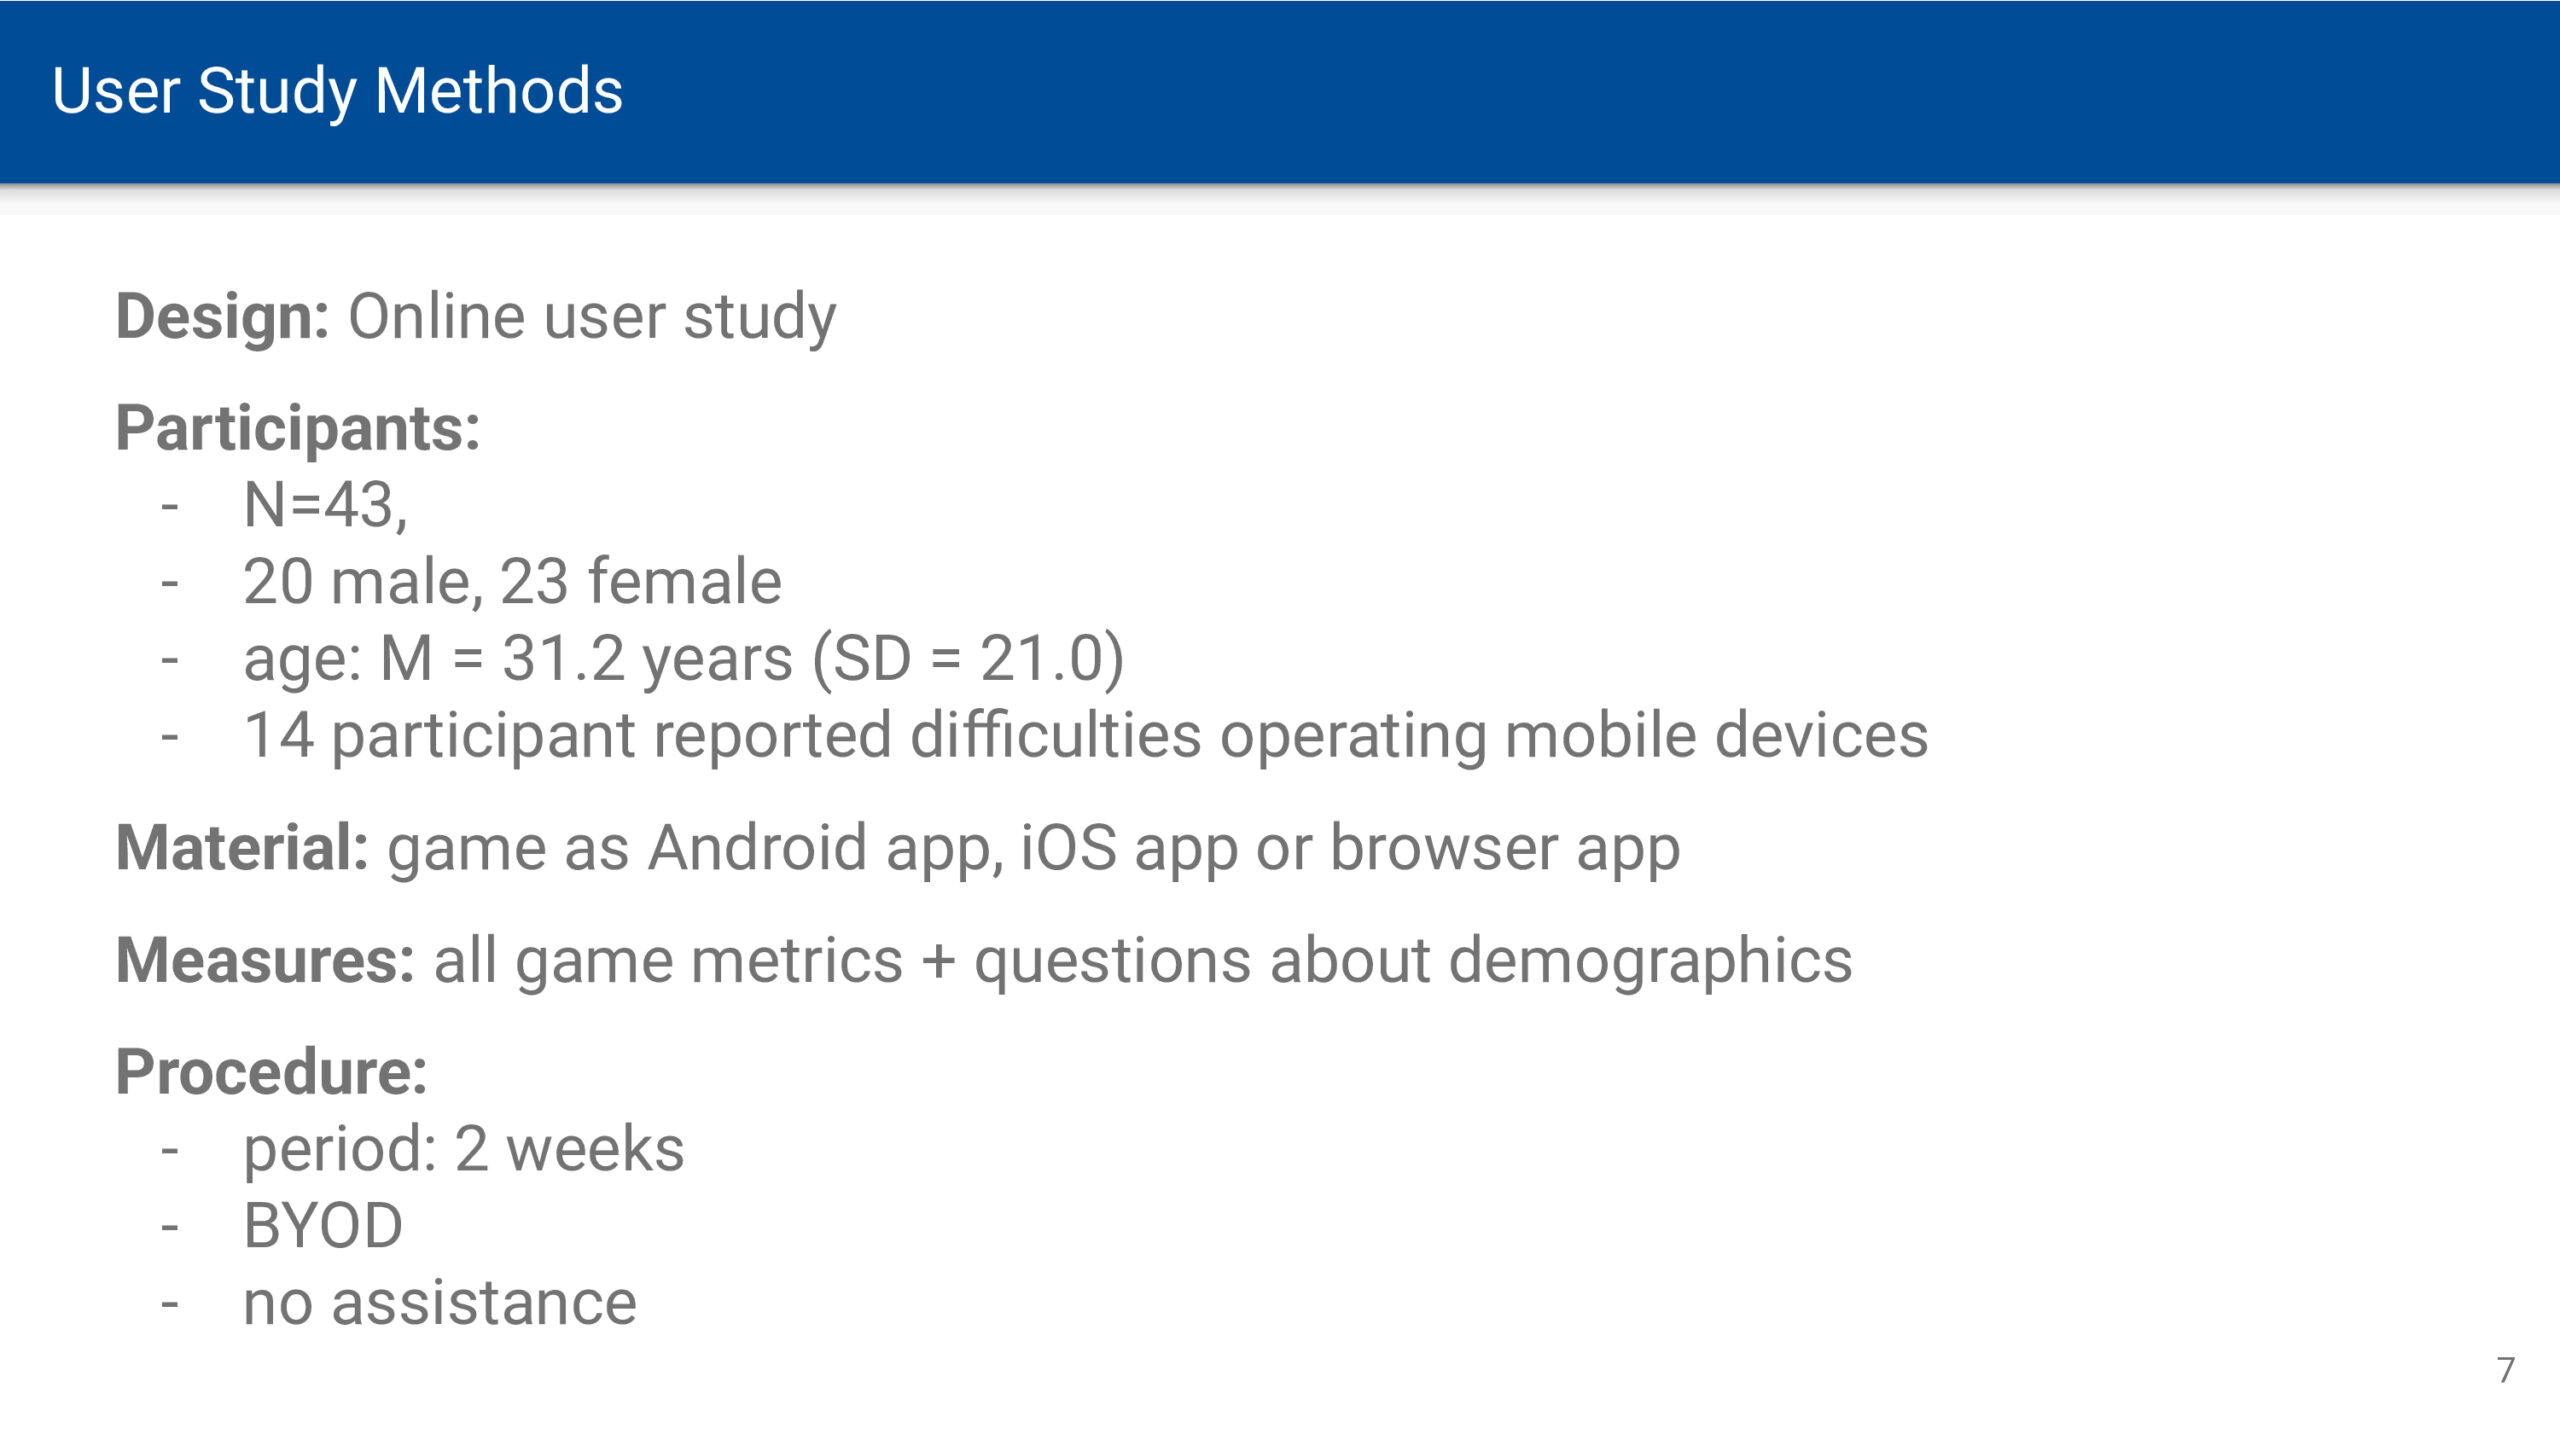
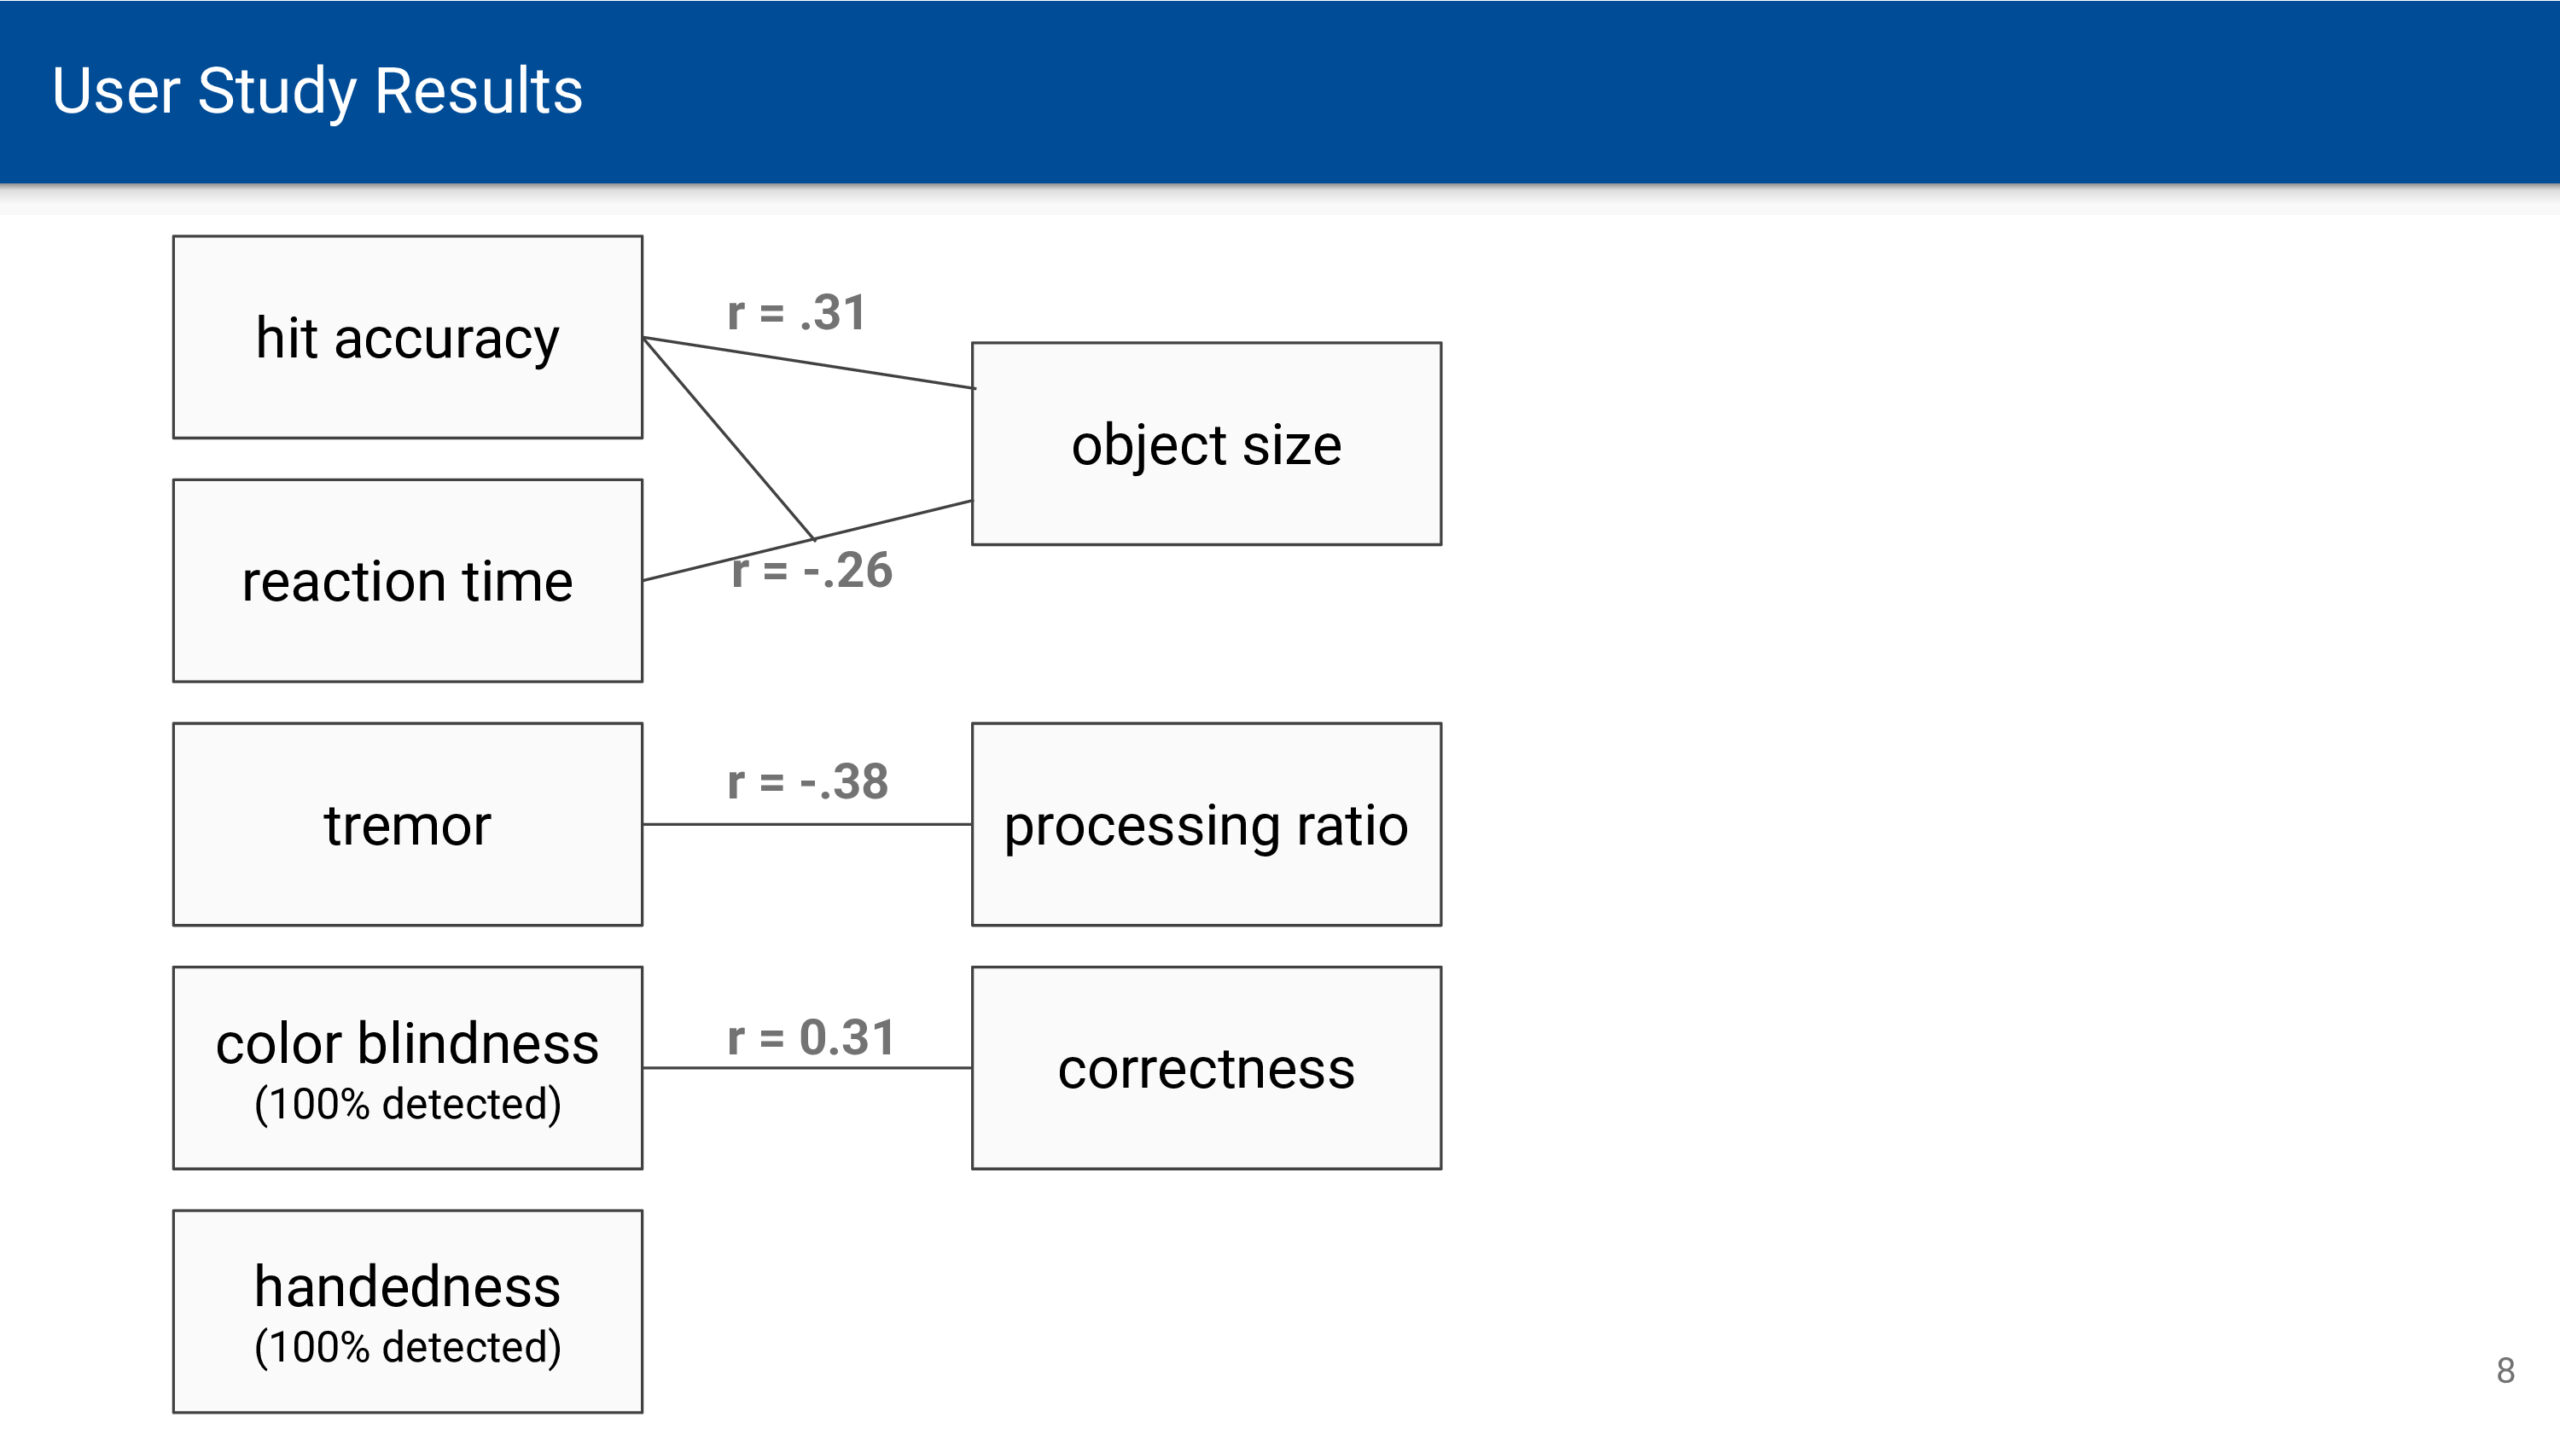
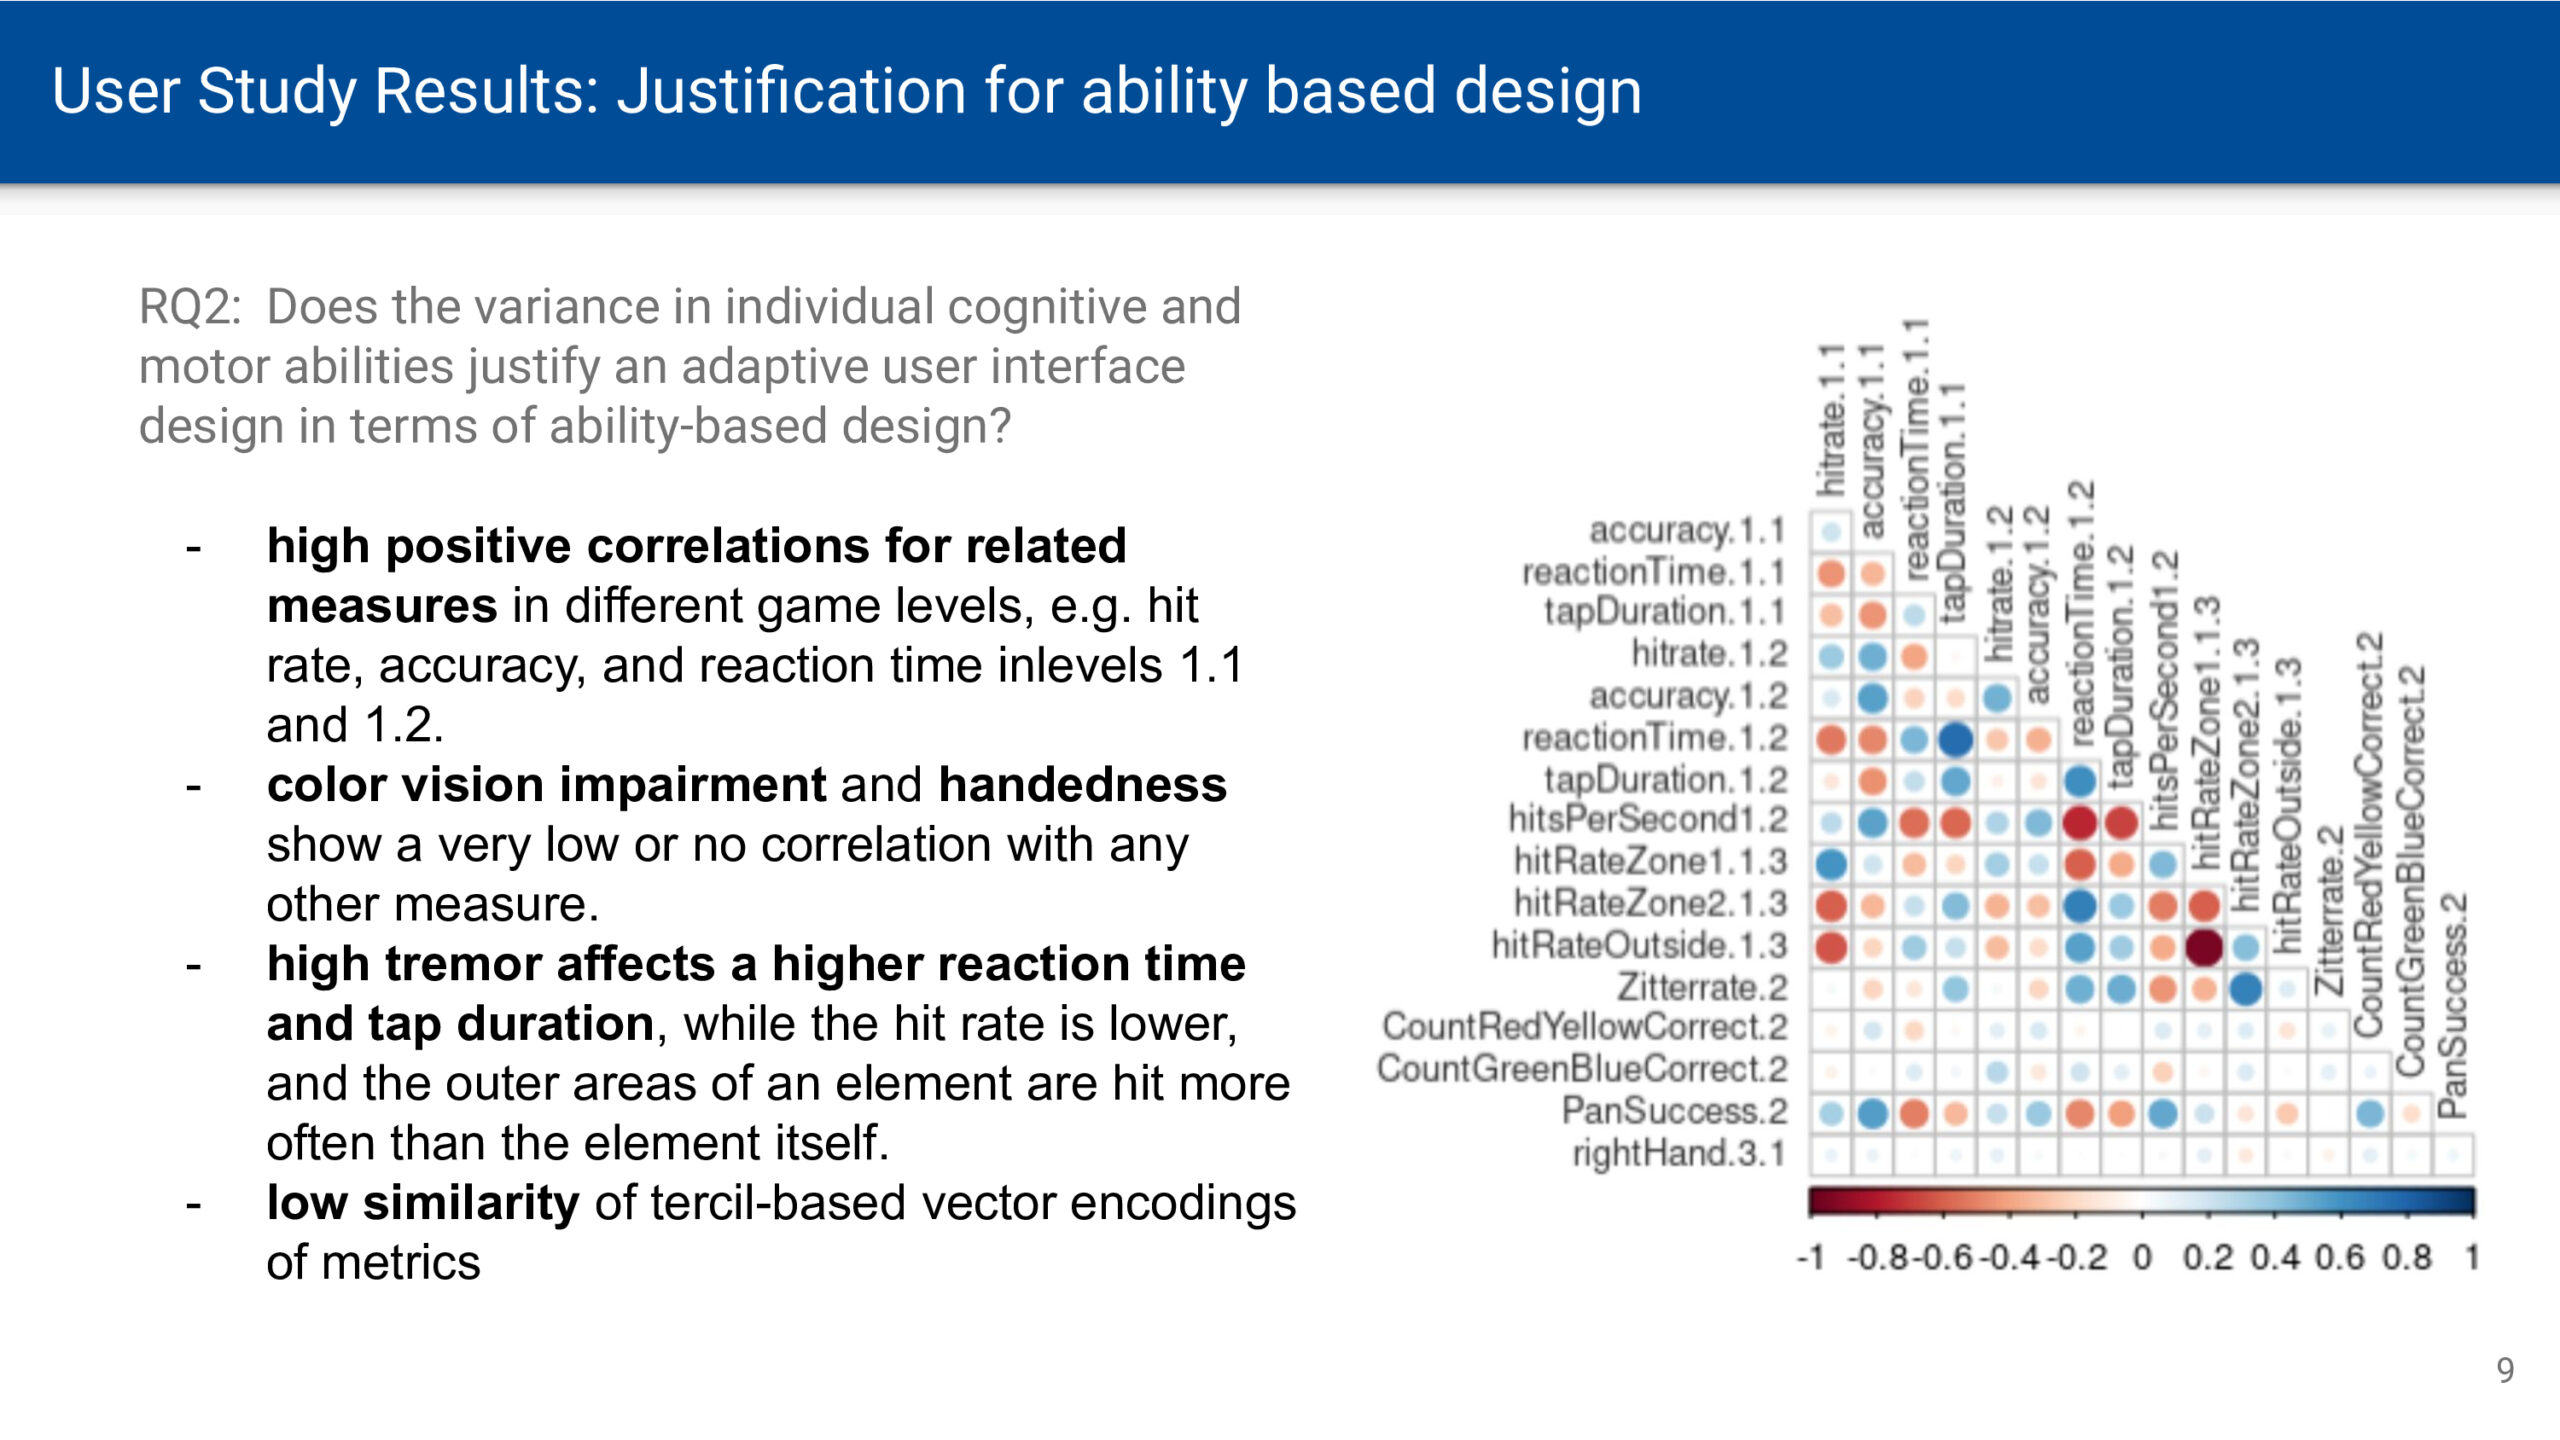
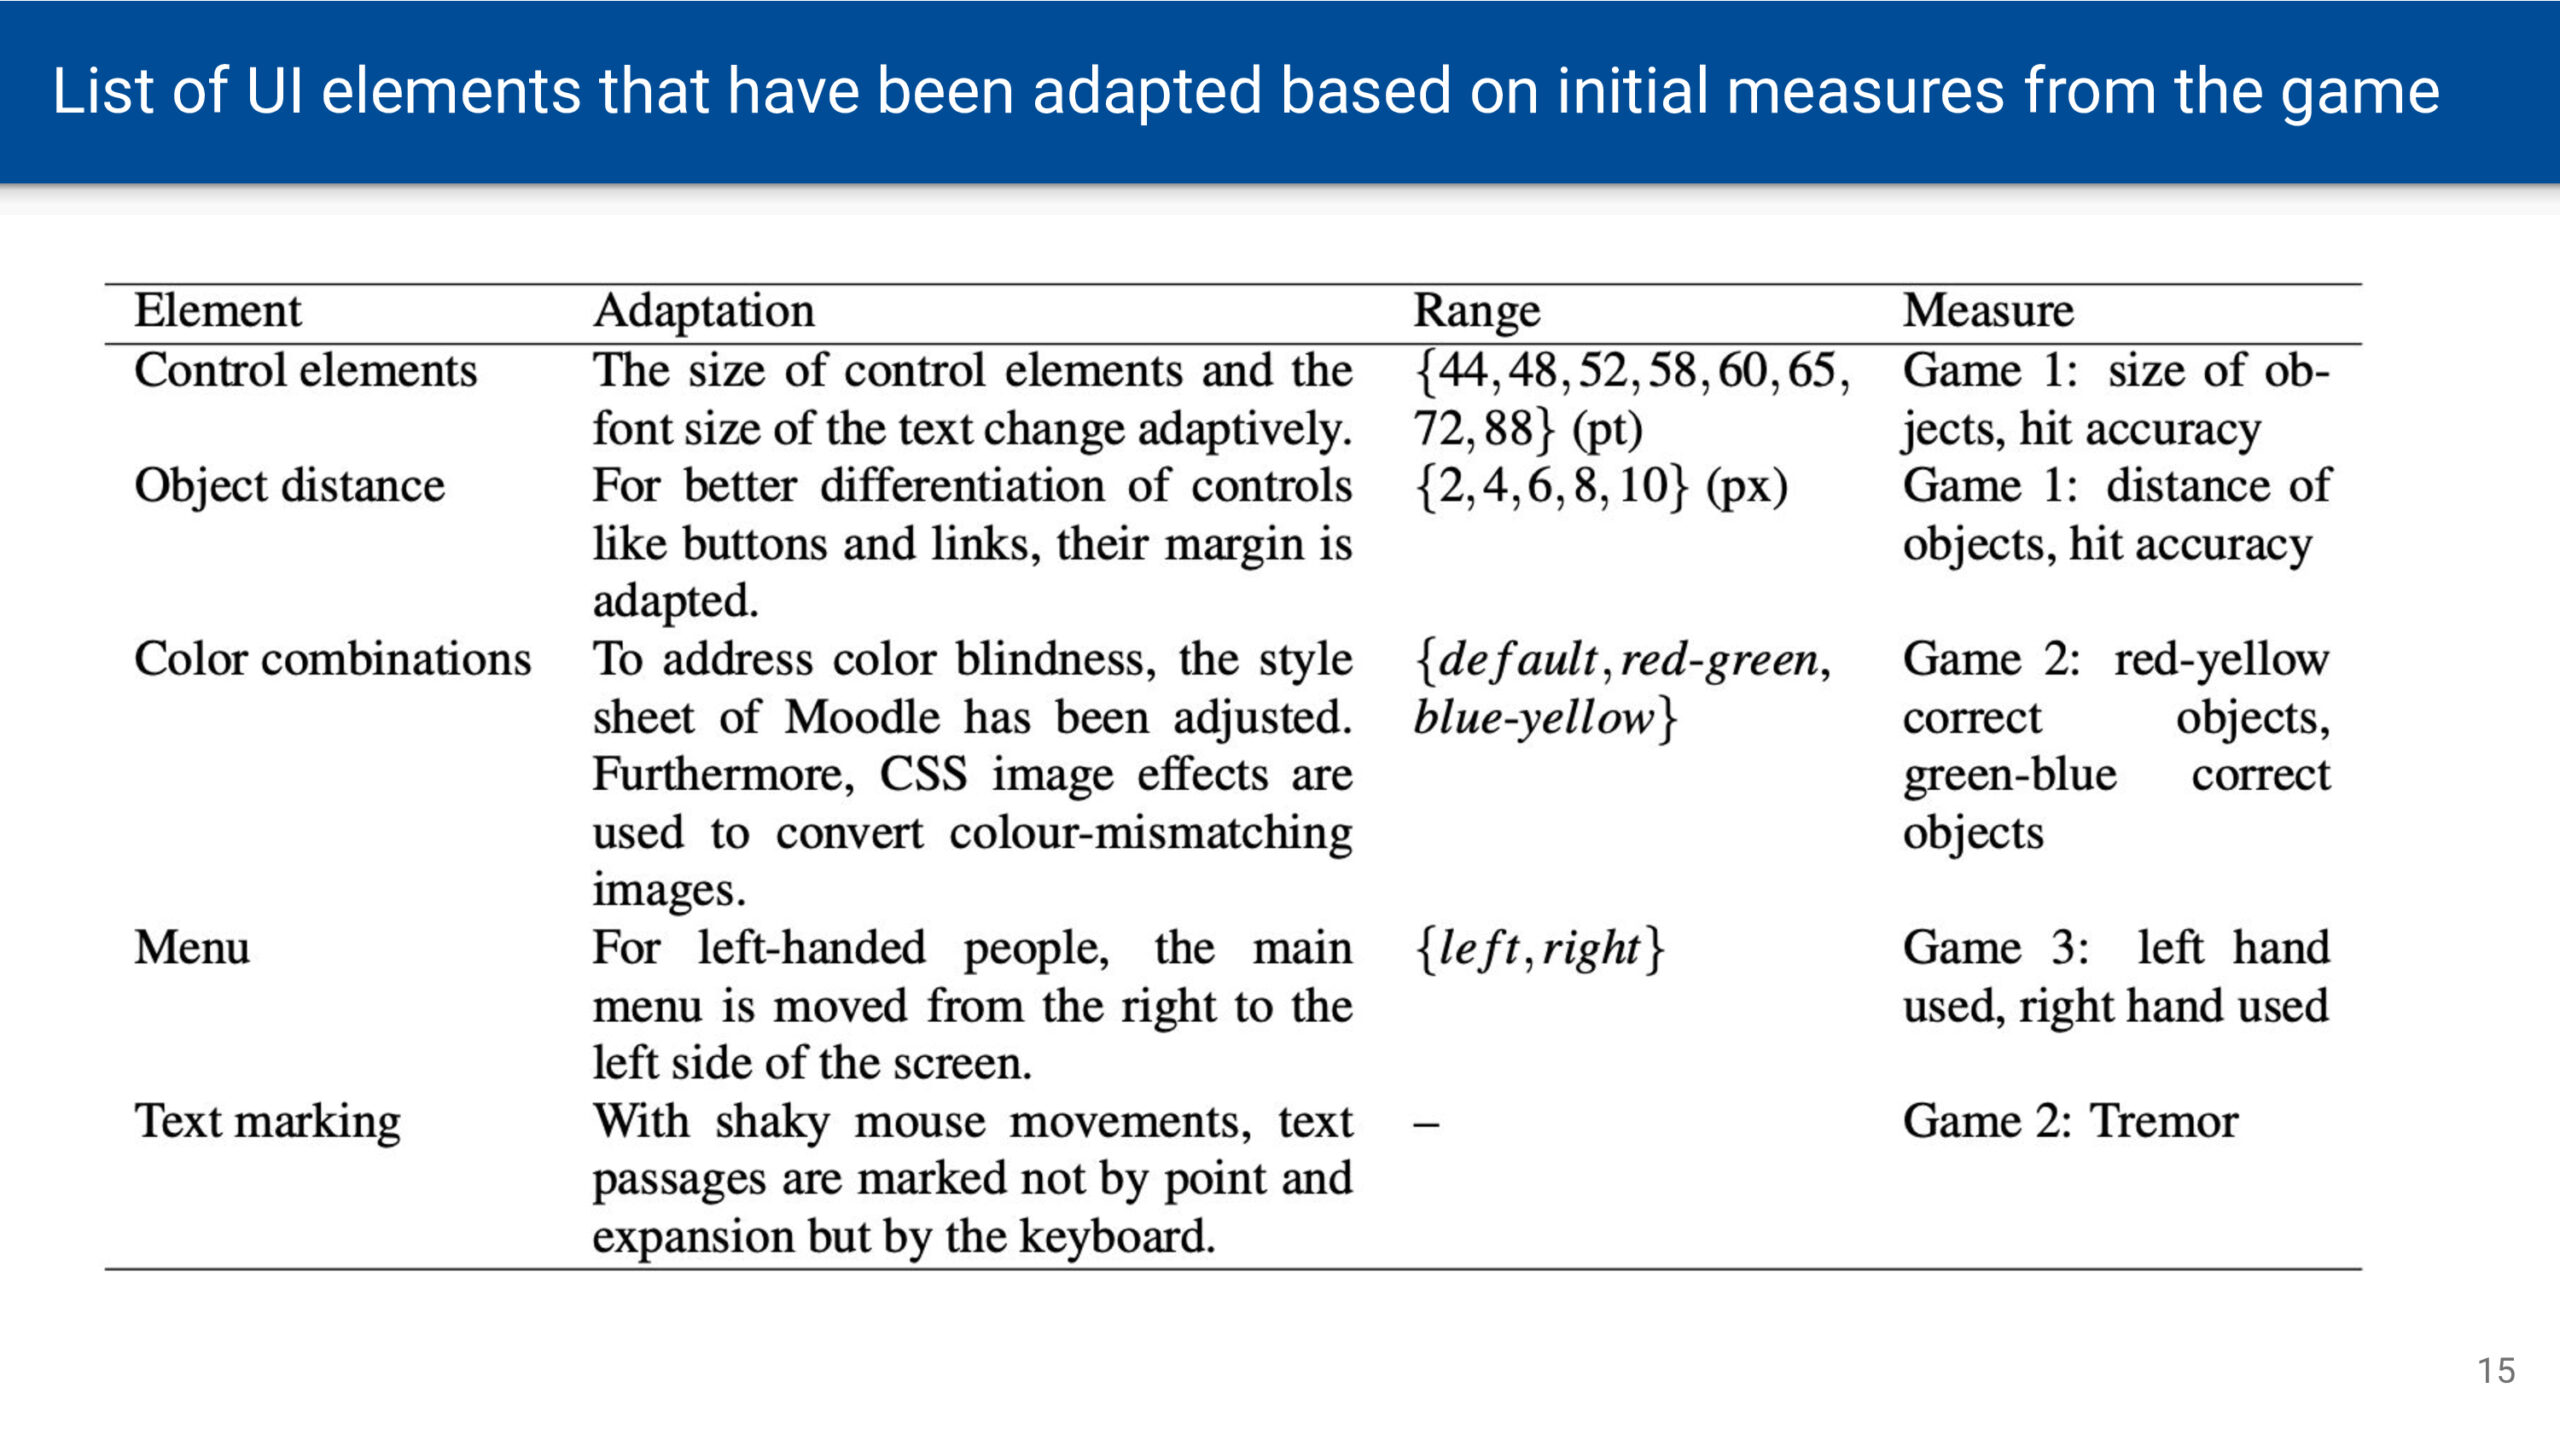
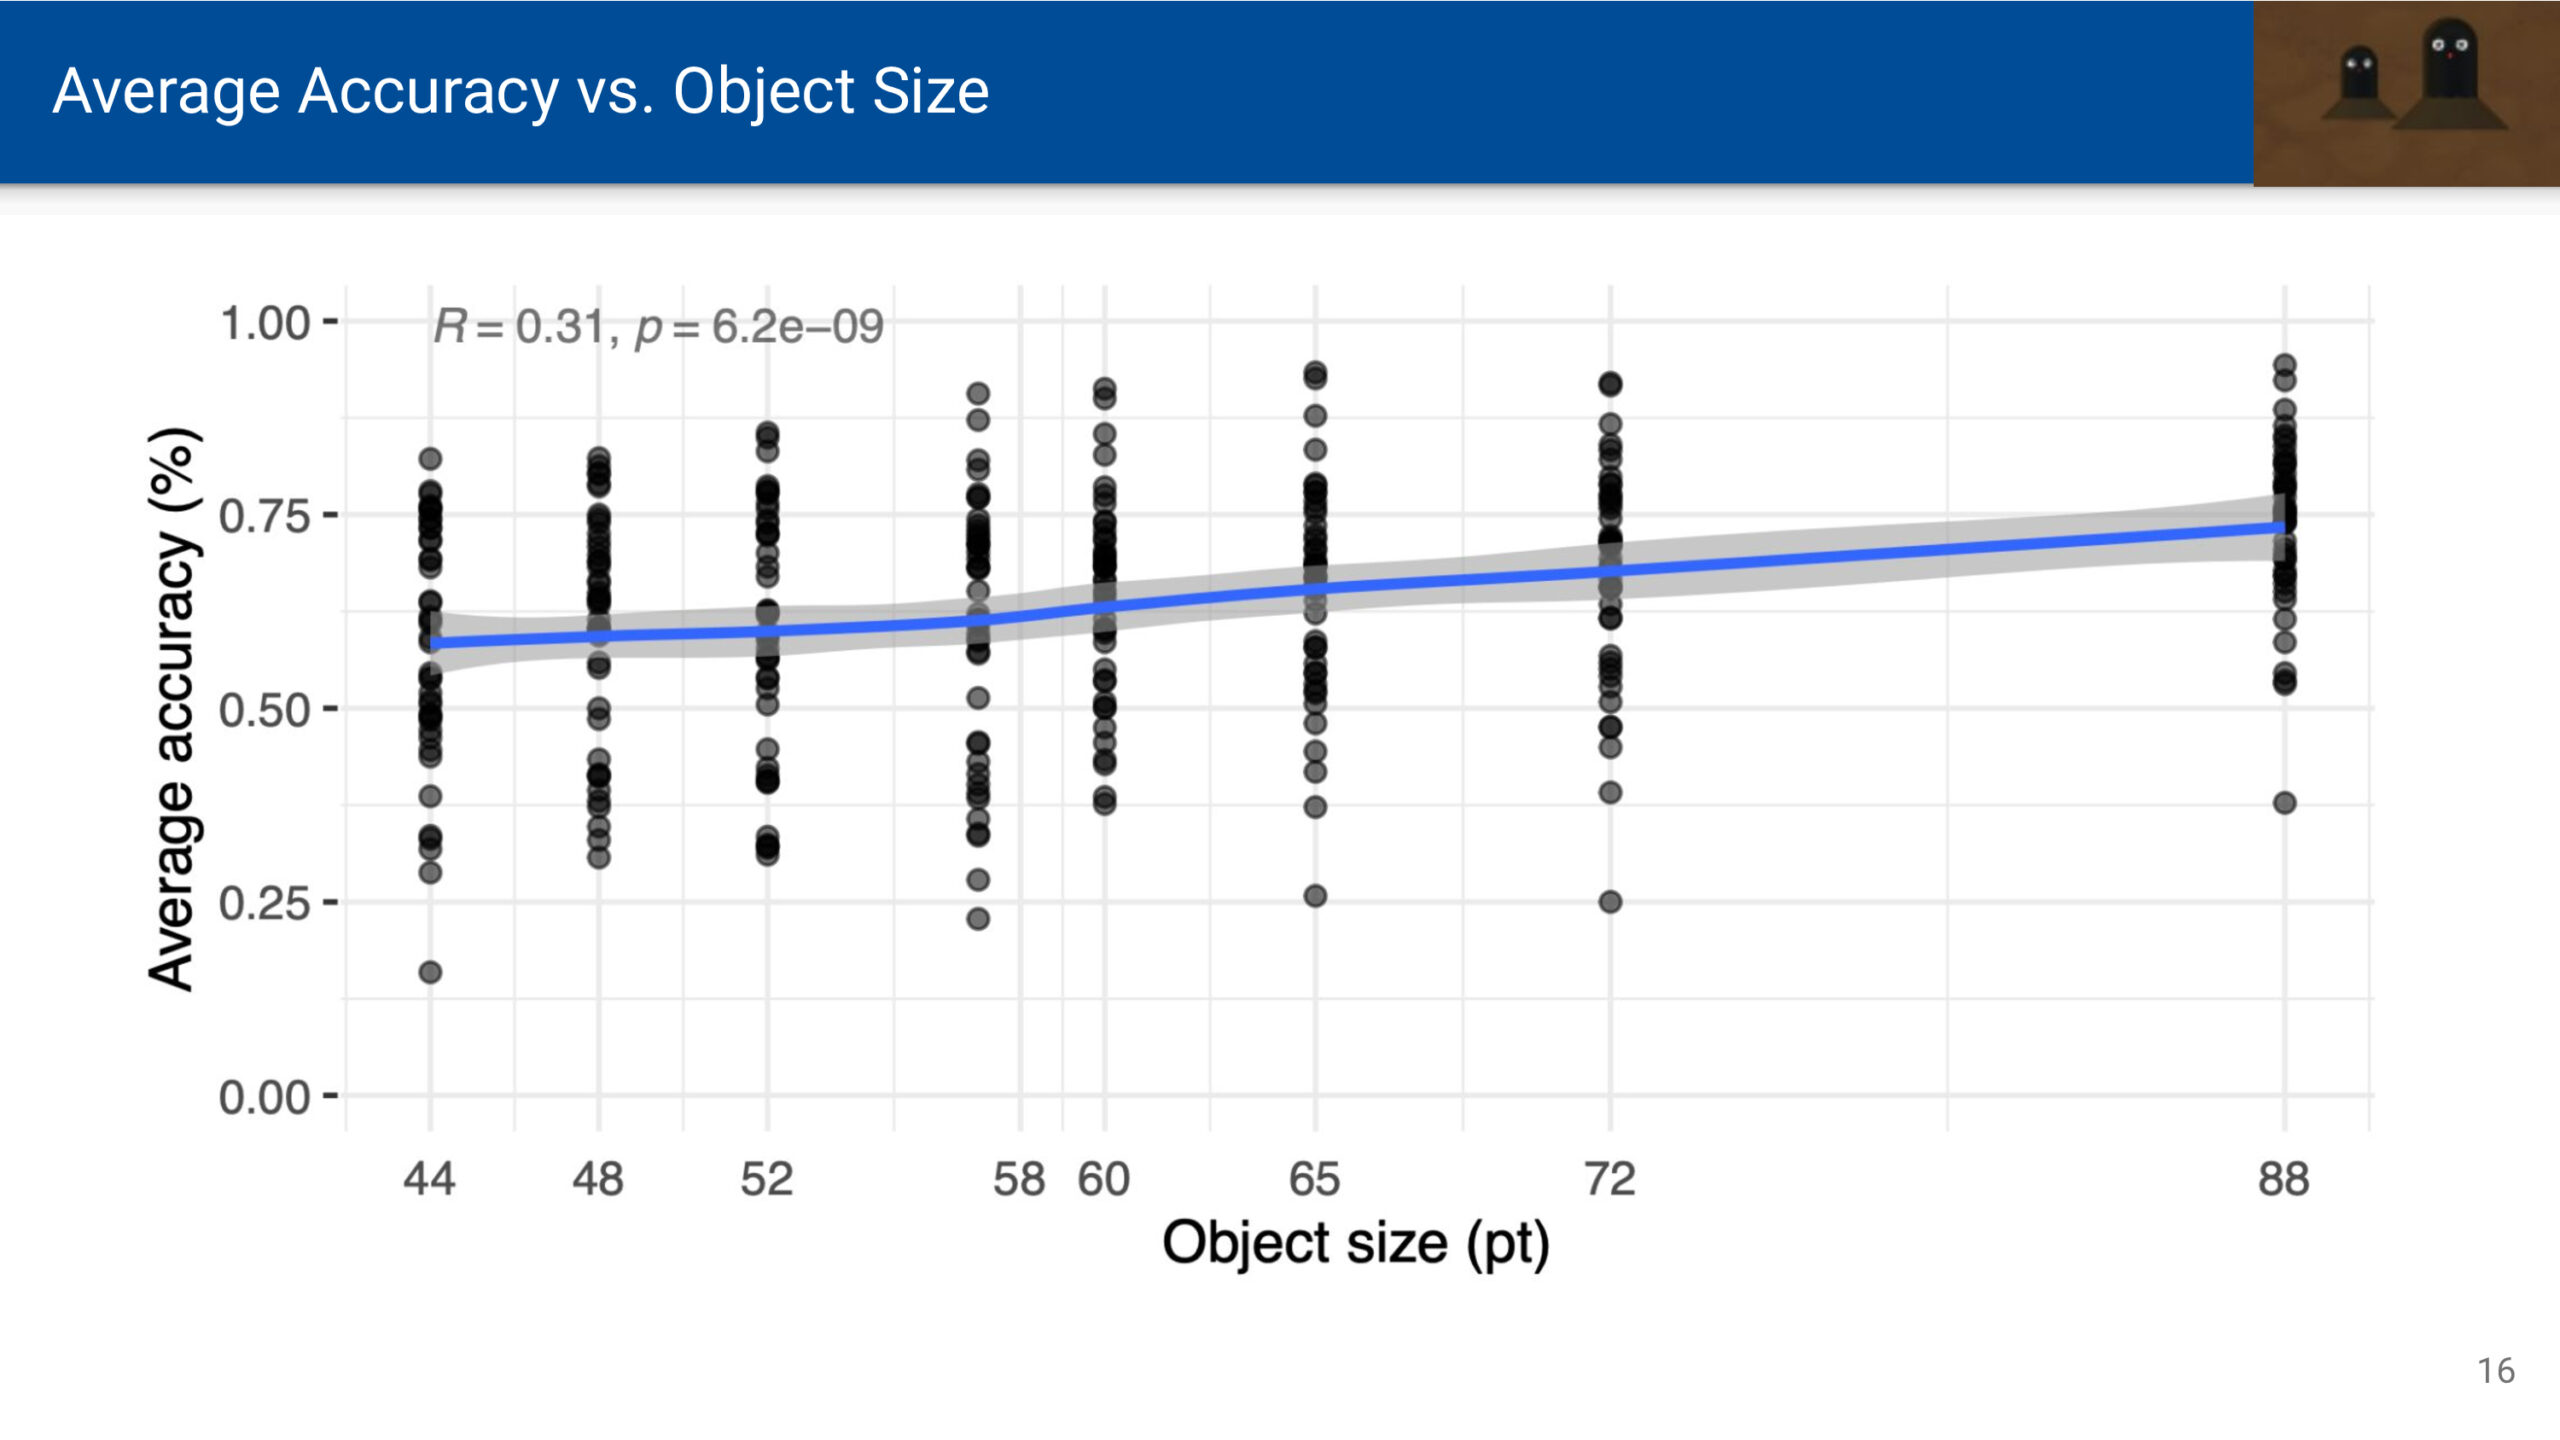
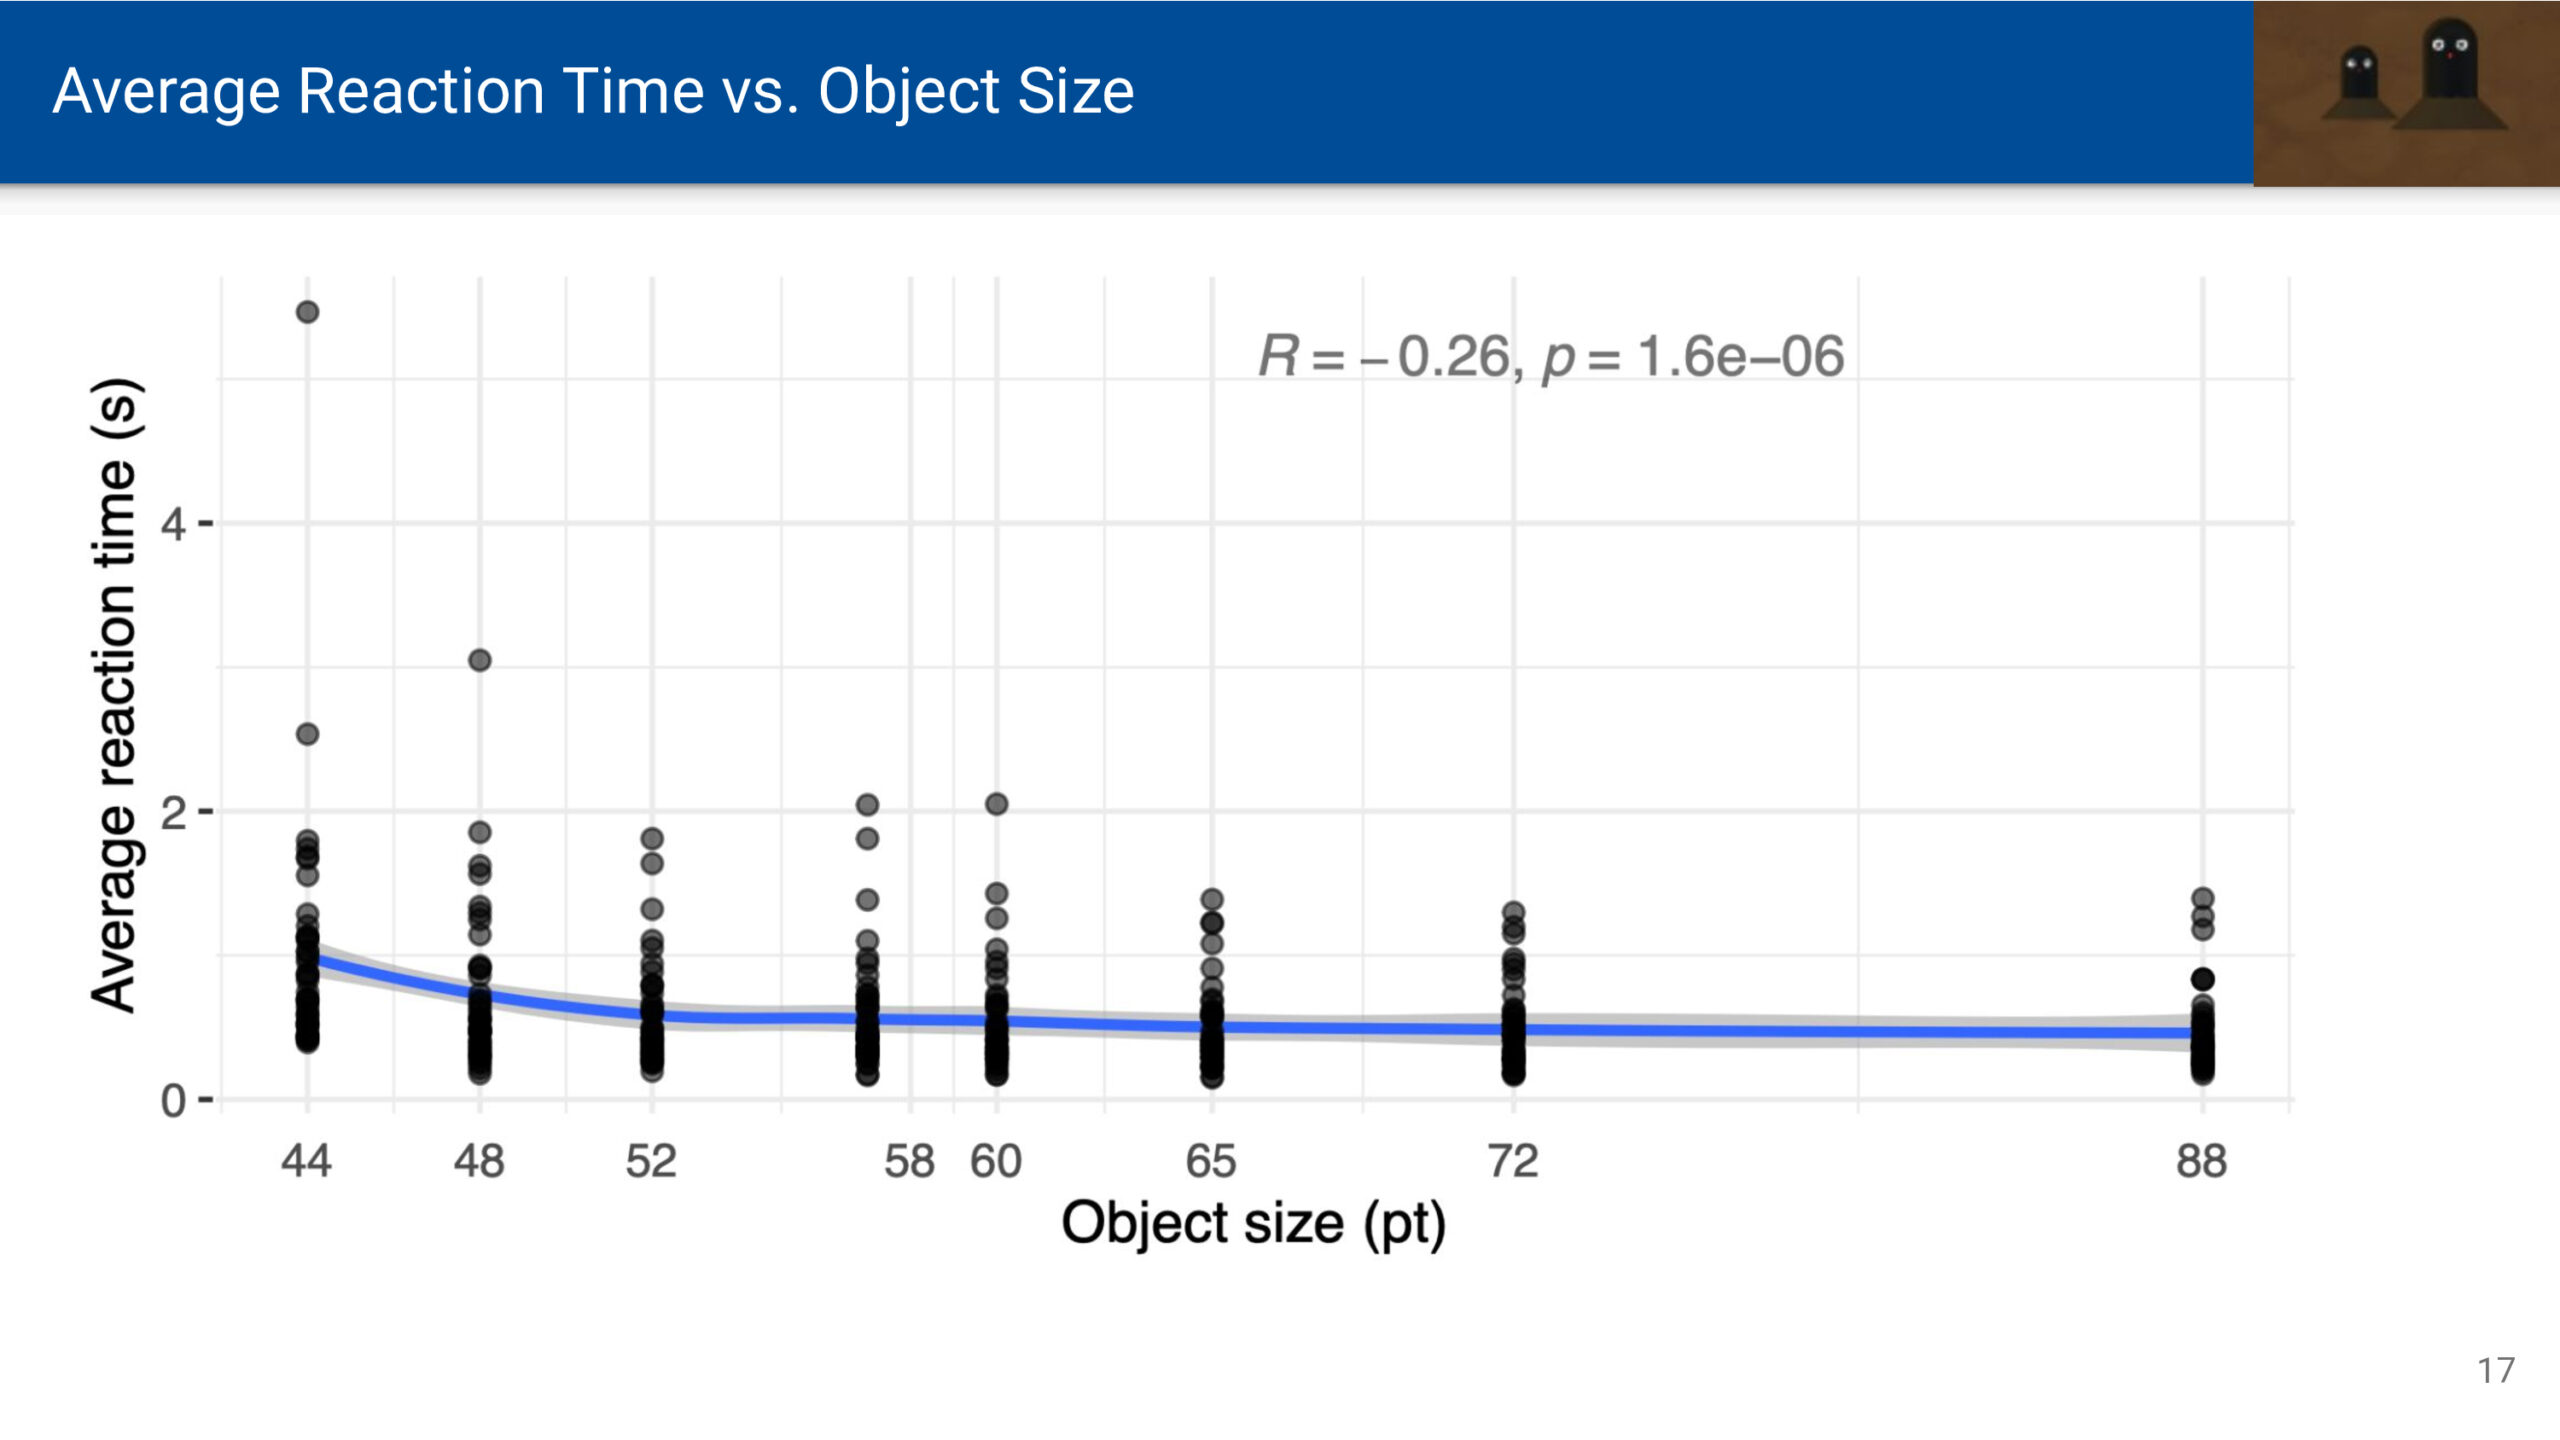
Talk 3: Game-Based Ergonomic Adaptation of User Interfaces for Online Learning Environments (Niels Seidel)